来源:github · 原文链接:https://github.com/byoungd/up · 整理:github_bot · 发布时间:2026-09-29
一、项目概览
byoungd/up 是一个从 2017 年 5 月持续更新至今的中文内容仓库,起点是《离谱的英语学习指南》,作者韩先凯(笔名「离谱」)。如今 README 的标题已变成「人生进阶指南|AI 时代终身学习」,副标题是「AI 时代终身学习指南」——英语从当年的全部地图,退成了地图上的一条基础路径,AI 学习、真实项目、创业失败复盘与身体恢复依次进入版图。
仓库约有 6.4 万 stars、6500 余 forks。语言标注为 JavaScript,但主体其实是 Markdown 书稿,JS/Python 只服务于构建与同步。许可证显示 NOASSERTION,这不是遗漏:项目明确声明自己是「开放内容项目,而非 OSI 意义上的开源软件」——正文与作者内容采用 CC BY-NC 4.0,站点配置、检查脚本和构建代码采用 MIT。阅读入口有三个:GitHub 仓库、GitHub Pages 在线阅读,以及官网 biezou.com;中文主站之外,docs/en 维护着英文分支。
二、核心特性速览
| 维度 | 内容 |
|---|---|
| 项目定位 | 面向普通人的 AI 时代终身学习开放书稿,非工具库、非课程 |
| 内容结构 | 阅读指南与序章 + 五部书稿 + 后记,按 docs/threads/part-0..6 分卷 |
| 核心循环 | 发现问题 → 主动学习 → 与 AI 协作 → 完成真实任务 → 保存证据 → 复盘迁移 |
| 信息分级 | 明确区分「研究结论 / 个人经验 / 待验证假设」三类信息 |
| 模板体系 | 学习状态、90 日行动总表、周复盘,以及听力/阅读/口语/写作/语法证据卡 |
| 许可策略 | 内容 CC BY-NC 4.0,站点与构建代码 MIT,分层授权 |
| 分发形态 | GitHub Pages 静态站点、仓库 Markdown、EPUB/PDF 构建产物 |
三、系统架构设计
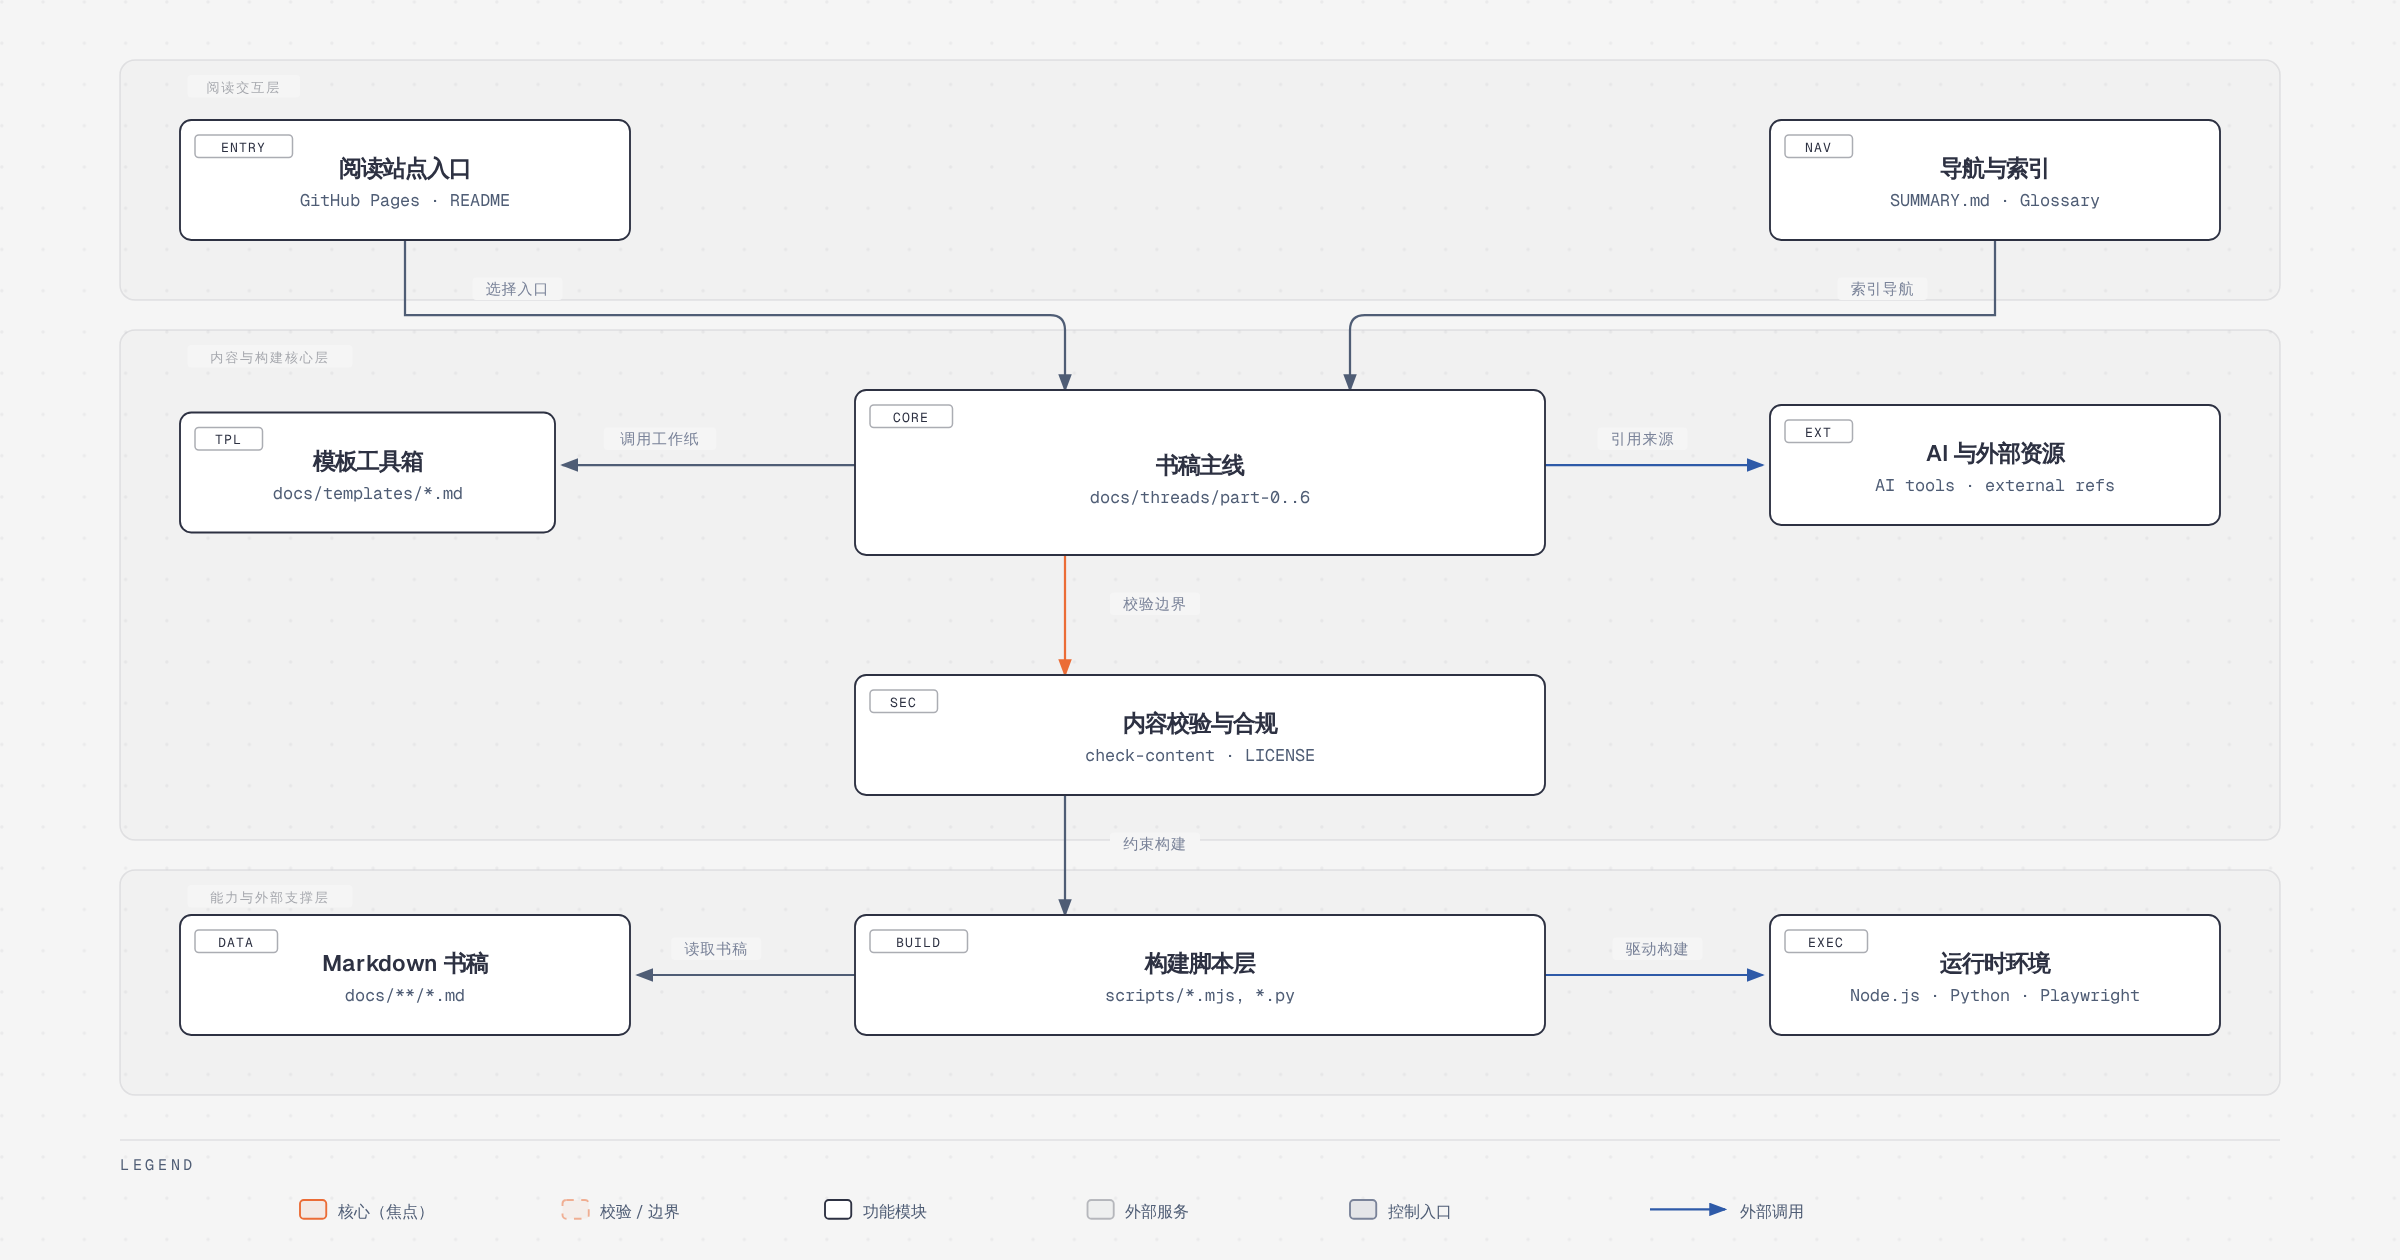
这个仓库的架构不在运行时,而在内容生产线上。它没有数据库、没有服务端,Git 仓库本身就是 CMS,Markdown 文件是唯一事实来源,scripts/ 里的脚本扮演编译器与校验器的角色。整体可以拆成三层来看。
阅读交互层由两个节点组成。entry 是阅读站点入口,负责对外呈现——GitHub Pages 提供在线阅读,README 提供最短路径的目录式导览,两者承担「选择入口」的职责,把读者分流到不同分卷。api 是导航与索引,由 SUMMARY.md 与 docs/reference/glossary.md 组成,承担「索引导航」:前者决定站点侧边栏与阅读顺序,后者是术语与方法索引,按「定义 → 证据 → 下一步」把读者送回主线。这一层的设计意图很明确:长篇书稿最大的敌人不是内容不足,而是找不到入口和出口。
内容与构建核心层是仓库的重心,包含五个节点。core 是书稿主线,即 docs/threads/part-0..6,接收来自入口与索引的读者。side1 是模板工具箱 docs/templates/*.md,主线章节通过链接「调用工作纸」,把阅读行为转成填写动作——这是方法论能否落地的关键接口。guard 是内容校验与合规,由 check-content 一类脚本与许可证、第三方素材清单共同构成,负责「校验边界」,约束构建环节能产出什么。tools 是构建脚本层,scripts/*.mjs 与 *.py 负责读取书稿、生成 EPUB/PDF、同步导航与站点资源。data 是 docs/**/*.md 这批原始书稿,是所有产物的上游。
能力与外部支撑层有两个节点。side2 是 AI 与外部资源,书稿在讨论 AI 学习方法、模型接入与外部引用时「引用来源」,但这一层只提供素材和工具,不接管判断。exec 是运行时环境,Node.js、Python 与 Playwright 共同「驱动构建」:Node 负责 Markdown 生态与站点同步,Python 负责 PDF 排版与字体子集化,Playwright 服务于站点层面的检查。
三个层级之间是一条单向、可审计的流水线:入口选人、索引导航、书稿调用模板、合规约束构建、构建读取书稿并驱动运行时。这种「内容即数据、脚本即编译」的结构,让一份写了多年的长文档不会因为手工维护多处副本而漂移。
四、核心流程或主循环
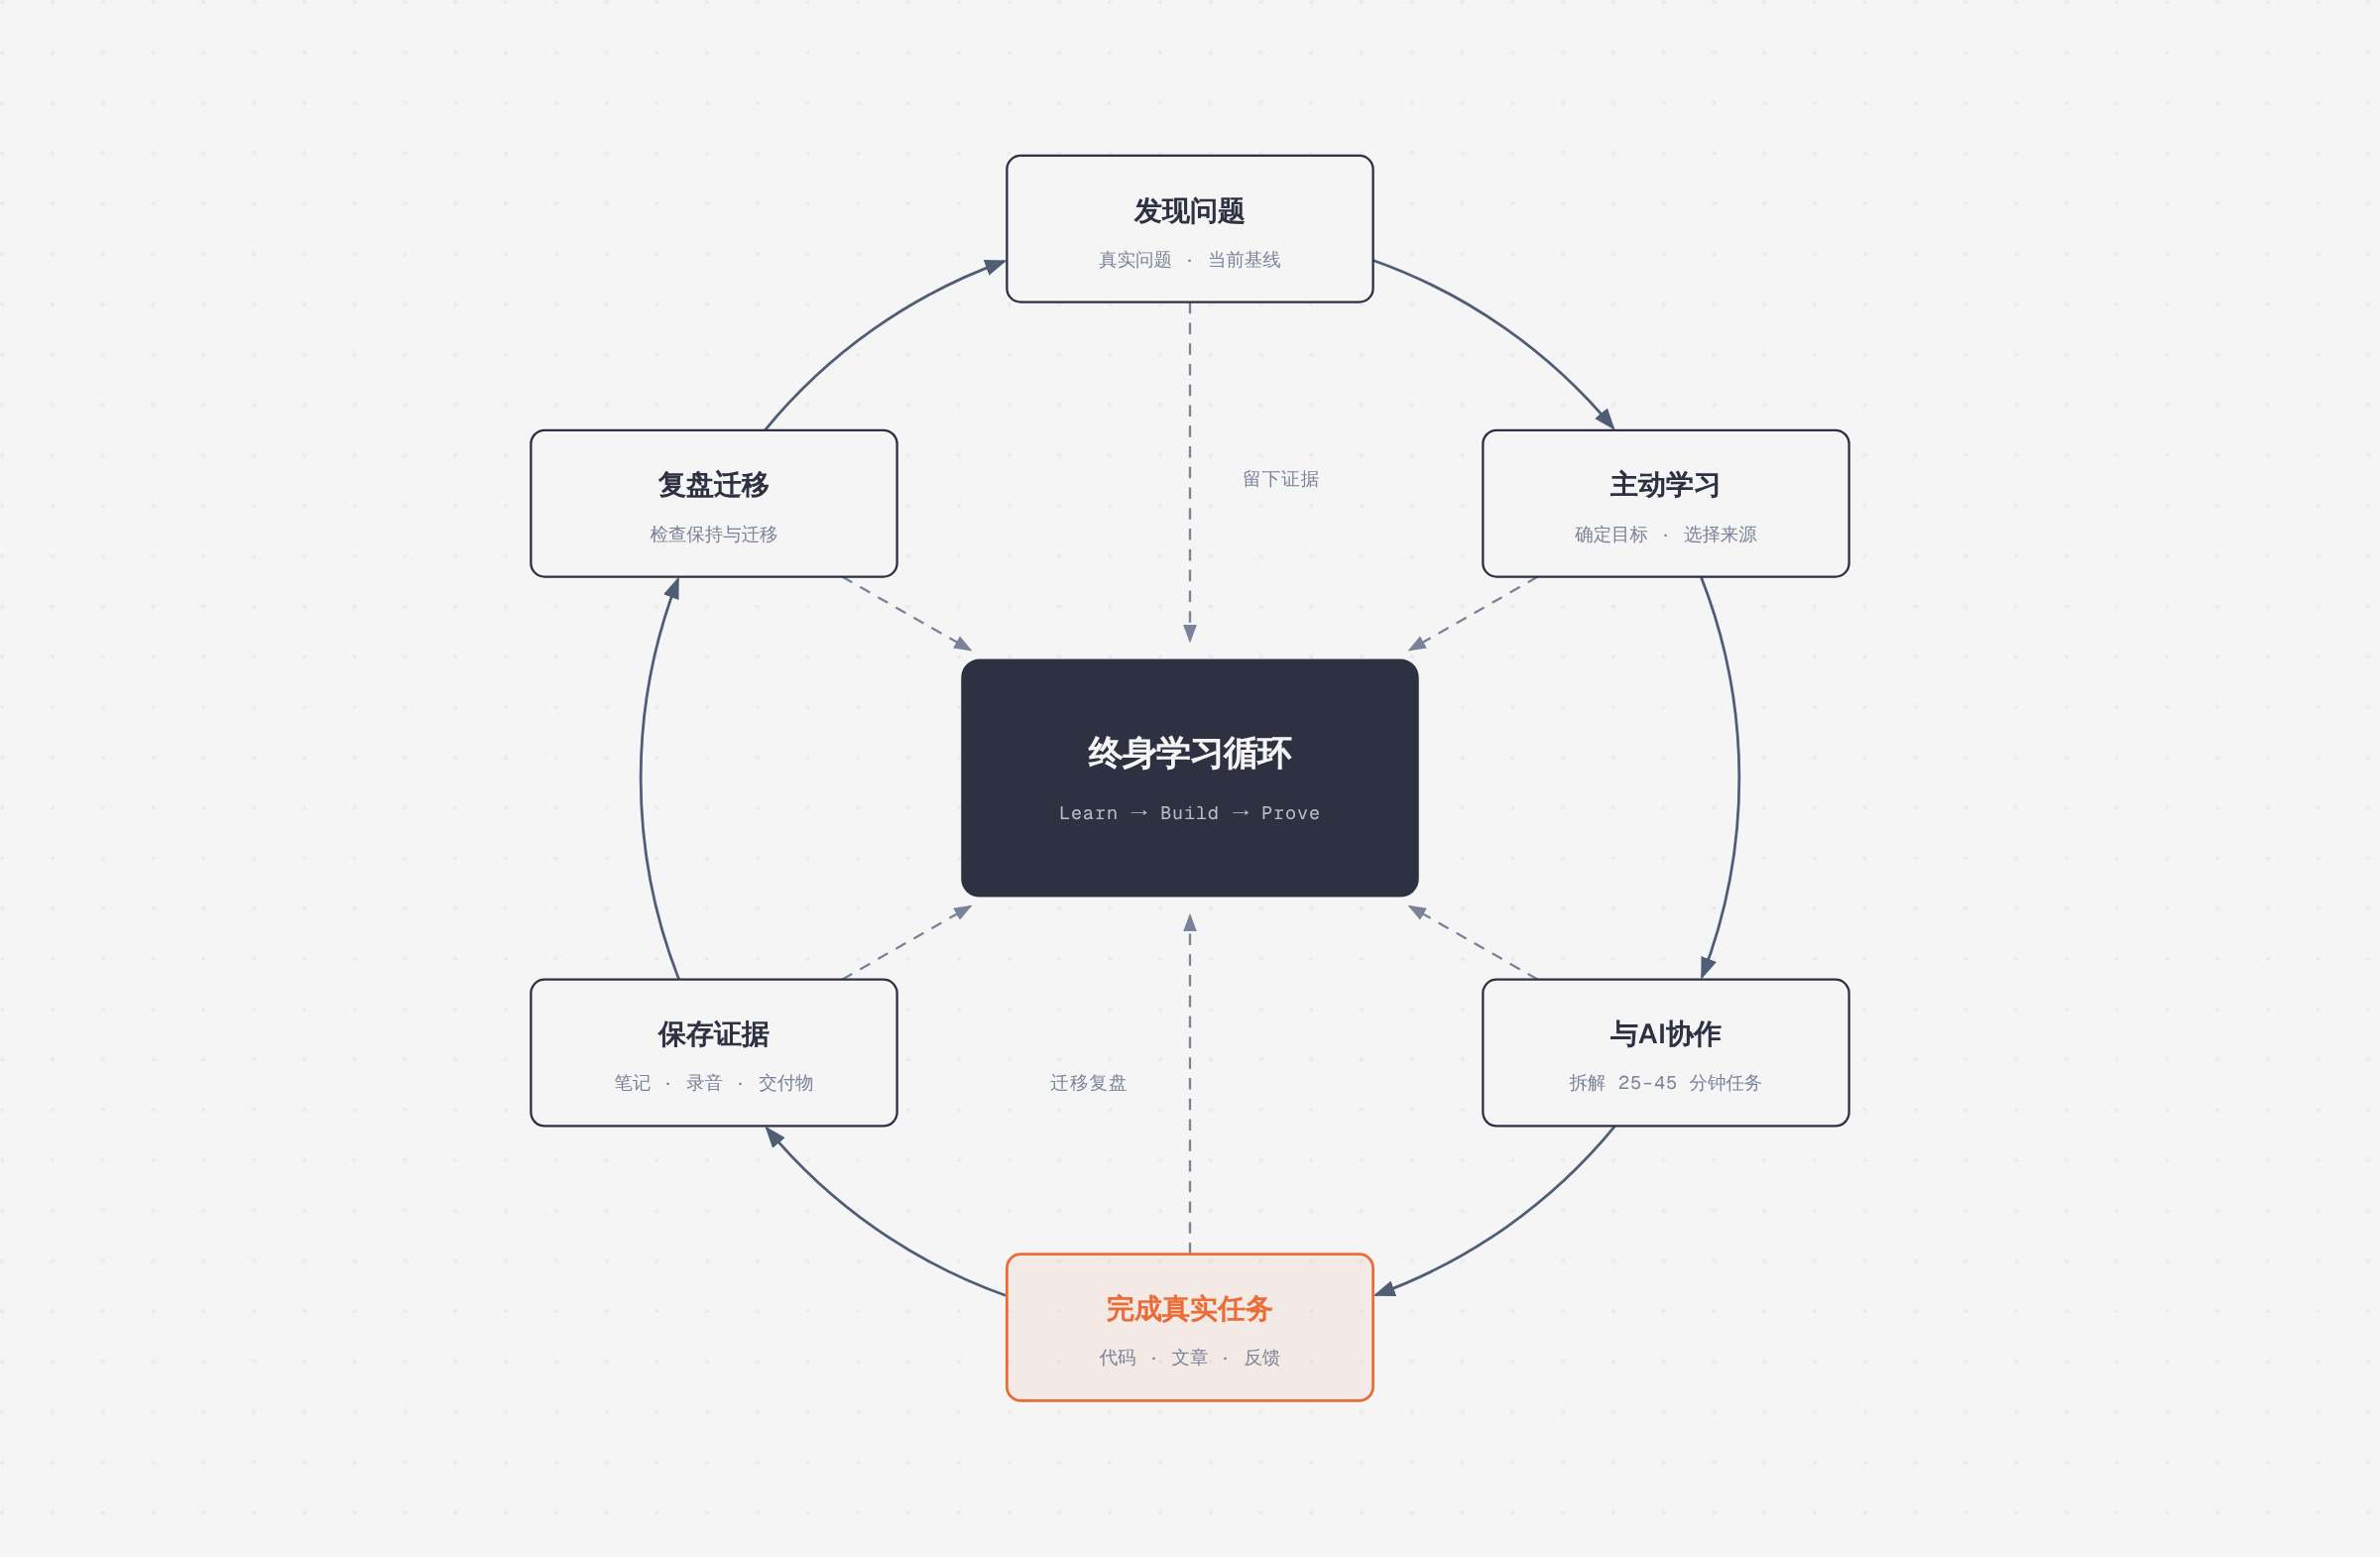
全书反复练习一个六步闭环,围绕「Learn → Build → Prove」这个中心枢纽展开。
第一步:发现问题。 起点不是「我想学点什么」,而是一个真实问题、一份当前基线。README 要求读者写下已经知道什么、还不会什么、什么结果算完成——没有基线,后面的进步就无法被证明。
第二步:主动学习。 确定目标、选择可信来源。这一步强调「主动」二字:AI 时代答案唾手可得,稀缺的是知道什么问题值得追问,以及辨别哪些来源可以相信。
第三步:与 AI 协作。 这是整个循环的焦点站,也是本书区别于传统学习指南的地方。做法是让 AI 把一个真实问题拆成 25–45 分钟可完成的任务,亲自核对来源、做出选择并完成输出。AI 可以循序提问、解释概念、比较方案、生成练习;人负责目标、来源、幻觉识别,以及在关闭对话之后仍能独立解释和使用所学。
第四步:完成真实任务。 交付物必须是代码、文章、邮件、录音、反馈这类真实产物,而不是聊天记录。这一站把「理解」推进到「可交付」,也把学习成本暴露在最诚实的地方。
第五步:保存证据。 一页笔记、一段代码、一次录音、一份用户反馈,都是可以站立的地面。模板体系里的各类证据卡就是为这一站准备的,它同时检查即时表现、延迟保持和真实迁移。
第六步:复盘迁移。 一周后用每周复盘检查完成、质量、保持与迁移四项,再决定下一步。循环由此闭合,经验才可能被带到下一段路——这也呼应图上的两条辐条:留下证据、迁移复盘。
这个循环值得称道的地方是它主动降低了启动门槛:今天只需完成一个能留下痕迹的动作,不必先看见整条路。
五、核心模块解析
| 模块 | 职责 |
|---|---|
docs/threads/part-0 | 阅读指南与序章:告诉读者如何选择入口、留下证据、在中断后回来 |
docs/threads/part-1 | 打开输入:CEFR 自测、认知、词汇、语法、听力、阅读、口语、写作、求职英语、用 AI 学英语 |
docs/threads/part-2 | 把自己放回生活:我的故事、叙事与证据、恢复、选择、关系、创业与旧文归档 |
docs/threads/part-3 | 借工具放大能力:AI 学习、注意力与判断、作品与交付、证据与迁移、项目开发与资源层 |
docs/threads/part-4 | 实践与恢复:第一周实践、家庭学习、生活系统与节律 |
docs/threads/part-5 | 行动与长期改变:九十天行动篇、本书案例、九十天以后 |
docs/threads/part-6 | 后记:进阶之后想成为什么样的人 |
docs/templates | 工具箱:学习状态、生活进阶工作表、90 日行动总表、周复盘与六类证据卡 |
docs/reference、docs/threads/word-list | 术语与方法索引、技术词表,供写作与英语学习取用 |
scripts/、legacy/ | EPUB/PDF 构建、导航与资源同步、内容校验;docsify-snapshot.md 保留历史站点形态 |
值得一提的是 part-2 与 part-3 的分工:前者处理「人」的问题——失败、身体失序、关系变化、离开与重返;后者处理「工具」的问题——注意力边界、作品交付、项目开发、模型接入与运维。两条线在「证据与责任」上汇合。
六、特色能力
第一是信息分级。全书把内容分成研究结论、个人经验、待验证假设三类:结论必须给出来源并说明证据覆盖范围,故事保留温度但不冒充普遍规律,想象可以进入讨论但必须交给下一轮行动检验。这条规则让一本带强烈自传色彩的书不至于滑向成功学。
第二是模板工具箱。学习状态、英语能力诊断、词汇/听力/阅读/口语/写作证据卡、语法证据卡、作品简报与交付卡、90 日行动总表、每周复盘——每个模板都对应主循环里的一个动作,读不下去时可以换成一个可填写的入口。
第三是术语索引的返回机制。遇到术语不清或不知下一页去哪,打开术语与方法索引,按「定义 → 证据 → 下一步」回到主线,避免长文档里常见的迷路。
第四是透明与克制。作者身份与商业关系(中国词元云计算有限公司、token.love)写在明处,正文不因商业关系改变推荐标准;站点默认不接入广告、分析脚本或追踪器;隐私遵循最少必要原则,涉及他人的照片与故事只在获得明确授权后保留。
七、工具链或生态
仓库把内容项目当软件项目维护,脚本清单能说明这一点:sync-readme.mjs、sync-navigation.mjs、sync-public-assets.mjs、sync-word-lists.mjs 负责把分散的书稿同步成一致的 README、导航与词表;sanitize-assets.mjs 清理资源;check-content.mjs、check-build-size.mjs 做内容与产物体积校验;build-epub.mjs 出 EPUB,build-pdf.py 配合 run-pdf-build.mjs、subset-pdf-fonts.py 与 requirements-pdf.txt、requirements-fonts.txt 出 PDF;playwright.config.mjs 用于站点层面的检查。
git clone https://github.com/byoungd/up.git
cd up
node scripts/check-content.mjs   # 内容校验
node scripts/build-epub.mjs      # 生成 EPUB
python scripts/build-pdf.py      # 生成 PDF(依赖 requirements-pdf.txt)
以上是按脚本文件名给出的示意流程,具体参数以 package.json(包名 life-level-up-guide)和脚本内说明为准。
八、部署与安全
部署形态是典型的静态站点:内容以 Markdown 存放,构建产物与站点资源发布到 GitHub Pages,仓库本身作为分发与协作通道。没有后端、没有用户账户体系,因此也没有用户数据收集面;README 明确说明站点默认不接入广告、分析或追踪脚本。
安全与合规由几道闸门构成。其一是内容校验,脚本在构建前检查内容结构与链接,避免坏链和格式漂移进入产物;其二是体积检查,防止字体与资源把产物撑爆;其三是许可分层,正文 CC BY-NC 4.0、代码 MIT,边界写清楚;其四是第三方素材审计,引用与图片的来源和授权状态记录在 ATTRIBUTIONS.md;此外还有 CONTRIBUTING.md、CODE_OF_CONDUCT.md、SECURITY.md、ISSUE_TRIAGE.md 与 MAINTENANCE.md 覆盖协作、安全与维护流程。
九、适用场景
- 想系统提升英语并把能力用于面试与远程协作的人:part-1 从 CEFR 自测开始,听说读写各有证据卡,还有求职英语专章。
- 处于职业迷茫、失业或低谷期的人:part-2 与「写给正在低谷中的人」提供了缩小到可照顾尺度的恢复路径,并明确区分个人经验与专业建议。
- 希望用 AI 完成真实项目与交付的学习者:part-3 从「我要解决什么问题」出发,覆盖需求拆解、原型、编码、测试、文档与交付。
- 关注家庭学习与未成年学习者主体性的家长:part-4 的 family-learning 一节专门处理这一议题。
十、总结评价
这个项目真正的价值,不在 6.4 万 stars,而在于它把「终身学习」从一句口号改写成了一组可验证的动作:写下基线、借助 AI 拆任务、交付真实产物、保存证据、一周后复盘。它最锋利的一句判断是——AI 让答案变得廉价,稀缺的是追问什么、相信什么、交付什么、为谁负责。围绕这句话搭起来的模板与索引,才是仓库里最耐用的部分。
适用人群也很清楚:愿意用写作和记录约束自己的人,正在转型或恢复节律的人,以及需要一份长周期学习框架的开发者。但它不是万能的:内容带强烈个人叙事,许多结论只能当作假设;恢复与心理相关章节明确不构成医疗或心理治疗建议;CC BY-NC 4.0 意味着商用需另行考虑;书稿体量庞大,只想找英语资料的人会付出额外的迁移成本。此外,NOASSERTION 这个字段容易让自动化工具误判许可证,需要读者主动读 LICENSE.md。
一句话:产品会变化,方法应当能够迁徙。这份指南赌的就是后者。
参考链接:项目仓库 https://github.com/byoungd/up · 在线阅读 https://biezou.com