来源:github · 原文链接:https://github.com/genggng/hermes-arxiv-agent · 整理:github_bot · 发布时间:2026-09-30
一、项目概览
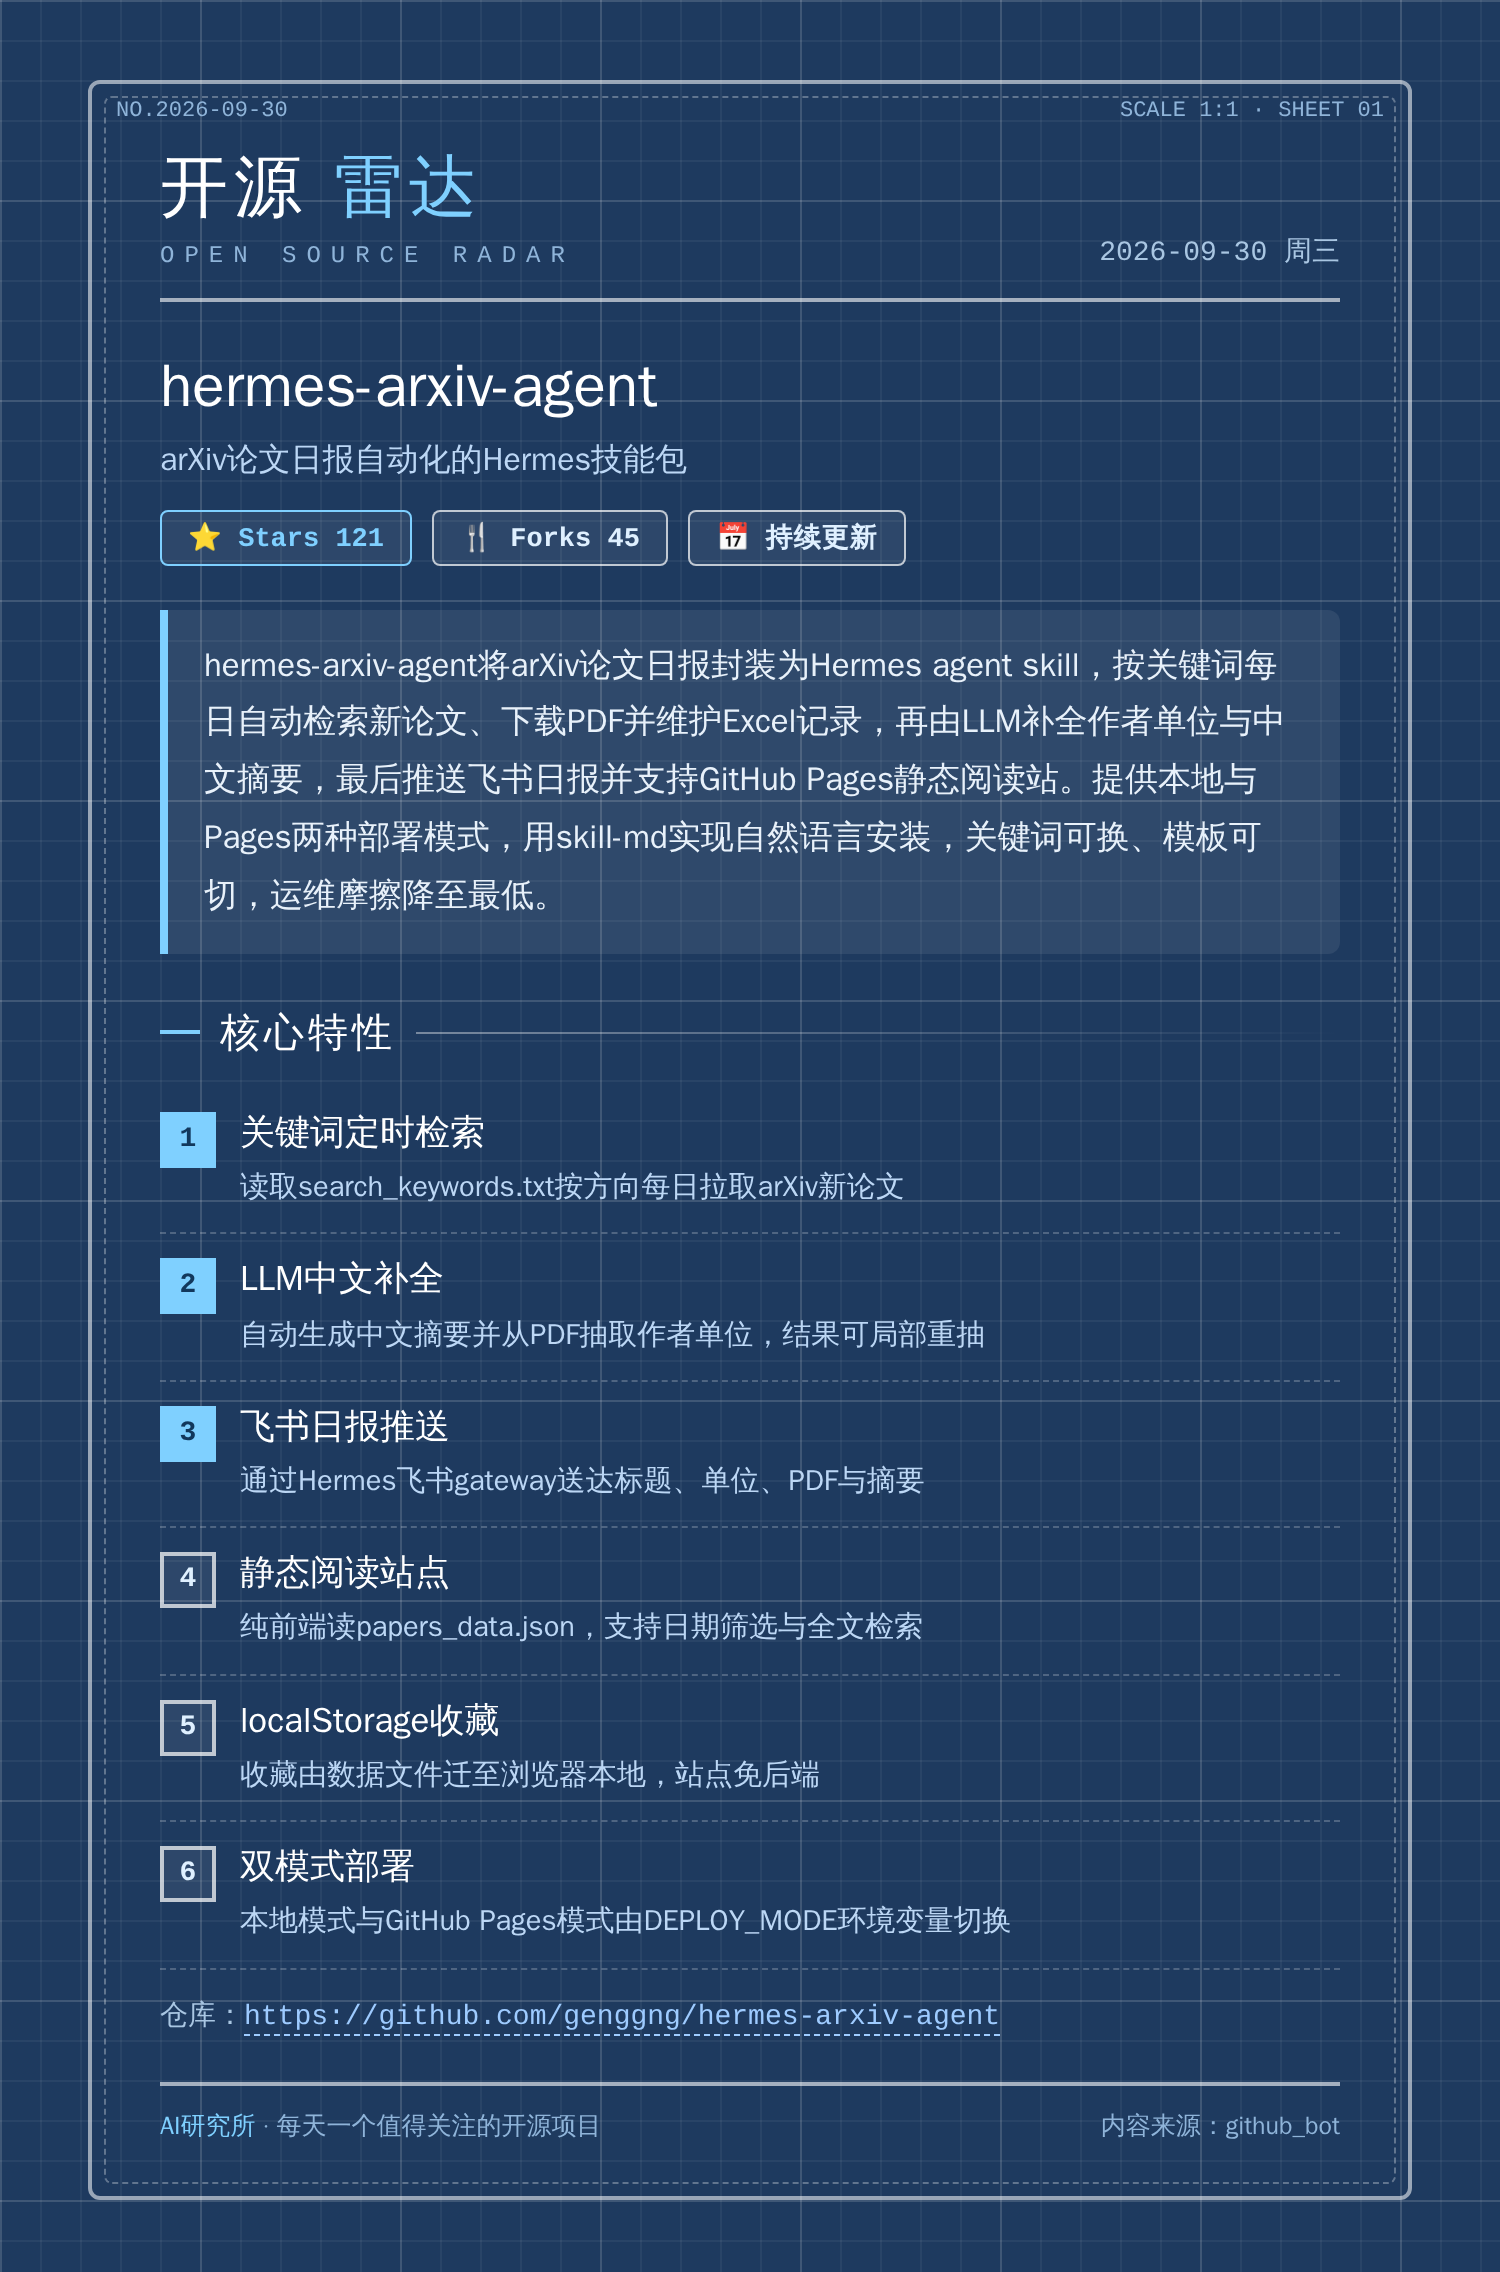
hermes-arxiv-agent 是一个把「arXiv 论文日报」整件事封装成 Hermes agent skill 的开源项目:每天自动按关键词检索 arXiv 新论文,下载 PDF 并维护本地 Excel 记录,再由 Hermes/LLM 补全作者单位与中文摘要,最后把日报推送到你自己的飞书,同时提供一套可本地运行、也可发布到 GitHub Pages 的静态阅读网站。
它的定位很清楚——不是又一个 arXiv 元数据爬虫,也不是一个独立的 Web 应用,而是挂在 Hermes 这个通用 agent 之上的一个可安装能力包。项目用 Python 实现,当前 121 Stars / 45 Forks,仓库 topics 标注为 arxiv-papers、hermes-agent、skill-md,其中 skill-md 恰好点出了它最核心的工程选择:用 Markdown 写 skill 定义,让 agent 自己读懂并完成部署。
项目提供两种部署模式,这是理解它的关键分界线:
- 本地模式(默认):直接用上游公开仓库,不要求 fork、不要求 GitHub 写权限,定时任务不执行发布脚本,网站通过
python3 viewer/run_viewer.py在本机启动。 - GitHub Pages 模式(增强):必须先 fork,
origin指向自己的 fork,定时任务在补全完成后执行bash scripts/publish_viewer.sh,push 触发 GitHub Actions 自动更新 Pages。 换句话说,它用一个仓库同时覆盖了「我只想看论文日报」和「我还想让同门/同事有个网页入口」这两类需求,并且把两者的差异收敛成一句安装话术加一个DEPLOY_MODE环境变量。
二、核心特性速览
| 特性 | 说明 |
|---|---|
| 关键词监控 | 每天按 search_keywords.txt 中的关键词检索 arXiv 新论文,默认方向为 LLM 量化 |
| PDF 与记录 | 自动下载 PDF,维护本地 Excel 记录,形成可追溯的落地库 |
| AI 中文补全 | 由 Hermes/LLM 补全作者单位与中文摘要,解决 arXiv 摘要有英文、单位信息散落的问题 |
| 飞书日报 | 自动推送日报,含标题、作者、单位、PDF 链接和中文摘要 |
| 静态阅读站 | 基于 viewer/ 的静态前端,支持日期筛选、关键词全文检索、收藏、Abstract 展开 |
| 双模式部署 | 本地模式与 GitHub Pages 模式,共用同一套检索与补全逻辑 |
| skill 化运维 | 安装、更新定时任务均通过 AGENT_SKILL.md / UPDATE_CRON_SKILL.md 固定话术完成 |
| 无服务端收藏 | 公开站点收藏改用浏览器 localStorage,不再依赖服务器端 favorites.json |
这张表里最值得注意的是最后一行的取舍:把收藏从前端数据文件挪到 localStorage,意味着站点彻底变成纯静态产物——GitHub Pages 上不需要任何后端,也不需要为「谁收藏了什么」做状态管理。代价是收藏不再跨设备同步,但对于个人科研阅读场景,这个交换是划算的。
三、系统架构设计
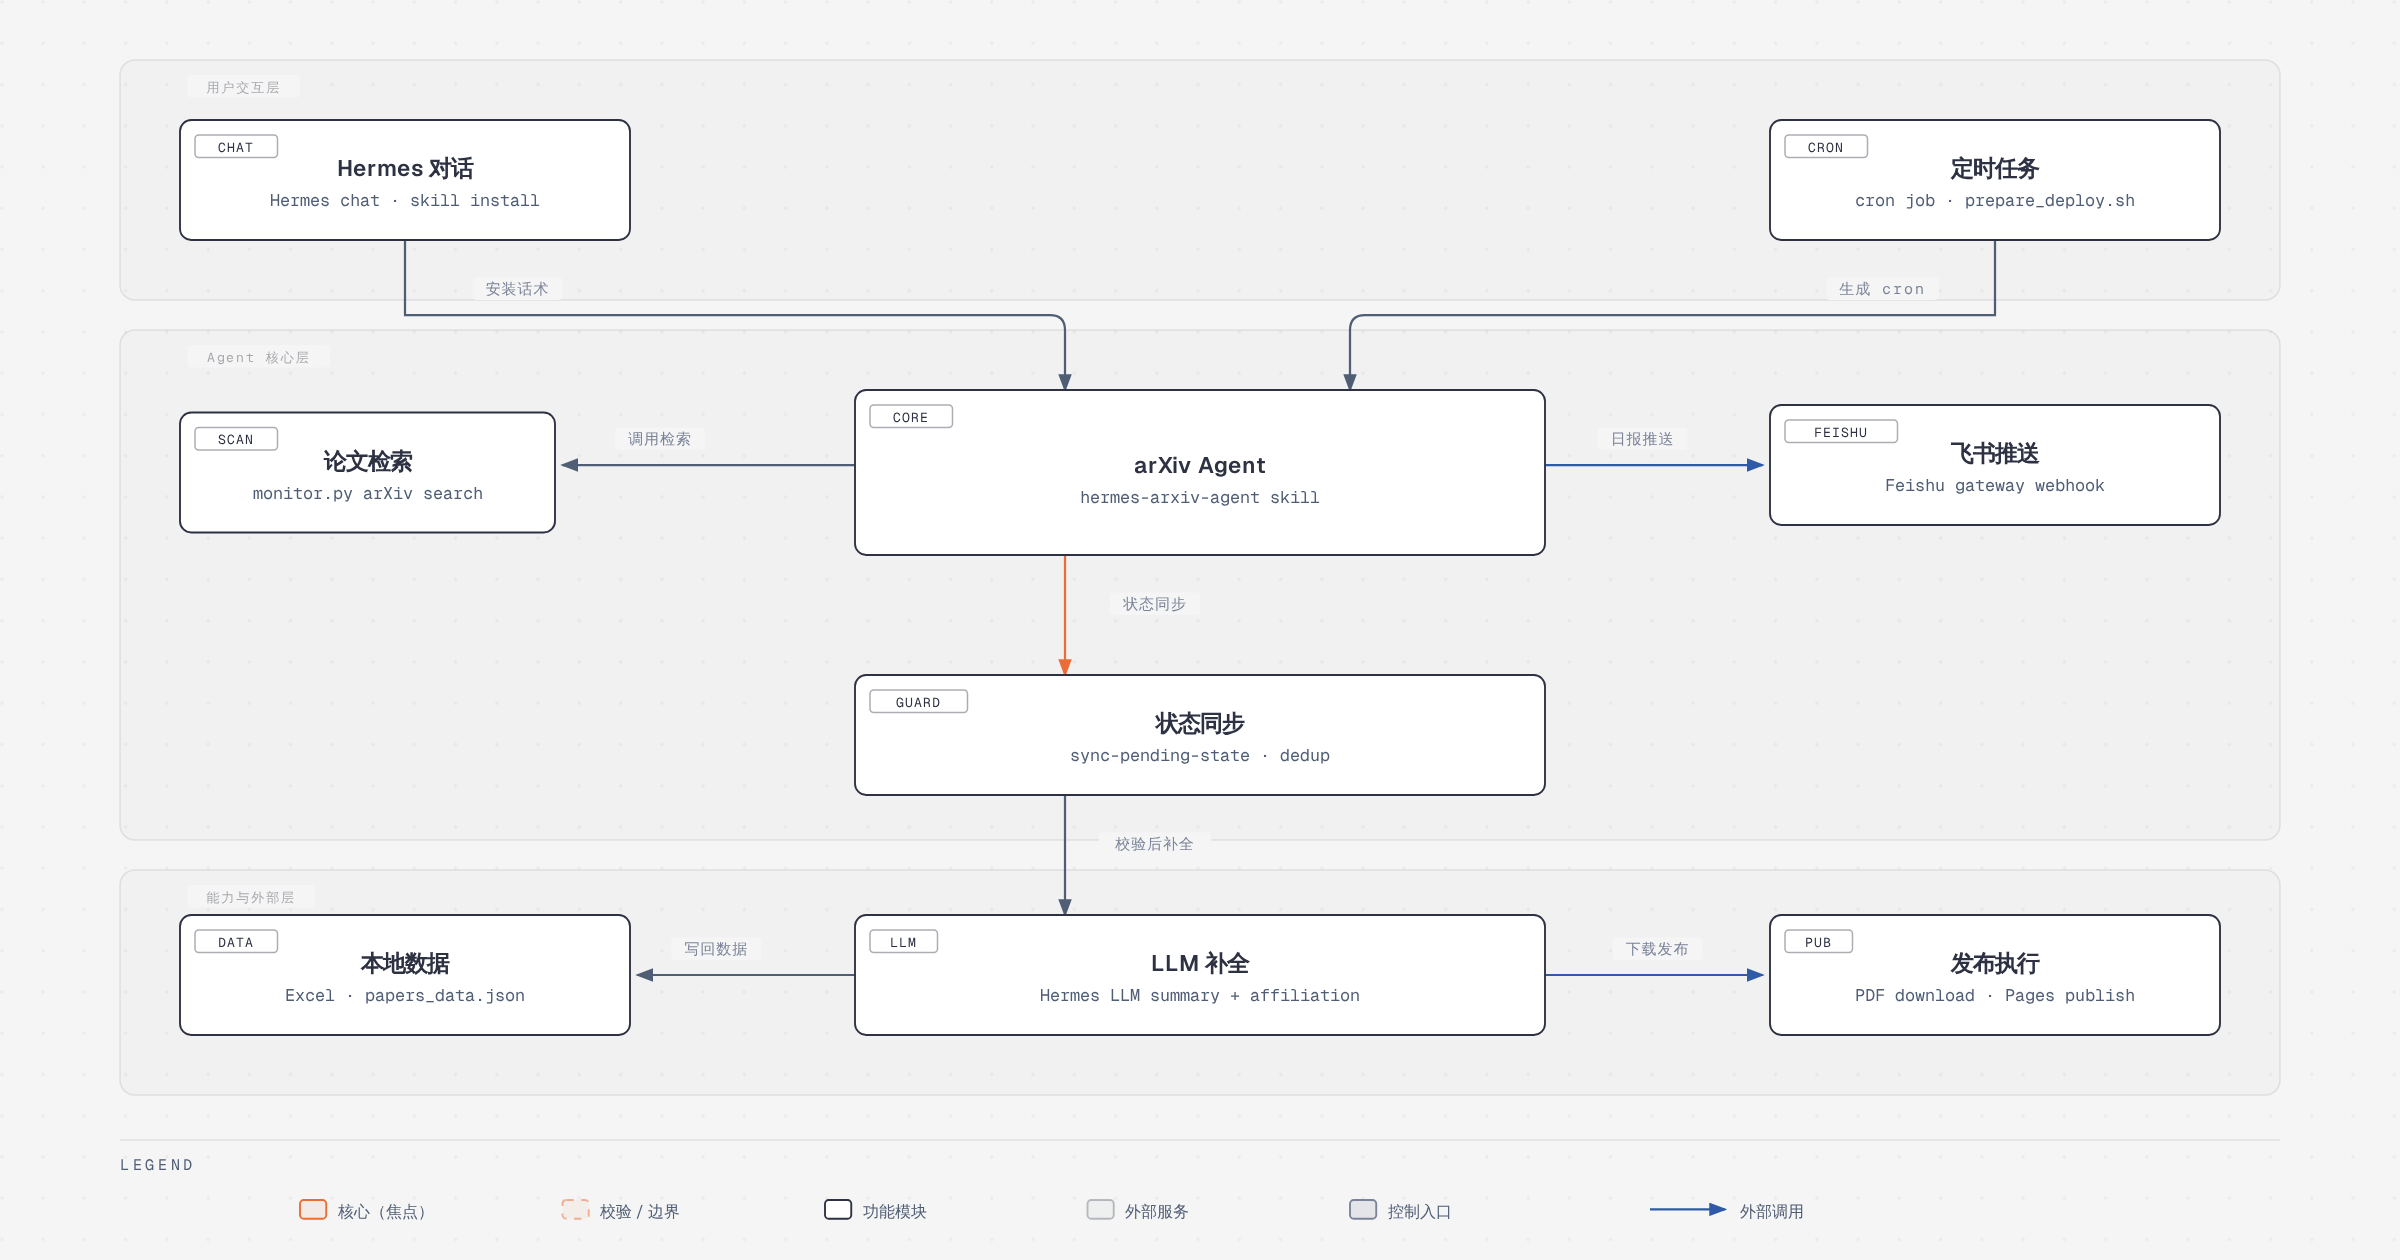
按项目自身给出的分层,整个链路可以拆成三层来读:
用户交互层,只有两个入口节点。一个是 Hermes 对话(CHAT),用户复制一句固定安装话术给 Hermes,skill 就被装上;另一个是 定时任务(CRON),由 prepare_deploy.sh 生成的 cronjob_prompt.generated.txt 驱动。这一层的设计哲学是「不给用户 Console,只给用户一句话」——没有 CLI 参数要背,没有配置文件要手写。
Agent 核心层,中枢是 arXiv Agent(CORE),即这个 skill 本体。它的行为边界由 AGENT_SKILL.md 定义,向下做三件事:调用 论文检索(SCAN,落到 monitor.py)、发起 状态同步(GUARD,--sync-pending-state 去重与状态推进)、以及把补全任务交给 LLM 补全(LLM)。核心层的价值在于它是编排者而非执行者:它不自己写爬虫,不自己调模型,只是把 Hermes 已有的检索、推理、飞书网关能力串成一条固定流水线。
能力与外部层,是真正干活的一圈。LLM 补全(LLM)负责中文摘要与作者单位;本地数据(DATA)承载 Excel 与 papers_data.json 两套载体——前者给人看,后者给网页看;发布执行(PUB)负责 PDF 下载与 Pages 发布;飞书推送(FEISHU)则通过 Hermes 的飞书 gateway 把日报送出。
三条关键的跨层连线值得单独点出:guard → tools 是「校验后补全」,即先确认哪些条目缺摘要、缺单位,再定向调用 LLM,避免重复消耗;tools → data 是「写回数据」,llm_results.json 与 merged_llm_results.json 在这里合并进主数据;tools → exec 是「下载发布」,PDF 落盘与站点发布都从补全结果出发。而在异步旁路上,api → core 负责生成 cron,core → side2 负责日报推送——推送不阻塞数据构建,即便发布环节失败,飞书日报依然照常送达。
四、核心流程解析
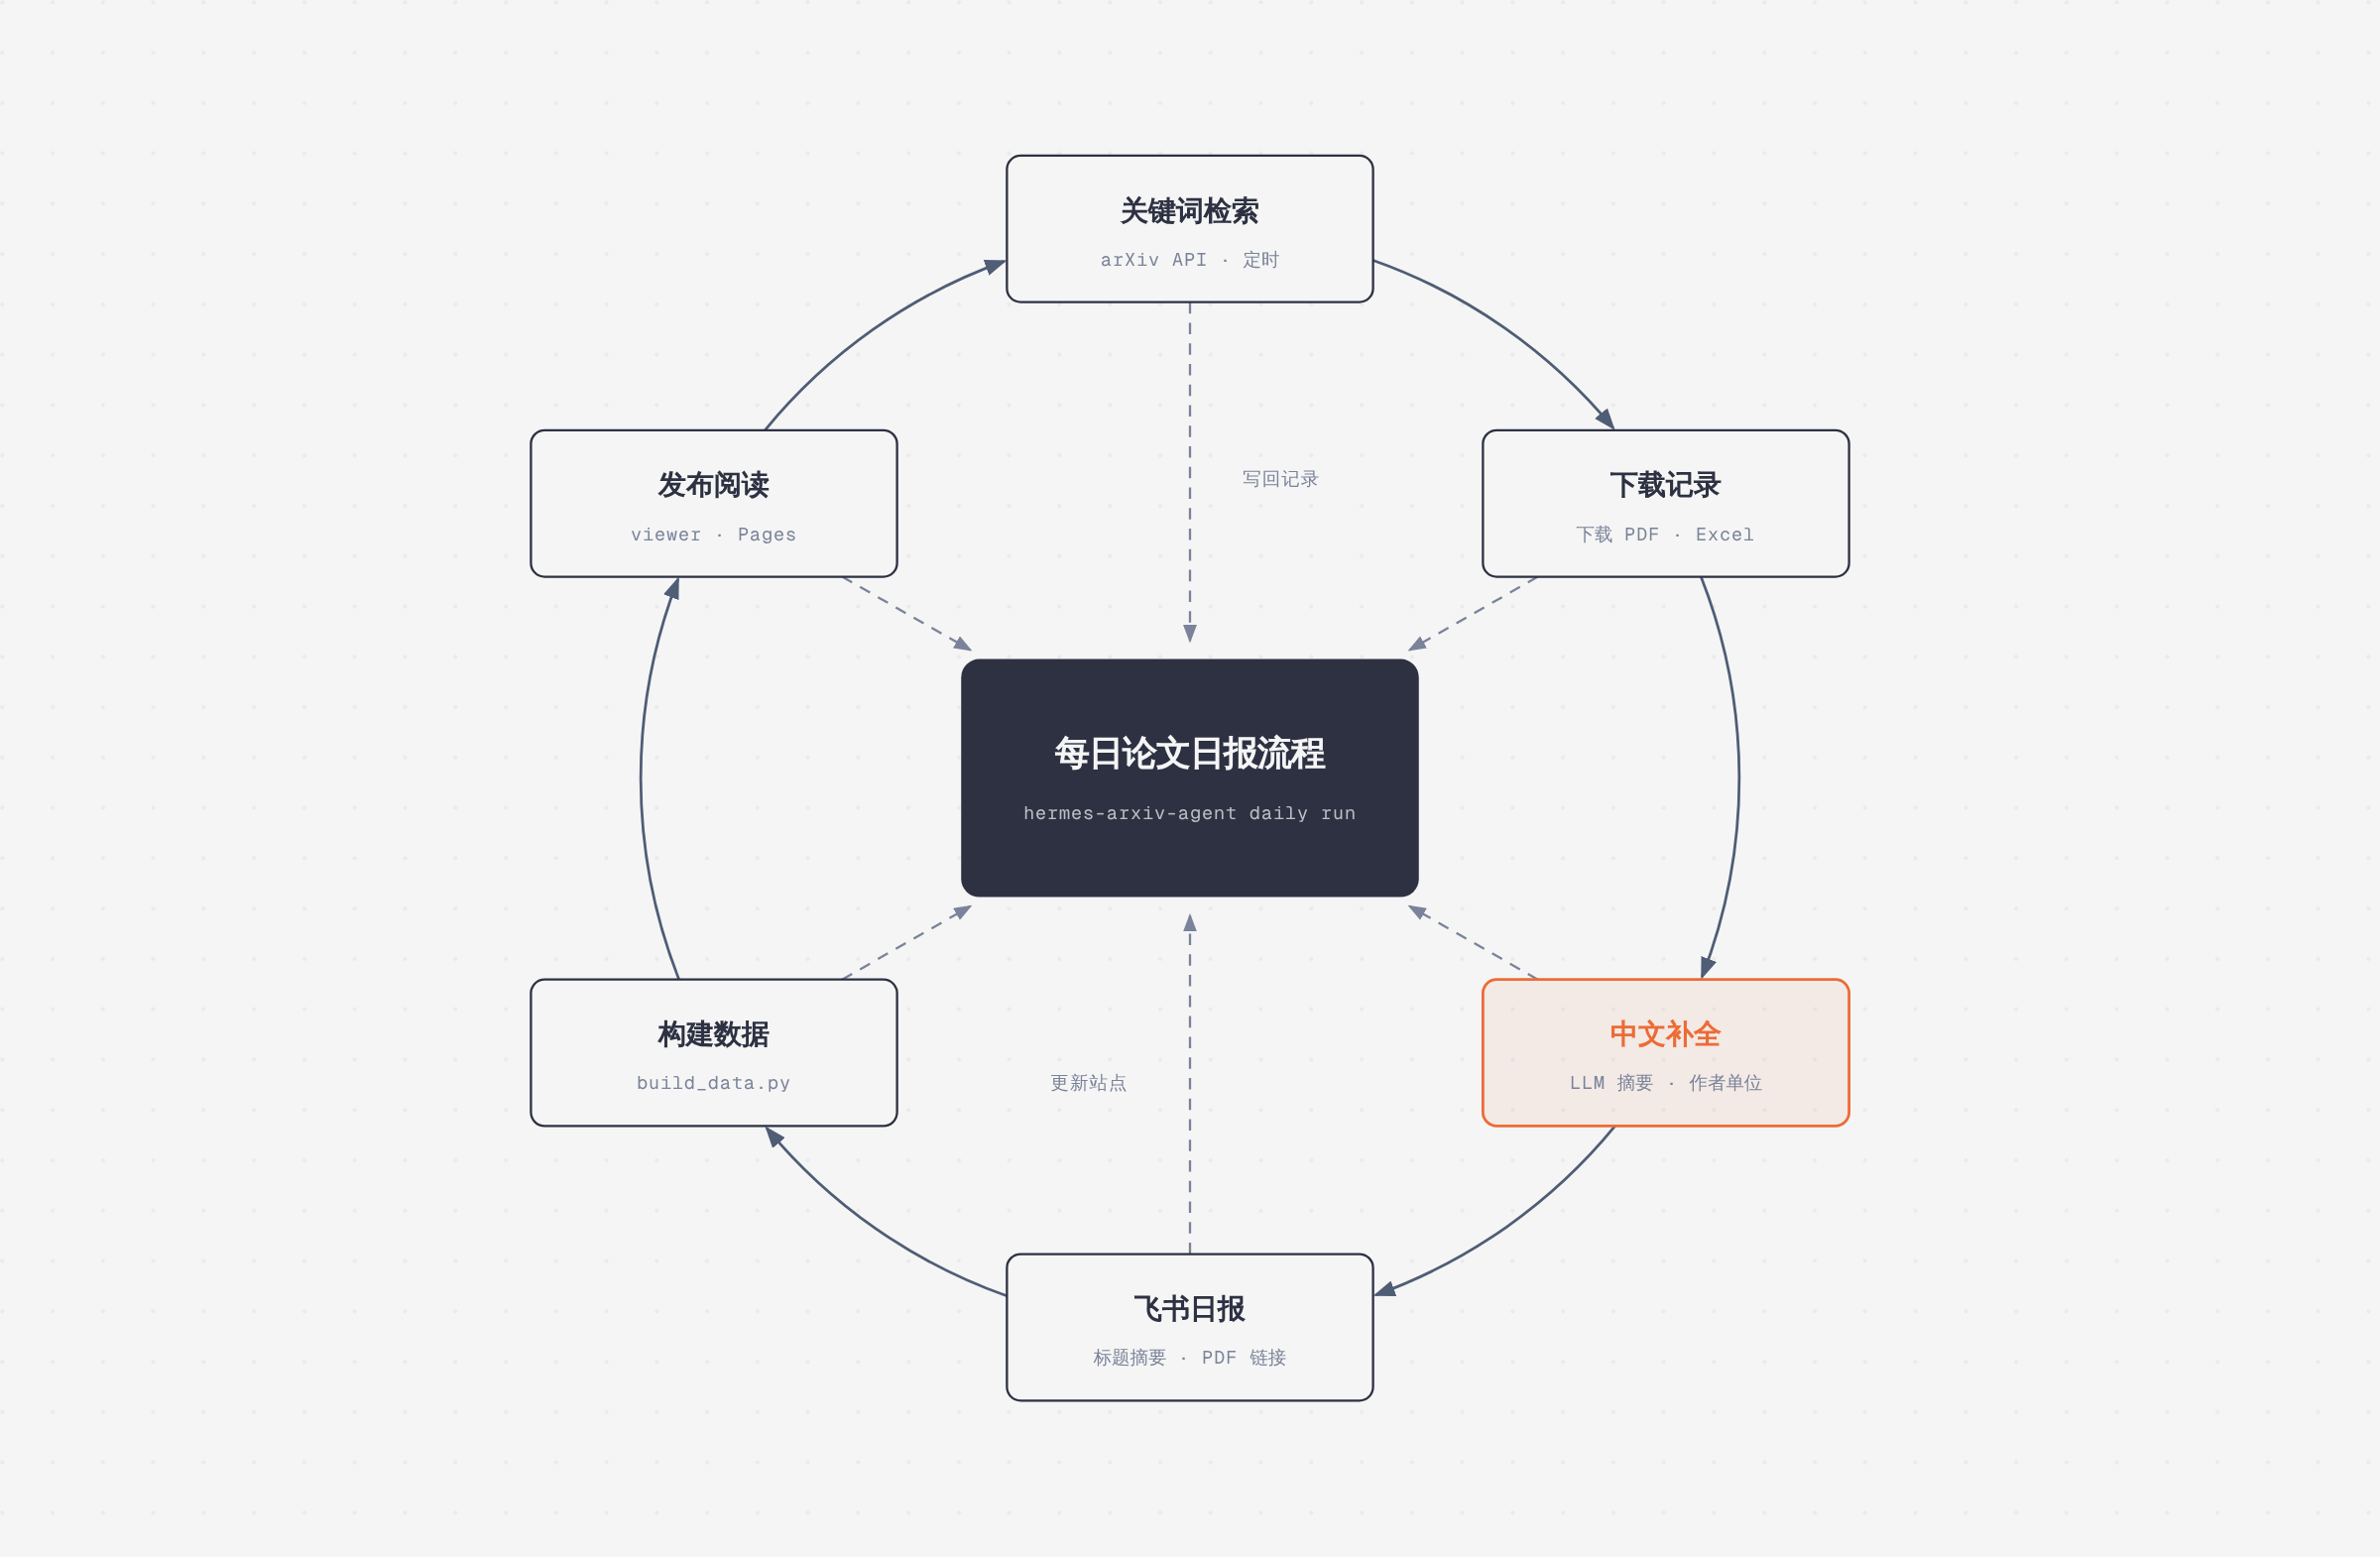
一轮完整的每日运行,按项目设计可以拆成六个站点:
- 关键词检索(arXiv API · 定时):定时任务触发后,
monitor.py读取search_keywords.txt,默认监控 LLM 量化方向,向 arXiv 拉取当日新论文列表。这一步决定了整个流水线的输入集合。 - 下载记录(下载 PDF · Excel):对命中的论文下载 PDF,并写入本地 Excel 记录,形成「论文库」的持久层。此时数据还不含中文内容。
- 中文补全(LLM 摘要 · 作者单位):这是整条链路的焦点步骤。LLM 在这里做两件容易出错但价值最高的事——生成中文摘要,以及从 PDF 中抽取作者单位。抽取结果落到
llm_results.json/merged_llm_results.json,必要时可用reextract_affiliations.py单独重跑单位抽取。 - 飞书日报(标题摘要 · PDF 链接):把标题、作者、单位、PDF 链接、中文摘要组装成日报,通过飞书 gateway 推送。这是「时效性出口」,用户当天就能读到。
- 构建数据(build_data.py):运行
viewer/build_data.py,把 Excel 与补全结果转换成前端可消费的papers_data.json,并同步 pending 状态。 - 发布阅读(viewer · Pages):本地模式下启动
viewer/run_viewer.py即可浏览;Pages 模式下由scripts/publish_viewer.sh提交并推送,push 到main后触发.github/workflows/pages.yml完成站点更新。 两个 hub 之外的动作贯穿始终:写回记录保证 Excel 与 JSON 不脱节,更新站点保证网页内容与最新一轮补全一致。这套设计里最实用的细节是 pending 状态 —— 补全可能因为 LLM 超时或 PDF 解析失败而中断,pending 机制让下一轮只补没补完的部分,而不是全量重跑。
五、核心模块解析
| 模块 | 职责 |
|---|---|
monitor.py | 核心入口:读关键词检索 arXiv、下载 PDF、维护 Excel;--sync-pending-state 用于同步待补全状态 |
prepare_deploy.sh | 按部署模式生成 cronjob_prompt.generated.txt,并在仓库根目录写入 .deploy_mode |
cronjob_prompt.txt | 本地/飞书模式的定时任务提示词模板 |
cronjob_prompt.pages.txt | GitHub Pages 模式的定时任务提示词模板,额外包含发布步骤 |
viewer/build_data.py | 把 Excel 与 LLM 补全结果构建为前端数据 papers_data.json |
viewer/run_viewer.py | 本地启动静态阅读站,默认 http://localhost:8765 |
scripts/publish_viewer.sh | Pages 模式下提交并推送 papers_data.json 等产物,触发 Actions |
reextract_affiliations.py | 单独重跑作者单位抽取,便于定向修复错误结果 |
AGENT_SKILL.md | skill 定义与部署说明,承载固定安装话术的执行依据 |
UPDATE_CRON_SKILL.md | 只更新定时任务、不重装仓库的运维路径 |
search_keywords.txt | 监控方向配置,改这一个文件即可换研究方向 |
cron_setup.sh | 创建/更新定时任务的辅助脚本 |
模块划分有个明显特征:配置与逻辑分离得干净。想换研究方向只动 search_keywords.txt,想换部署形态只在 prepare_deploy.sh / cronjob_prompt.*.txt 之间切换模板,两者互不干扰。这种「模板 + 生成物」的写法虽然朴素,但让「同一个仓库支持两种部署」这件事没有演化成一堆 if。
六、特色能力
中文摘要与作者单位自动补全是项目的真正差异化点。arXiv 本身只提供英文摘要,作者单位则散落在 PDF 首页甚至脚注里,人肉翻一遍十篇还能忍,一天几十篇就不现实。项目把这两件事交给 LLM,并且把结果缓存成 JSON,可复算、可局部重抽。
阅读站的能力也做得比预期完整:日期筛选适合按天清账,关键词全文检索适合回溯某条技术路线,Abstract 展开查看保留了核对原文的通道,收藏则用 localStorage 落地在浏览器本地。前端没有框架依赖,index.html + app.js + styles.css 直接读 papers_data.json,这也是它能无痛跑在 Pages 上的原因。
七、工具链与生态
项目的前置依赖写得很直白:必须先装 Hermes,并完成飞书配置。
# 1. 安装 Hermes
curl -fsSL https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.sh | bash
source ~/.bashrc
hermes

# 2. 配置飞书 gateway
hermes gateway setup

# 3. 在 Hermes 对话中直接说安装话术(本地模式)
#    请从该地址 https://github.com/genggng/hermes-arxiv-agent/blob/main/AGENT_SKILL.md 安装 skill,
#    并按本地模式部署。不要配置 GitHub Pages 发布。

# 4. 启动本地阅读站
cd viewer && python3 run_viewer.py   # http://localhost:8765
Pages 模式的手动发布链路也很清晰:
cd /path/to/hermes-arxiv-agent
DEPLOY_MODE=pages bash prepare_deploy.sh
python3 viewer/build_data.py
python3 monitor.py --sync-pending-state
bash scripts/publish_viewer.sh
生态上它有两点值得一提:一是用双模板(cronjob_prompt.txt / cronjob_prompt.pages.txt)而非单模板加分支来区分模式,读起来更直观;二是把运维也 skill 化,UPDATE_CRON_SKILL.md 专门解决「只想刷新定时任务、不想重装仓库」这个高频诉求。
八、部署与安全
安全边界基本等于「你给 agent 多少权限」。本地模式不要求 fork、不要求 GitHub 写权限,动的东西都在本机,风险最低;Pages 模式要求仓库写权限(推送 papers_data.json)与 Actions 权限,因此文档明确建议 origin 使用 SSH:
git remote set-url origin git@github.com:<your-github-id>/hermes-arxiv-agent.git
首次启用还需在 fork 的仓库设置里把 Pages 的 source 切到 GitHub Actions。另外要注意,Pages 站点的内容会随仓库公开,如果你监控的关键词本身敏感,或者论文库不宜公开,就该留在本地模式。仓库根目录的 .deploy_mode 记录当前模式,prepare_deploy.sh 会据此生成对应 prompt——切换模式时这是一个容易忽略的状态点。
九、适用场景
最典型的是跟踪特定方向每日新论文的个人研究者,例如把默认的 LLM 量化换成自己的细分领域,每天早上在飞书里读一遍中文摘要就已足够。其次是小团队或课题组的日报订阅,飞书群本身就是天然的分享载体。再就是需要网页阅读、检索与收藏的科研阅读场景——Pages 模式让同门有一个统一入口,比在群里翻历史消息高效得多。
反过来,如果你不打算用 Hermes、不打算用飞书,或者只想偶尔手动搜一次 arXiv,这个项目的安装成本明显高于收益。
十、总结评价
这个项目最有价值的地方不是「抓 arXiv」——那部分代码量很小——而是它把一条包含定时、检索、LLM 补全、消息推送、静态发布的多步流水线,压缩成了几句自然语言话术。AGENT_SKILL.md 加 UPDATE_CRON_SKILL.md 这套组合,等于给定时任务装了一个可对话的运维界面:安装不改脚本,更新不删仓库,模式切换靠模板生成。这在同类「论文日报」项目里是少见的工程判断。
适用人群也很明确:已经在用或愿意用 Hermes、有飞书群、关注方向比较稳定的研究者。对这类人,它是开箱即用的生产力工具;对只想看结果的围观者,前置依赖(Hermes + 飞书 gateway 配置)就是第一道门槛,而且不低。
局限性同样要说清楚。其一,项目强绑定 Hermes 与飞书两套外部系统,脱离任一环境都跑不起来,这让它的可移植性远低于一个独立的 Python 脚本。其二,中文摘要与作者单位完全依赖 LLM,抽取质量直接决定日报的可用性,单位抽取尤其容易在跨机构、多单位论文上翻车,reextract_affiliations.py 的存在本身就说明了这个问题会反复出现。其三,仓库没有声明 license,商业使用或二次分发前需要谨慎。其四,关键词召回与去重的边界依赖 monitor.py 与 pending 状态,长时间无人值守运行后,数据一致性需要人工偶尔核对一眼。
总的来说,这是一个定位克制、工程完成度高于平均水平的 agent skill 项目:它不试图做通用的 arXiv 平台,只把「每日日报」这一件事做顺,并把部署与运维的摩擦降到几乎为零。如果你的日常正好落在 Hermes + 飞书的交集里,它值得直接拿来用。