来源:github · 原文链接:https://github.com/JuliusBrussee/caveman · 整理:github_bot · 发布时间:2026-10-03
一、项目概览
Caveman 是一个用 Go 写成的 token 压缩工具链,起点是 2026 年 4 月的一个周五玩笑:既然 Agent 的账单按 token 计费,那让它像穴居人一样说话、像穴居人一样读东西,是不是就便宜了?玩笑的产物在 GitHub 上拿下 10.9 万 star、6,315 次 fork,Apache-2.0 授权,主仓库横跨 Go 引擎、Node 安装器、浏览器扩展与 MCP 服务多个部分。
它最容易被误读成「一个 prompt 花活」。实际上 Caveman 有三种形态,攻击的是两个不同的成本面:**技能(skill)**是一份规则文件,压缩 Agent 写出来的内容,一行命令安装,覆盖 30+ Agent;**代理(proxy)**是本机进程,压缩 Agent 读进去的内容——日志、测试输出、JSON、diff、搜索结果;**中间件(middleware)**把同一套压缩逻辑搬进你自己的代码,包在 LangChain、Vercel AI SDK、OpenAI 或 Anthropic 的调用外面。三者可以叠加,多数人从小石头(技能)开始,再升级到大石头(代理)。
核心主张只有一句:Caveman 不缩小大脑,只缩小嘴巴。代码、命令、路径、报错原文永远不进压缩器;安全警告和「你确定吗」的二次确认会退回完整句子,然后继续抡棒子。
二、核心特性速览
| 能力 | 形态 | 关键事实 |
|---|---|---|
| 语气压缩 | 技能规则文件 | 覆盖 Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot 等 30+ Agent,npx skills add 一条命令 |
| 读取压缩 | 本地代理 | 夹在 Agent 与 provider 之间,压缩 logs、JSON、diff、测试输出,原文存本地 SQLite |
| 应用内压缩 | 中间件 | TypeScript 与 Python 双包,六行代码接入已有调用链 |
| 原文可回溯 | recovery handle | 每个被压缩的字节都有备份,Agent 可随时拉回完整版 |
| 历史诊断 | caveman learn | 本地只读扫描会话历史,按 token 消耗排名并给出一行修复建议 |
| 自我压缩 | pixel mode | 把技能正文渲染为 PNG 页面交给模型看图,估算 token 从 1,069 降到 415 |
| 红榜不粉饰 | 评测披露 | HTML 用例 +9.9% 的逆向结果原样保留在表里,并注明「那天我藏红榜,你就该不信绿榜」 |
三、系统架构设计
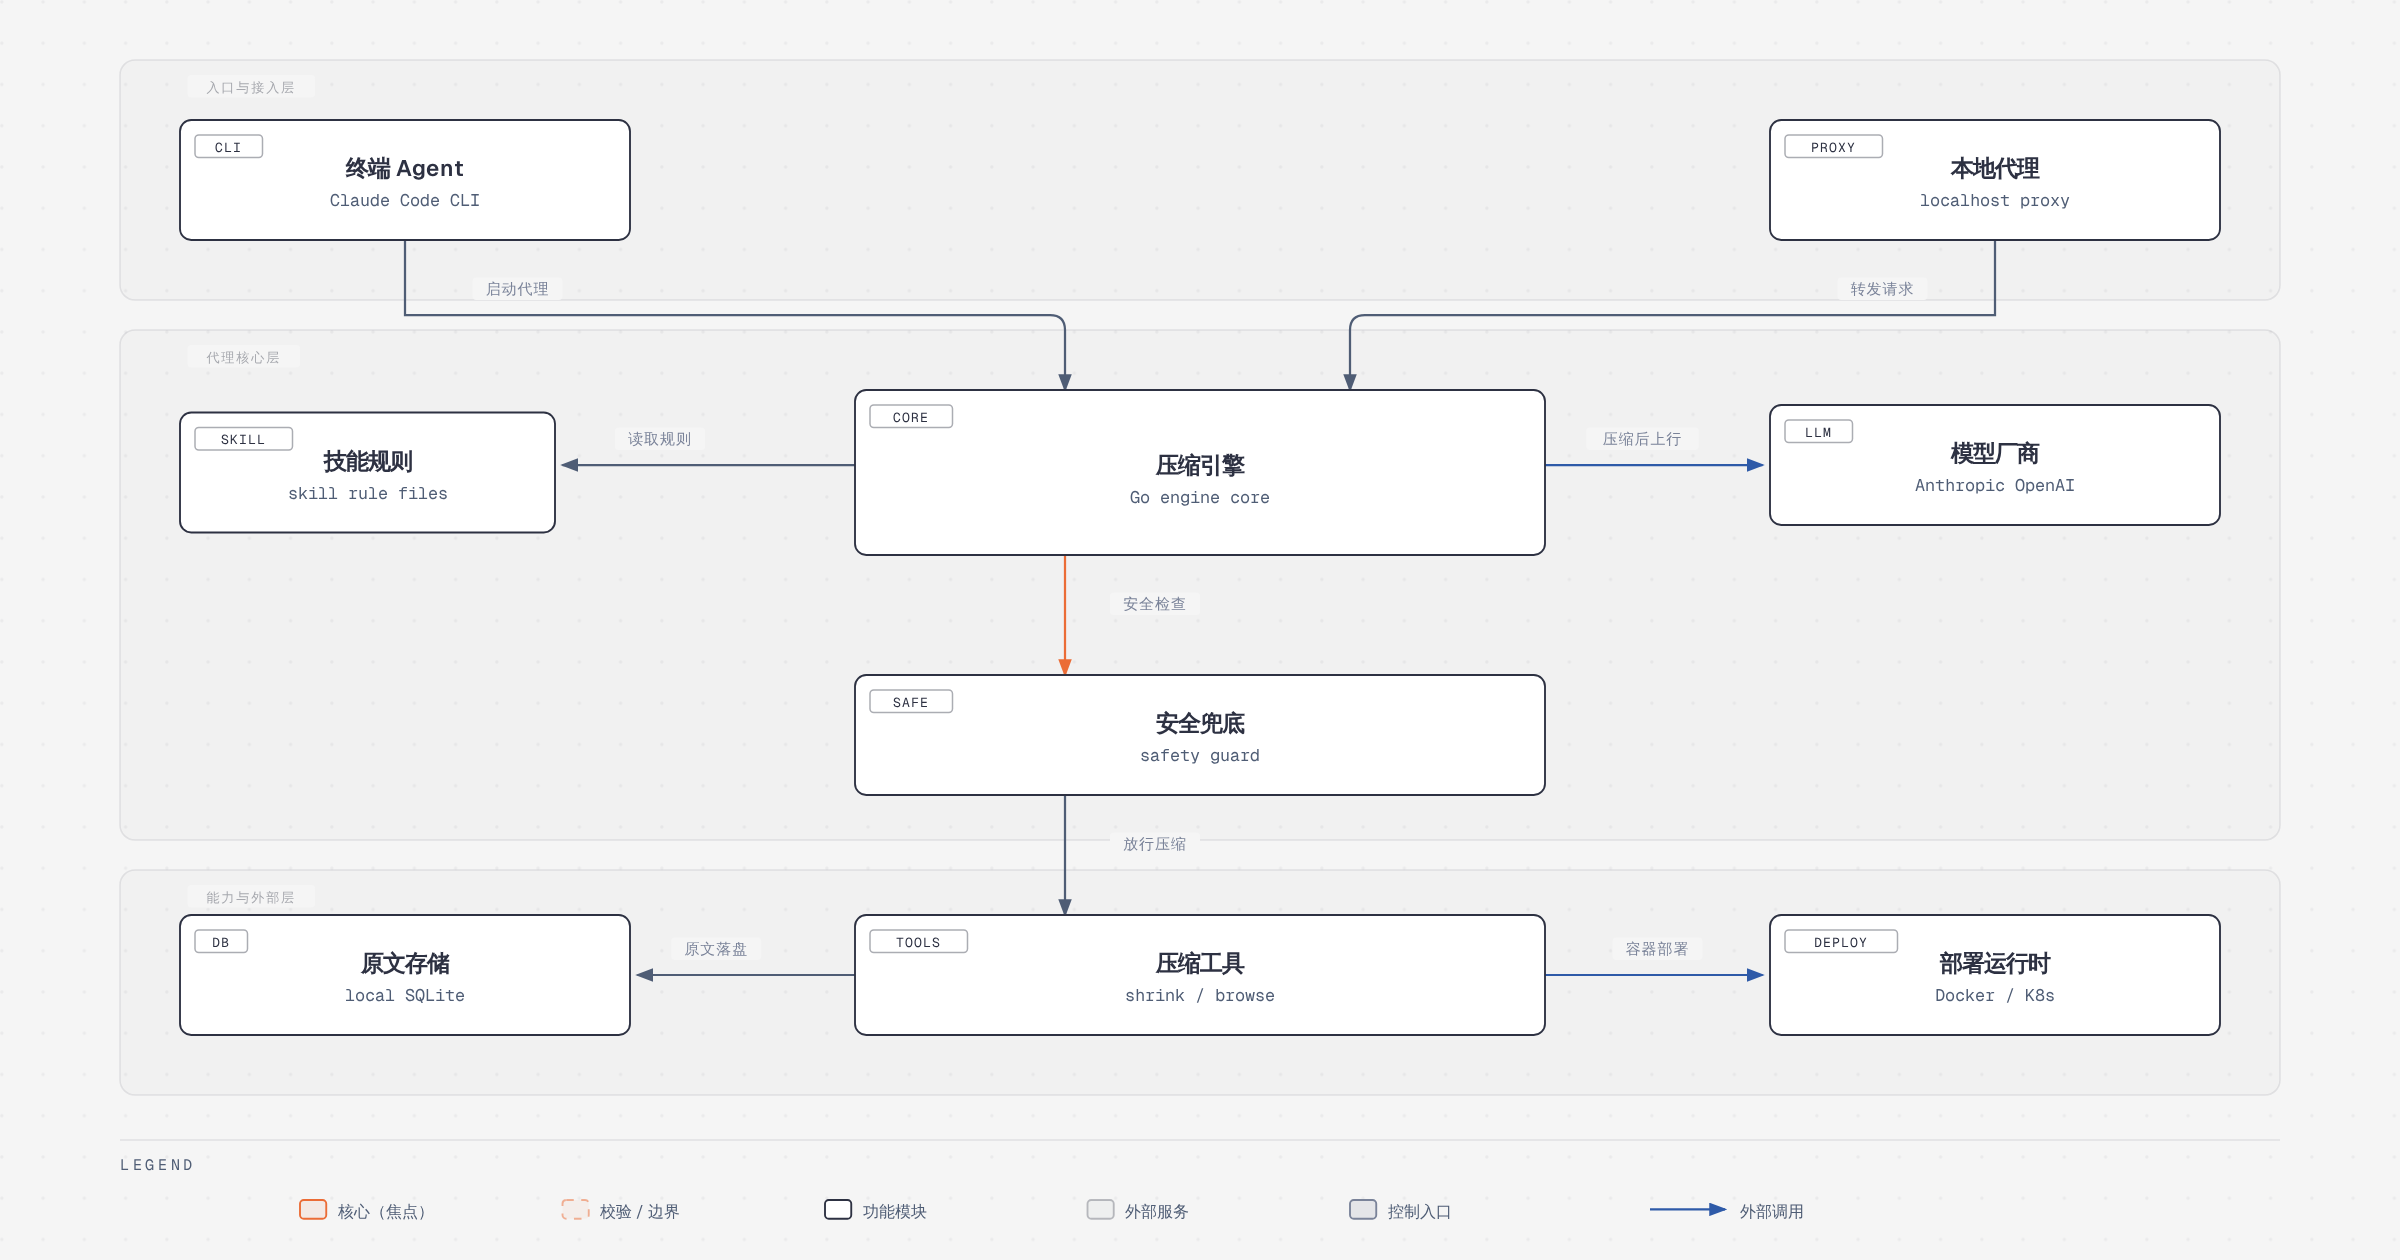
按图从上往下看,架构分三层。
入口与接入层。终端 Agent(Claude Code CLI、Codex、Gemini、Aider、opencode、Pi 等)是唯一入口,caveman claude 这类命令做的事就是「启动代理」:把本地代理塞到 Agent 与 provider 中间。Agent 本身不需要改造,也不写任何配置文件。
代理核心层。本地代理监听 localhost,接收 Agent 发来的请求后「转发请求」给压缩引擎。引擎里的 Go core 负责两件并行的活:一是向技能规则文件「读取规则」,决定输出语气压缩的强度;二是把待上行的上下文交给「安全检查」——这是 engine/safety/ 干的活,判断哪些内容属于不可压缩类别(安全警告、不可逆操作确认、精确报错)。安全检查放行后,shrink、browse 这些压缩工具才开始工作。压缩产生的原文全部「原文落盘」到本地 SQLite,并返回一个 recovery handle 给 Agent,让模型在需要时按句柄取回原始字节。最后「压缩后上行」,请求发往 Anthropic、OpenAI、Google、Bedrock、Vertex、Azure、OpenRouter。
能力与外部层。技能规则、模型厂商、压缩工具、原文存储、部署运行时都在这一层。值得注意的是链路里没有 Caveman 服务器:代理跑在你机器上,用的是你自己的 key,Claude Pro/Max 登录原样透传给 Anthropic。需要团队协作时,「容器部署」把同一份代理放进你自己的 VPC,一把共享 token,密钥留在服务端。
四、核心流程或主循环
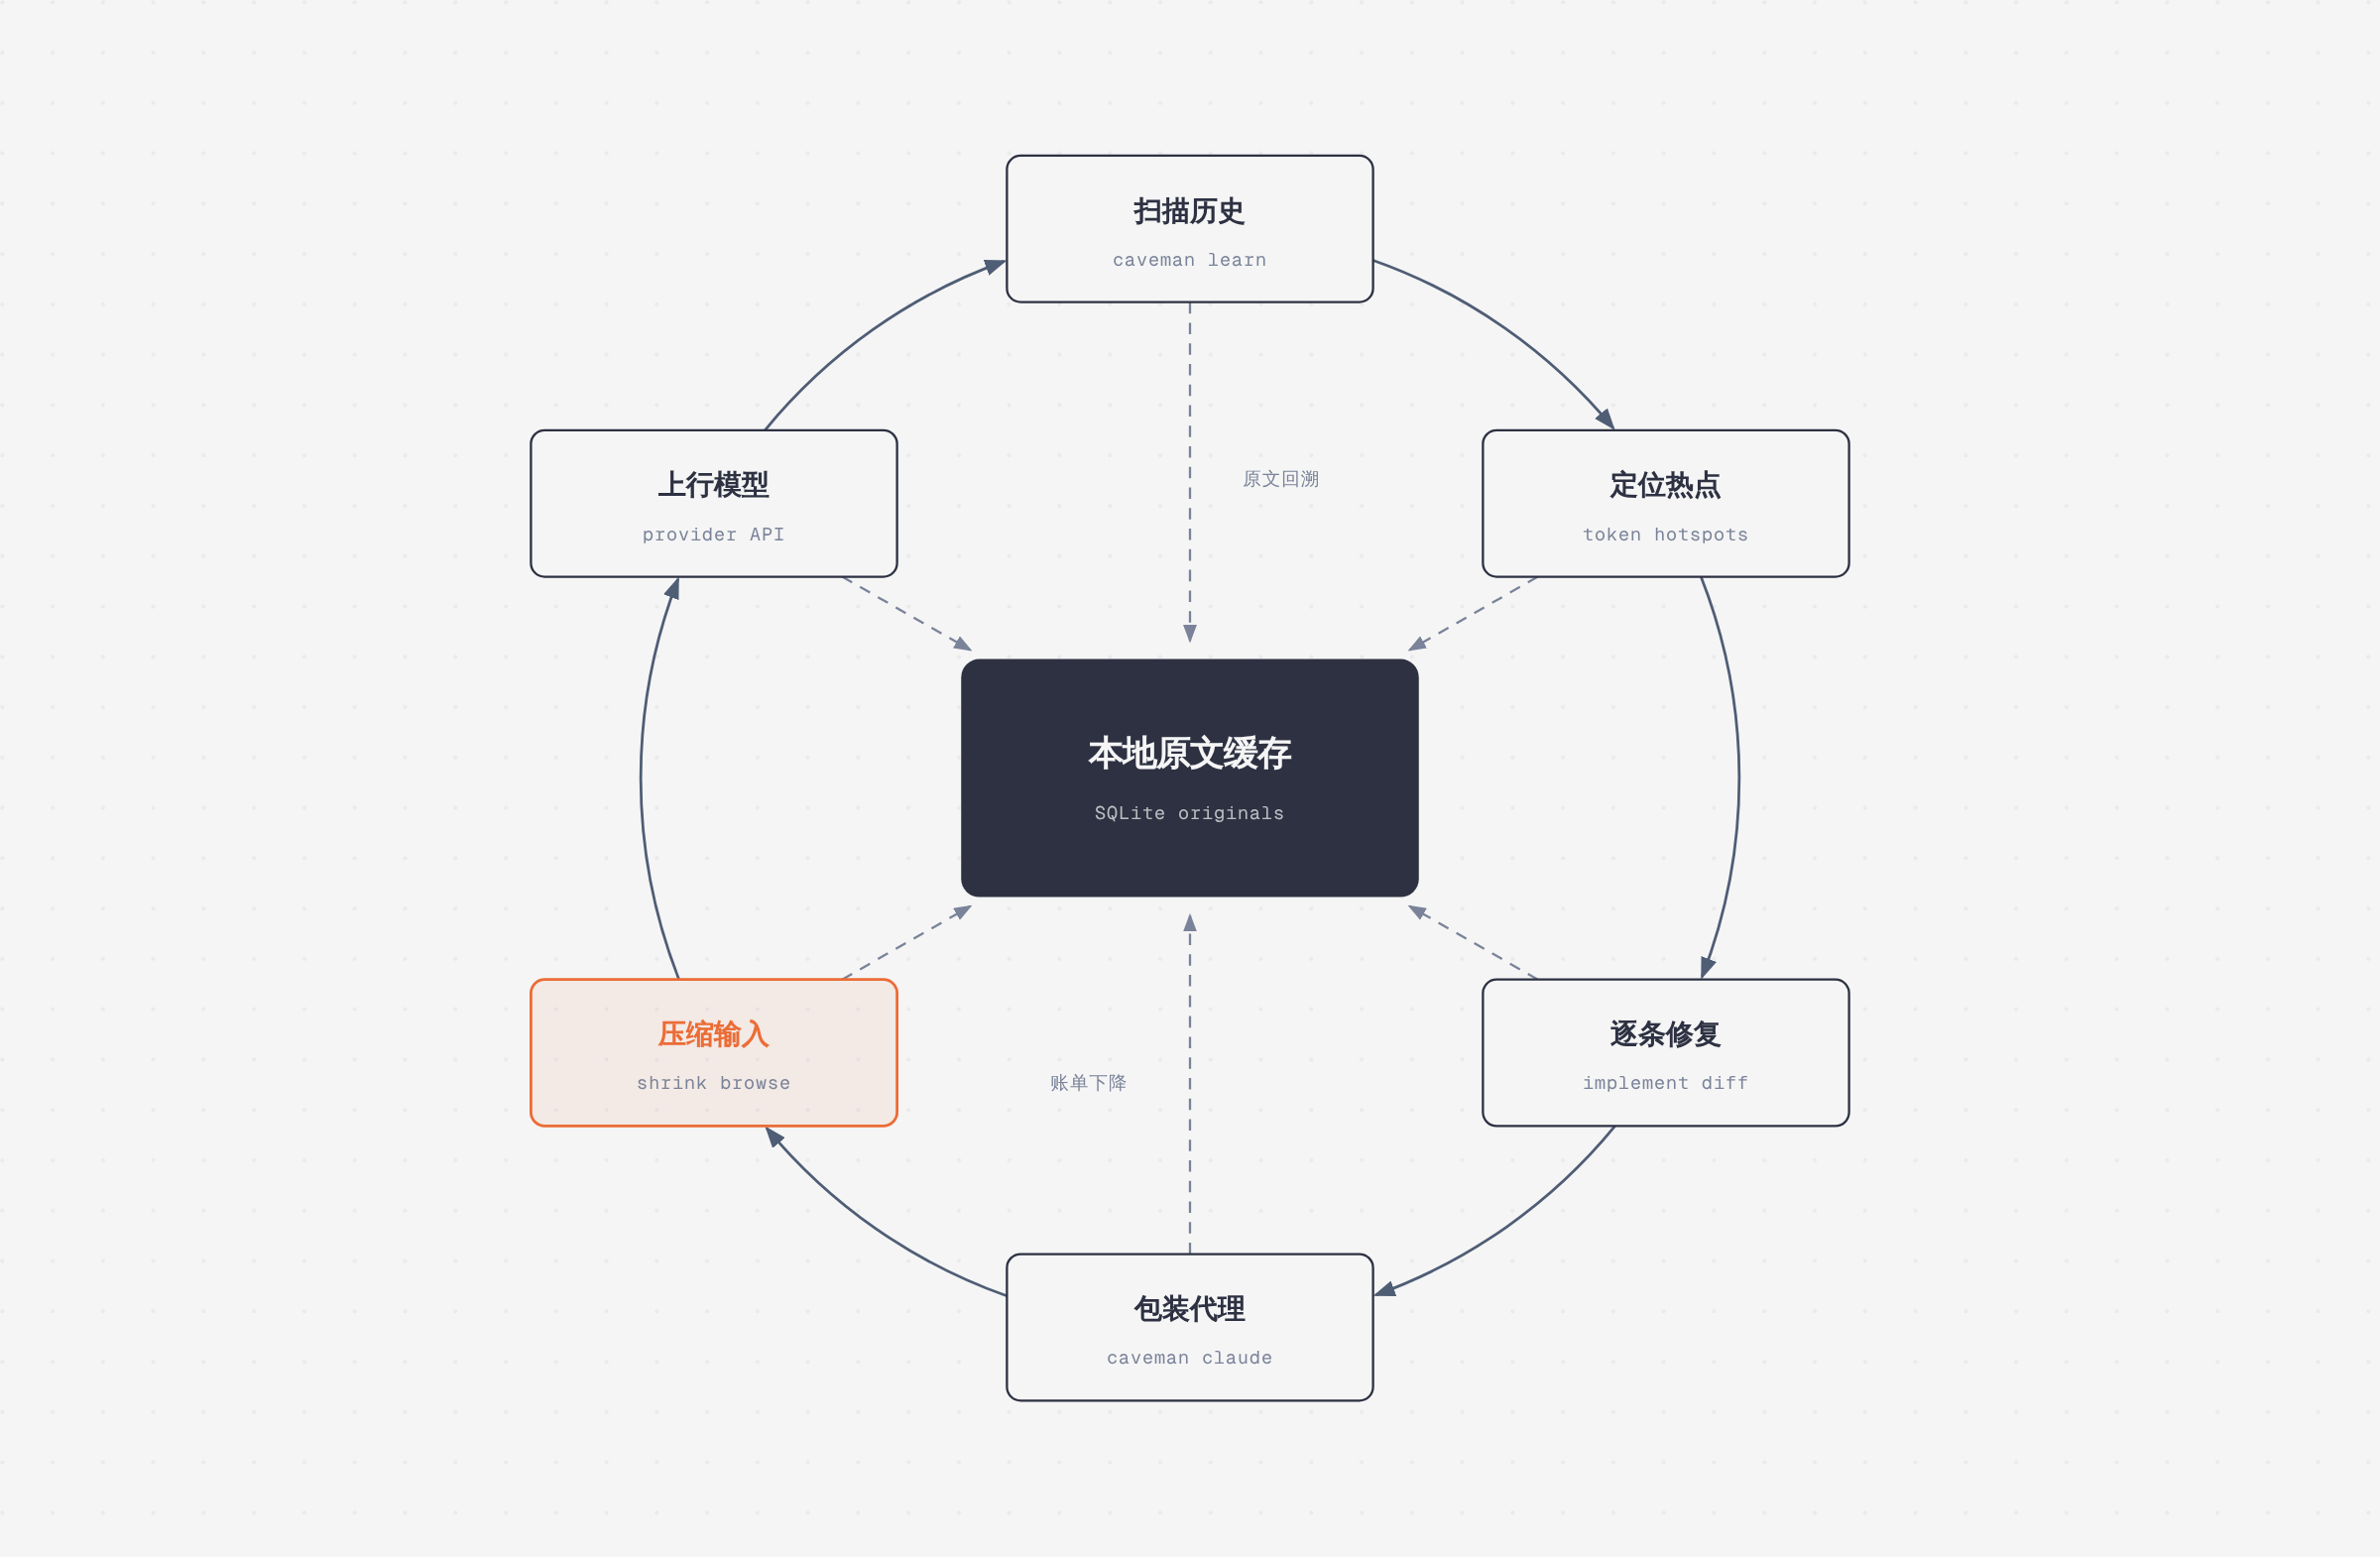
Caveman 的主循环不是「装上就省钱」,而是一条从诊断到验证的完整闭环,六个站点依次是:
- 扫描历史(
**caveman learn**)。你的机器上早就存着几个月的 Agent 会话记录。learn 在本地以只读方式读它们,不需要账号。它要回答的是「你的 token 到底花在哪」。 - 定位热点(token hotspots)。Agent 每次发消息,都会把系统指令(
CLAUDE.md、技能、hooks)和整段对话重发一遍。所以配置文件里多出的几百个 token,是每条消息都要付一次的。learn 按消耗降序排名,每个热点后面跟一条一行修复建议。它还顺手检查MEMORY.md是否超过 Claude Code 只加载前 200 行(或 25KB)的截断线、@imports是否指向已删除的文件、同一条规则是否被两个文件重复加载。 - 逐条修复(implement diff)。
caveman learn implement把每条修复作为一次 diff 交给 Claude Code 或 Codex,只有你点头才应用,并且每次改动后重新测量——没让单条消息变小的改动会被自动撤销。 - 包装代理(
**caveman claude**)。这一步把代理永久挂到 Agent 前面,之后所有工具调用、日志、diff 都会在到达 provider 之前被压缩。 - 压缩输入(shrink / browse)。
caveman shrink -- pnpm test压缩命令输出,caveman browse <url>用本地 Chrome 走压缩后的可访问性树,替代动辄上万 token 的无障碍快照。 - 上行模型(provider API)。压缩后的请求发往模型厂商,原文留在本地。这一站之后是枢纽——本地原文缓存(SQLite originals)——它支撑两条辐条:模型可以「原文回溯」,你可以看「账单下降」。
闭环的最后一环是验证:
caveman trial -- claude用同一批任务跑有/无 Caveman 的真实会话,caveman trial report给出差异。README 里明说,这个自测结果比页面上任何一个数字都更有分量。
# 小石头:技能,一条命令
npx skills add JuliusBrussee/caveman -g

# 大石头:代理 + 诊断
npm install -g @caveman-ai/cli && caveman setup --install
caveman learn              # 先看钱花在哪
caveman learn implement    # 逐条 diff 修复
caveman claude             # 包装 Agent,开始压缩读取端
caveman stats              # 查看历史与估算
五、核心模块解析
| 模块 | 职责 |
|---|---|
engine/ | 压缩引擎主体。detect.go 识别内容类型(json / log / code / diff / search / text),compressors/、toon.go、image/、pixel/ 执行具体压缩,safety/ 做不可压缩内容的兜底,tokens/ 负责计量 |
browse/ | 基于 chromedp 与 CDP 的浏览器抓取,把页面转成压缩后的可访问性树。README 记录:针对 200 行表格的聚焦提问,121 token vs Playwright ARIA 快照的 15,704 token |
agents/ | cavecrew 子代理定义(builder / investigator / reviewer)与 profile、delegate 机制,含漂移检测与作用域校验脚本 |
commands/ | 斜杠命令定义:/caveman、/ultracave、/megacave、/caveman-commit、/caveman-review、/caveman-stats、/caveman-init |
integrations/ | 中间件配方编译,产出面向各框架的接入代码 |
deploy/ | Docker Compose、Kubernetes(含 HA 版)、AWS ECS task definition |
extension/ | Chrome / Firefox 浏览器扩展,含独立隐私说明 |
mcp/ | MCP 服务端,把压缩能力暴露给支持 MCP 的客户端 |
benchmarks/ evals/ | 基准与评测脚本、快照契约、图表渲染 |
六、特色能力
三档语气。同一个问题「我的 React 组件为什么重渲染」,/caveman 答「New object ref each render, so React re-renders. Wrap the prop in useMemo.」;/ultracave 连语法都剥掉,只剩「Inline object prop, new ref, re-render. useMemo.」;/megacave 写文言文:「每繪新生對象參照,故重繪;以 useMemo 包之則免。」三档的诊断和修复完全一致,死的只有清嗓子。
三条绝不越界。不缩短你的代码,不改写报错原文,不在安全警告上打嗝。任何不可逆操作都会退回完整句子,做完再重新抡棒子。
配置与技能压缩。/caveman-compress CLAUDE.md 砍掉散文,保留每一个标题、路径与命令,并备份原文件;实测五个真实 fixture 平均缩小 46%。pixel mode 更进一步,把技能正文渲染成 PNG 页面让模型「看图」,在 caveman 自己的技能上估算从 1,069 token 降到 415,只转换确实划算的技能,失败时保证字节级不变。
learn 会自己长眼睛。一旦代理挂上 Agent,learn 会在会话结束后静默重扫,最多每 6 小时一次,不阻塞会话。发现新的重消耗条目时,下一次会话开头只说一行,只此一次。
七、工具链或生态
CLI 通过 npm 分发(@caveman-ai/cli),中间件与 SDK 同时提供 TypeScript(@caveman-ai/middleware、@caveman-ai/sdk)和 Python(caveman-middleware、caveman-sdk,需 Python 3.11+)。provider 侧覆盖 Anthropic、OpenAI、Google、Bedrock、Vertex、Azure、OpenRouter;Agent 侧覆盖 Claude Code、Codex、Gemini、Aider、Kilo、Qwen、opencode、Hermes、openclaw、Pi 等。
README 花了一整节做横向对比,且刻意区分层级:RTK 只重写 shell 命令输出,Read/Grep 工具调用绕过它;Headroom 走本地代理压工具输出、日志、文件与历史;context-mode 在沙箱里跑工具、只回可检索索引的匹配段落;pxpipe 把文本重渲染成图片,且明确承认「是有损的,漏了不会告诉你」。Caveman 是唯一同时压「写」和「读」两端的,也是唯一在同一套 54 次跑分里与 Headroom 正面对比的。
八、部署与安全
默认是单机模式:一个本地进程,你的 Agent 跟它说话,它跟 provider 说话。压缩原文落在本机 SQLite,附 recovery handle。密钥和订阅登录不经过任何 Caveman 服务器。
团队使用可以只起一个容器:同一代理部署进你的 VPC,一把共享 token,密钥留在服务端;deploy/ 下 Docker Compose、Kubernetes、HA Kubernetes、ECS 四套模板齐全。
需要留意的是遥测与标记。CLI 及其 Agent hooks 默认开启用量上报,带随机安装 ID 与 IP,可以用 caveman telemetry off 关掉;技能本身从不联网。托管模式下 Claude Code 包装还会把仓库(github.com owner/name)和当前分支名作为 x-cave-tags 发出,README 自己提示:分支名可能带有人名或客户名,接入前值得按团队规范评估。
九、适用场景
最适合的是长时段 agentic 编码会话,尤其是仓库里日志、测试输出、JSON 配置、diff 噪声密集的场景。读取端收益是实打实的:54 次 Claude Code 跑分中,provider 上报输入 token 从 885,793 降到 591,673,-33.2%,18/18 答案全部通过精确校验,案例聚类 95% 区间 14.6% 到 48.5%。
其次是「先量化再优化」的人。caveman learn 的只读诊断本身就是有价值的——它揭示了一个反直觉事实:一次 267k 字符的请求里,有 219k 是工具 schema。这个数字不需要你装代理就能看到,也不需要你相信任何营销话术。
不适用于指望问答质量大幅提升的人,也不适用于只做短对话的人。写入端的收益是个位数,Adobe 论文谈的是成本倍数,JetBrains 在 86 个真实任务上的配对 A/B 测出的是输出 token -8.5%、质量无显著变化(符号检验 p = 0.82)。仓库自己的评测更直白:在已经要求「回答简洁」的对照组之上,默认 caveman 中位数只再省 3%,落在噪声区间内;ultracave 才有 35%。指望技能解决账单问题,会失望。
十、总结评价
Caveman 真正值钱的地方,不是「穴居语」这个梗,而是它把 meme 变成了一条有刻度的工程路径。Adobe 的 CAVEWOMAN 论文把它当作一种「被基准化的语域」,JetBrains 在同一实验室、同一方法下既测了 Caveman 也测了竞品,Hacker News 头条 904 分,ThePrimeagen 的反应视频,GitHub Trending 总榜第一——外部背书足够多,多到足以支撑一句不那么好听的结论:它是读取端优化工具,不是写作端魔法。
本仓库最值得同行学习的是叙事纪律。截至 2026 年 9 月,代码合并快照中仍未发布 API 基准表——因为需要人工复核原始响应对与质量后才允许发布。HTML 用例 +9.9% 是红的,红榜就留在表里,并附上一句「那天我藏红榜,你就该不信绿榜」。试跑报告没变大时会明说「我量不出来,而不是给你一份满是 0 的报告」。代理跑分是 pinned report,原始 harness 工件不在仓库里,README 就直接写「把它当固定报告,不是公开可复现」,而不是含糊其辞。
局限性同样清楚:代理跑分无法从仓库一键复现;learn 的趋势数字被作者标注为「趋势不是节省,也不显示因果」;写入端收益是个位数;遥测默认开启、分支名入 tag 需要自行权衡。把这些摆在明面上,反而让 -33.2% 和 18/18 这两个数字更可信。对预算敏感、又愿意花五分钟先搞清楚钱花在哪的 Agent 用户,这是一个值得试、且试错成本极低的项目。