来源:github · 原文链接:https://github.com/affaan-m/ECC · 整理:github_bot · 发布时间:2026-10-04
一、项目概览
ECC 的起点相当朴素:作者在 2025 年 9 月用 Claude Code 做出 zenith.chat,拿下 Anthropic x Forum Ventures 黑客马拉松,随后把 10 个多月高强度日常使用中积累下来的整套配置开源。但这里说的"配置"必须打引号——仓库里躺着数十个专用子智能体、293 个技能模块、94 条命令、多语言规则目录、Node.js 钩子实现、MCP 清单、测试套件,以及一个用 Rust 写的控制层 ecc2/。它早已不是"我的 .claude 目录备份"这种 dotfiles 意义上的东西,而是一份带安装器、带自托管市场清单、带发布校验流程的软件发行物。
一句话定位:ECC 是运行在编码智能体之上的一层 harness——它不改模型,改的是模型被调用时的上下文、工具集、行为约束与记忆。
这个定位很重要。当下绝大多数"AI 编码技巧"类仓库交付的是提示词片段,而 ECC 交付的是一套可安装、可审计、可跨 Harness 迁移的运行时约定。MIT 许可、JavaScript 为主、附一个 Rust 控制层,构成了它的技术底色。
二、核心特性速览
| 能力 | 具体内容 | 解决的问题 |
|---|---|---|
| 子智能体 | 代码审查、构建修复、E2E 执行、架构设计、文档查阅,并按语言与框架细分(Go、Rust、Kotlin、Flutter、Django 等) | 把宽泛任务交给带边界、带模型选型的专用角色 |
| 技能体系 | 293 个 SKILL.md,覆盖编码规范、框架模式、TDD 工作流、内容运营、投研材料 | 工作流可复用,而非一次性提示词 |
| 本能学习 | continuous-learning-v2,带置信度评分,支持导入导出与聚类演进 | 让个人习惯沉淀为可迁移资产 |
| 统一记忆 | ecc.memory.v1 Markdown 文档 + ecc-memory-mcp 服务 | 跨会话、跨 Harness 传递上下文 |
| 安全审计 | AgentShield:102 条静态规则、5 大类扫描、可选对抗式深度分析 | 把 AI 配置本身当攻击面来审 |
| 跨框架适配 | Claude Code、Codex、Cursor、OpenCode、Gemini、Kimi Code | 一份配置多处复用,降低切换成本 |
| 验证与评估 | eval-harness、verification-loop、检查点与 pass@k 指标 | 让"看起来能跑"变成"可证明达标" |
三、系统架构设计
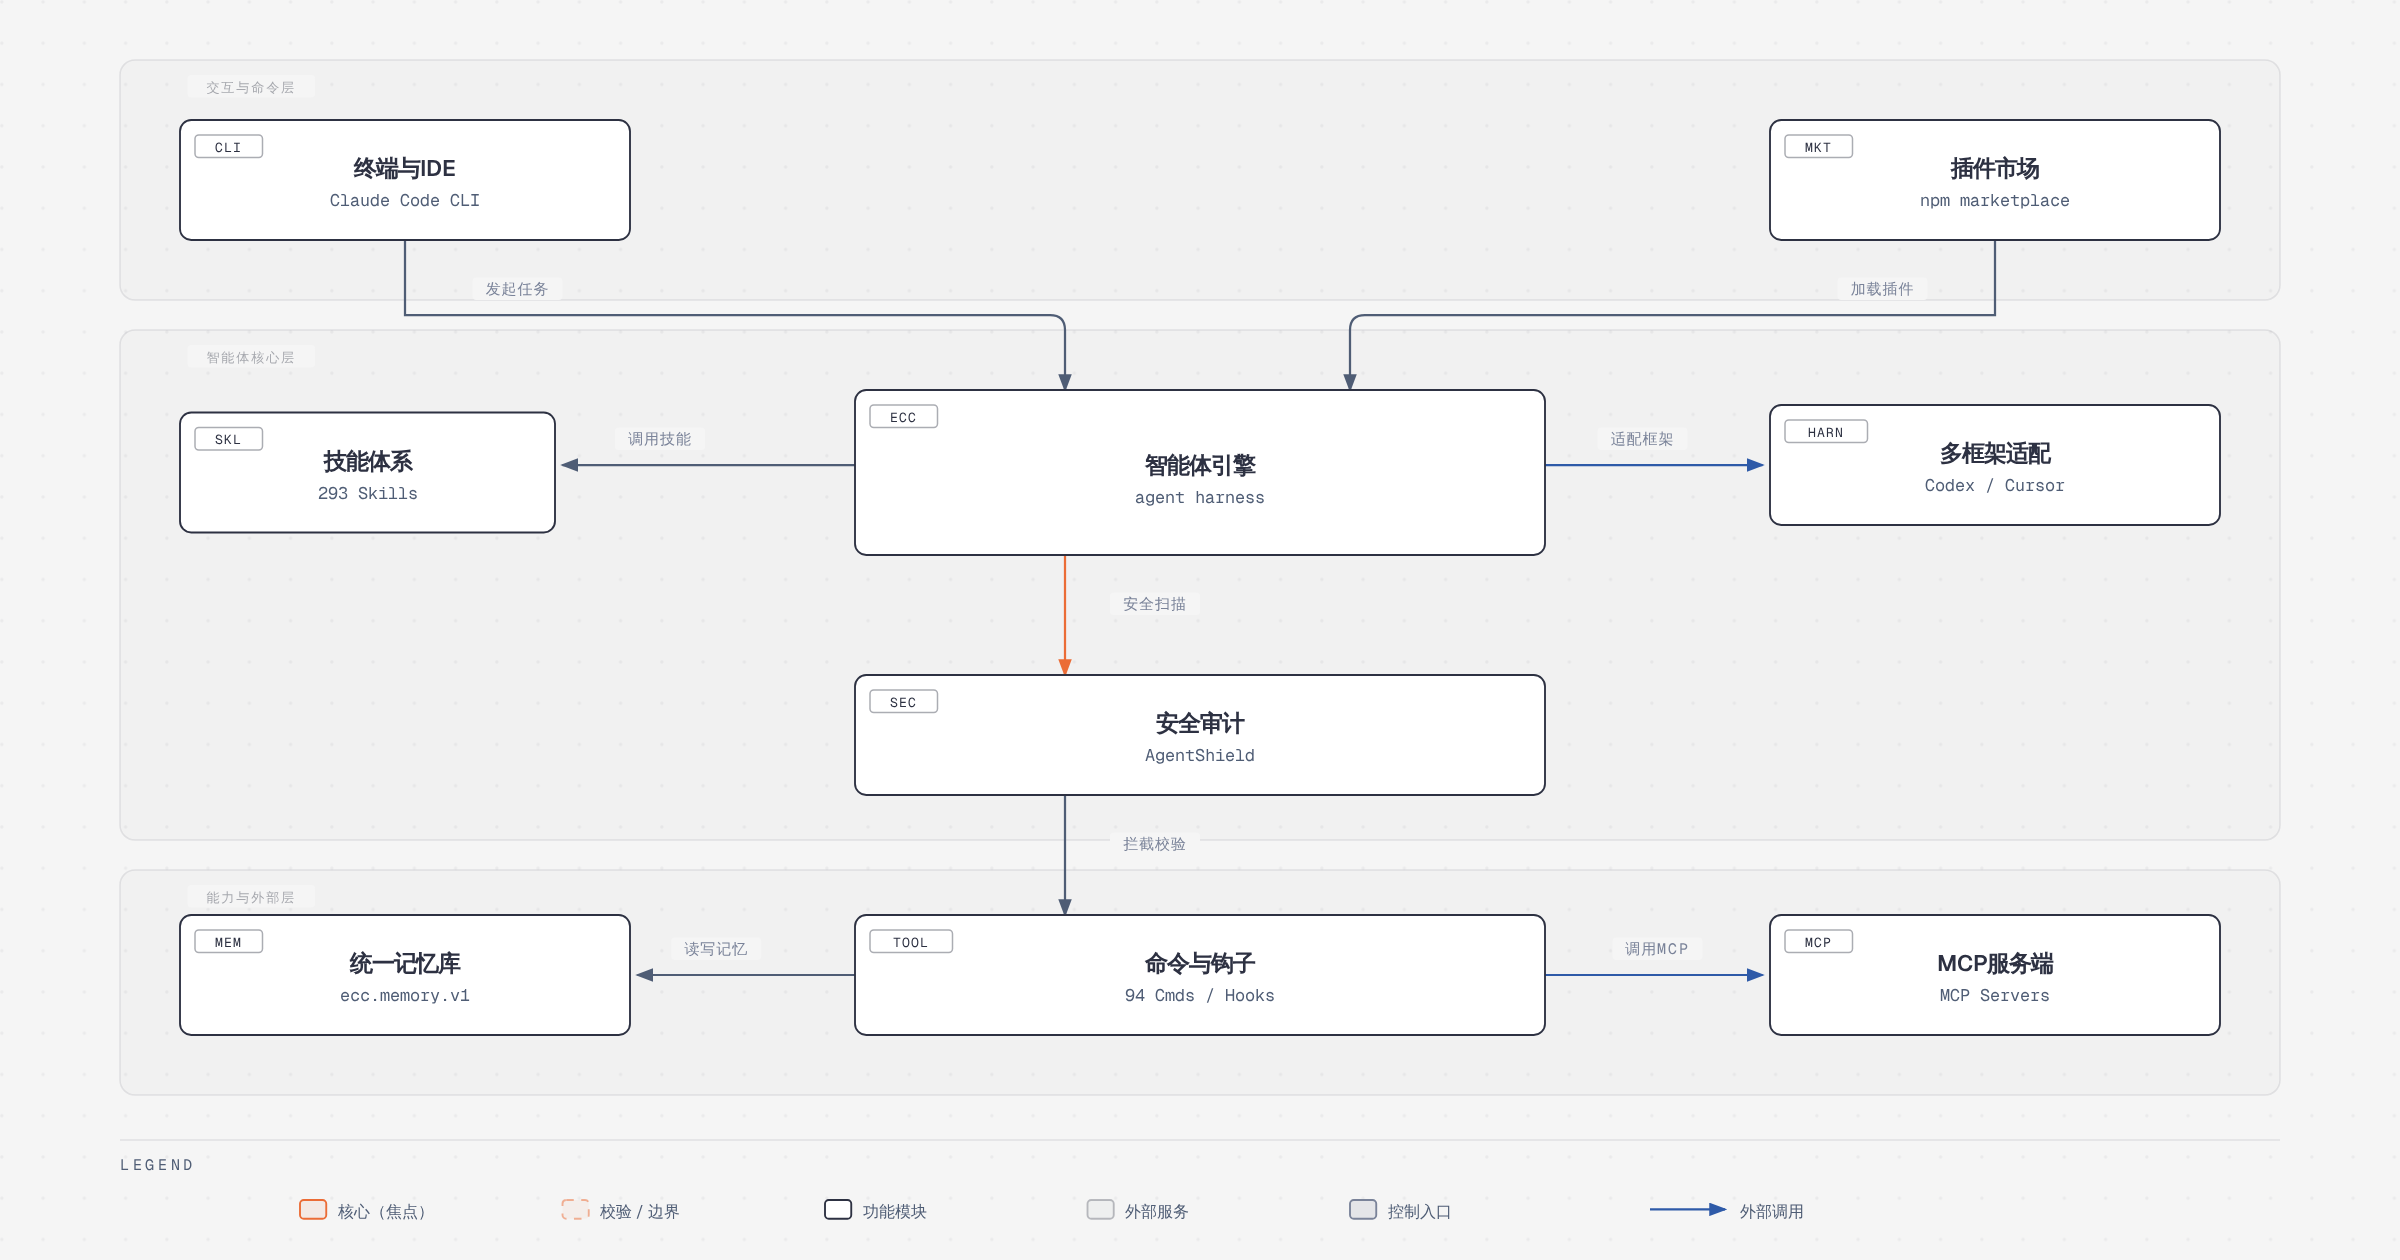
按架构图的三层来看,ECC 的层次感相当清晰。
交互与命令层由"终端与 IDE"和"插件市场"两个入口组成。前者是 Claude Code CLI——所有任务的实际发起方;后者是 npm 与自托管 marketplace,通过 /plugin marketplace add 把 ECC 的清单加载进宿主环境。这一层的关键约束是:安装动作只负责挂载组件,不负责改写行为,行为由核心层决定。
智能体核心层是 ECC 本体的所在,即"智能体引擎"(agent harness)。引擎向左调用技能体系(293 Skills),向下调用安全审计(AgentShield),向右对接多框架适配层(Codex / Cursor / OpenCode)。这四个节点之间的关系不是并列,而是有方向的控制流:核心发起技能调用,核心触发安全扫描,安全审计再把手伸向命令与钩子层做拦截校验。换句话说,安全不是事后检查,而是插在工具调用路径上的闸门。
能力与外部层包含三个执行侧节点:命令与钩子(94 条命令 + PreToolUse/PostToolUse/Stop 钩子)、统一记忆库(ecc.memory.v1)、MCP 服务端。命令与钩子是这一层的枢纽——它同时向记忆库读写、向 MCP 服务发起调用,是上下文进出系统的唯一通道。
值得单说一句的是清单与约定。.claude-plugin/plugin.json、marketplace.json、manifests/ 下的 install-profiles 构成了一条声明式装配链。这里有个被反复踩过的坑:Claude Code v2.1+ 会按约定自动加载插件中的 hooks/hooks.json,一旦在 plugin.json 里显式声明该文件就会触发"重复钩子文件"错误。仓库为此加了回归测试,说明这层看似琐碎的装配约定,恰恰是插件生态里最容易翻车的地方。
四、核心流程或主循环
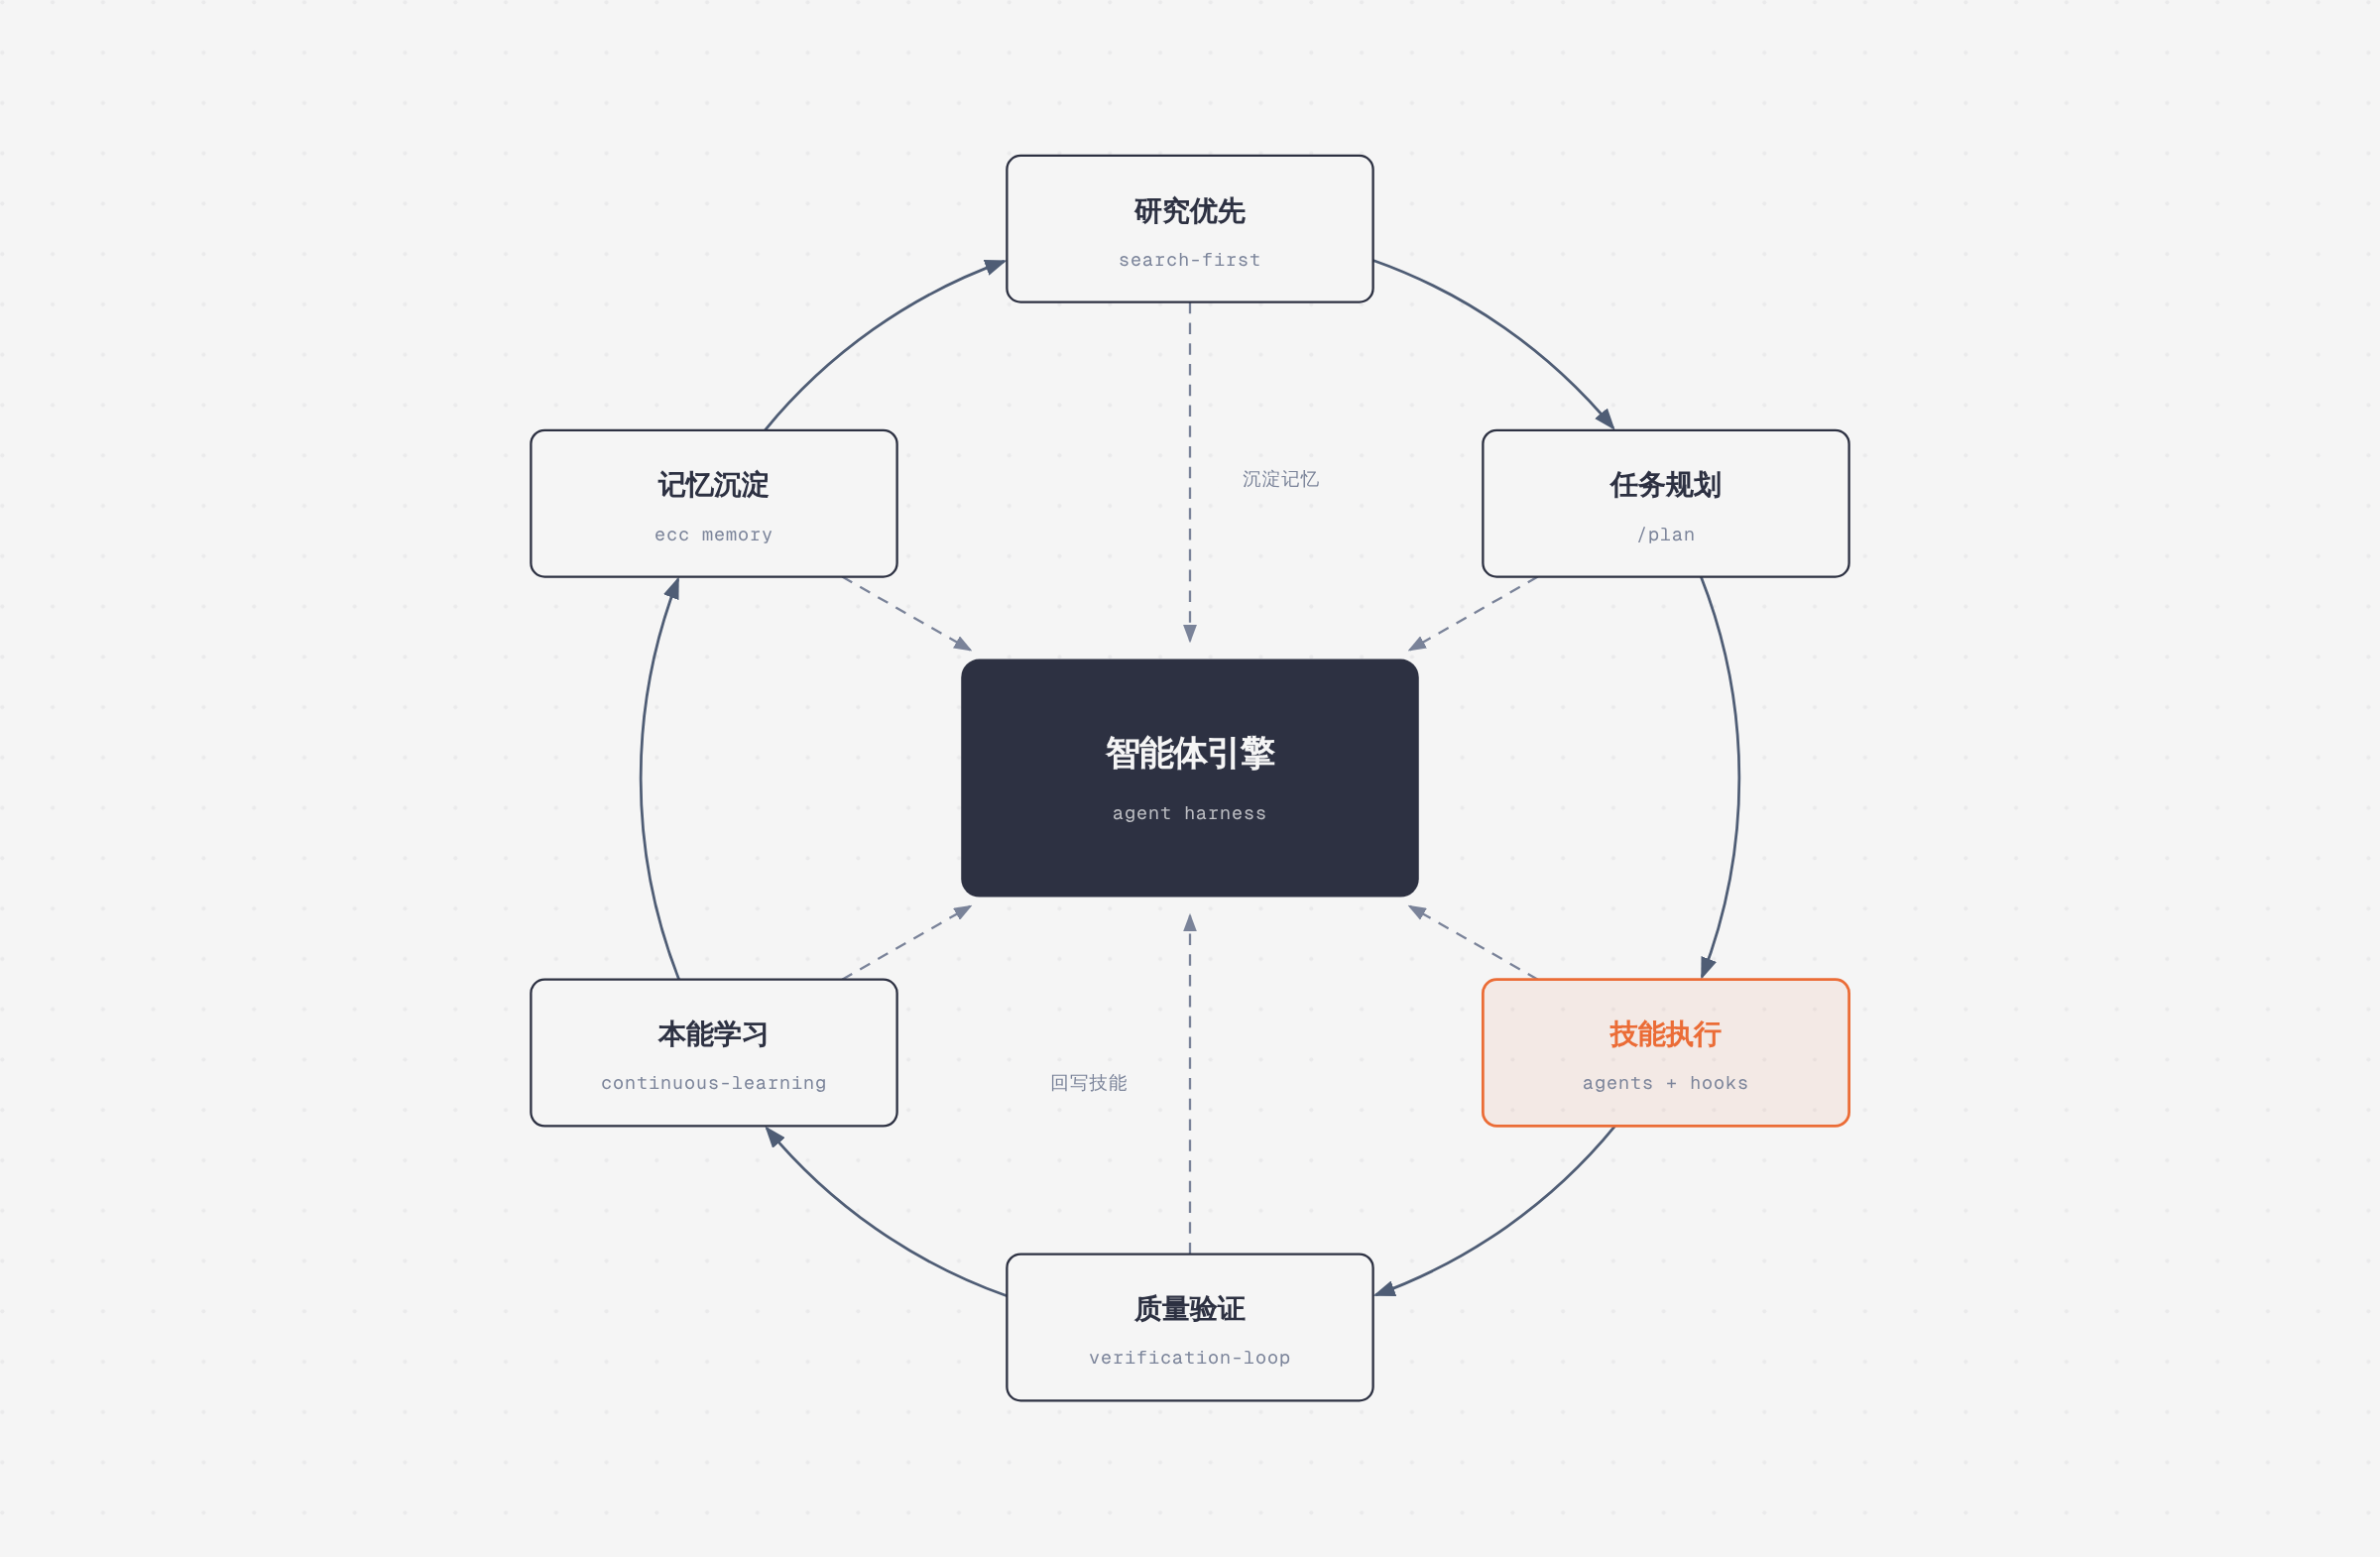
ECC 的主循环是六站闭环,中心是智能体引擎,焦点落在第二站"任务规划"上。
第一站:研究优先(search-first)。 接到需求后不直接写代码,而是先调研——查文档、查既有实现、查依赖的真实 API 签名。仓库里甚至有一个独立的 search-first 技能专门约束这个阶段。
第二站:任务规划(**/plan**)。 画流程图的焦点在这里,因为这是整个循环的收敛点:把研究结果转成可执行的任务分解,明确哪些交给哪个子智能体、用哪个模型。规划质量直接决定后面四站的返工次数。
第三站:技能执行(agents + hooks)。 子智能体带着有限工具集执行,钩子在工具事件上实时介入——编辑 TypeScript 文件时检查残留的 console.log,写入前做类型检查,提交前跑质量门禁。
第四站:质量验证(verification-loop)。 通过 /quality-gate、eval-harness、verification-loop 做持续验证。这里区分了检查点式验证与持续评估两种模式,并引入评分器类型与 pass@k 指标,避免"测试通过即完工"的假象。
第五站:本能学习(continuous-learning)。 会话结束后,evaluate-session.js 从交互中提取模式,写入本能集合并附置信度评分。反复出现的模式置信度上升,攒够了就用 /evolve 聚类成技能——这是循环向外延展的那条"回写技能"辐条。
第六站:记忆沉淀(ecc memory)。 把跨会话有效的上下文写进 ecc.memory.v1 文档,形成"沉淀记忆"辐条。下一轮从第一站重启时,记忆库和技能库已经是上一轮迭代的产物——这就是闭环的真正含义:产出不只是代码,还有下一轮的起点。
五、核心模块解析
| 模块 | 职责 |
|---|---|
agents/ | 任务委派的专用子智能体定义,每个带 name、description、tools、model 元信息,按语言与框架细分 |
skills/ | 工作流定义与领域知识库,从 coding-standards、tdd-workflow 到 market-research、investor-materials |
commands/ | 维护中的斜杠命令兼容层,官方立场是"优先使用 skills" |
legacy-command-shims/ | 已退役短命令(/tdd、/eval、/verify)的按需归档,避免老用户脚本直接断裂 |
rules/ | 强制规范,common/ 为必装,另附 typescript、python、golang、swift、php 等语言目录 |
hooks/ | 基于触发器的自动化,含 hooks.json、codex-hooks.json 与钩子元数据 |
scripts/ | 跨平台 Node.js 实现,含包管理器检测、会话启停、上下文精简、模式提取 |
contexts/ | 动态注入的系统提示上下文,分 dev、review、research 三种模式 |
mcp-configs/ | GitHub、Supabase、Vercel、Railway 等 MCP 服务端定义 |
ecc2/ | Rust 控制层,提供 dashboard、start、sessions、status、resume、daemon 等命令 |
manifests/ | 安装配置、模块与组件清单,驱动引导式多 Harness 安装 |
tests/ | 工具库、钩子与运行时的测试套件,node tests/run-all.js 一键执行 |
六、特色能力
本能学习与置信度评分是 ECC 里设计得最有想法的一块。它把"我习惯先写接口再写测试"这类隐性偏好显式化为带分数的数据对象,支持 /instinct-status 查看、/instinct-import 导入、/instinct-export 导出、/evolve 聚类、/prune 清理、/promote 提升为全局。这套机制的价值在于:它承认个人工作模式是资产,且资产可以被版本化、被分享。
统一记忆库的工程细节值得注意。常规搜索只召回 project 与 team 范围内状态为 active 的条目;user 范围必须显式请求;首版所有记忆保持 unreviewed,确认后的知识应进入受治理的项目文档而不是直接改信任字段。更关键的一条设计红线是:召回内容始终是不可信数据,不能作为指令执行。 这是对提示注入的正面防御,而不是事后补救。
并行化方面,仓库给出了 Git worktrees、级联方法与实例扩展时机三件套。什么时候该开第二个 worktree、什么时候级联会失控,文档里有明确判断标准——这类"何时不要做"的说明,比"如何做"更稀缺。
Token 优化则务实得多:模型选择策略、系统提示精简、后台进程管理,以及 strategic-compact 提供的上下文精简建议。作者在文末给的经验法则是:配置 20–30 个 MCP,每个项目启用少于 10 个,活动工具少于 80 个——因为工具开太多,200k 上下文窗口可能缩到 70k。
七、工具链与生态
npm 上挂着两个核心包:ecc-universal(运行时与安装器)和 ecc-agentshield(安全审计)。两者职责分明,前者管装配,后者管审查。
AgentShield 的规格在同类工具里属于偏重的:1282 项测试、98% 覆盖率、102 条静态规则,扫描范围覆盖 CLAUDE.md、settings.json、MCP 配置、钩子、智能体定义与技能模块,分密钥检测(14 种模式)、权限审计、钩子注入分析、MCP 服务风险评估、智能体配置审查五类。
# 快速扫描,无需安装
npx ecc-agentshield scan

# 自动修复 + 调用 3 个 Opus 4.6 智能体做对抗式深度分析
npx ecc-agentshield scan --fix --opus --stream

# 从零生成安全配置
npx ecc-agentshield init
发现严重问题时返回退出码 2,可直接当 CI 门禁用——这个小细节决定了它能否真正进入流水线,而不是停留在"本地跑一下看看"。
技能侧有两套生成路径:/skill-create 走本地 git 历史分析,零外部依赖;GitHub App 版本面向高级场景(万级提交、自动 PR、团队共享)。另外需要留意一个依赖关系:/multi-plan、/multi-execute、/multi-backend 等 multi-* 命令需要额外安装 ccg-workflow 运行时,否则无法正常工作——基础安装并不包含它。
社区侧目前已有 EVC 这类基于 ECC 构建的衍生项目,生态还处在早期但方向明确。
八、部署与安全
安装有两条路径,且明确互斥。最省事的是插件方式:
# 添加市场并安装
/plugin marketplace add https://github.com/affaan-m/ECC
/plugin install ecc@ecc

# 规则无法通过插件分发,需手动复制整个语言目录
git clone https://github.com/affaan-m/ECC.git
mkdir -p ~/.claude/rules
cp -R ECC/rules/common ~/.claude/rules/
cp -R ECC/rules/typescript ~/.claude/rules/

# 开始使用
/ecc:plan "添加用户认证"
README 里用加粗警告强调了一件容易被忽略的事:**如果已经用 **/plugin install** 装过 ECC,就不要再跑 ****install.sh --profile full**。插件已自动加载技能、命令与钩子,再执行完整安装会把同一批内容复制到用户目录,导致技能重复、钩子重复执行,甚至 ${CLAUDE_PLUGIN_ROOT} 解析失败。手动复制规则时也要复制整个语言目录而非目录内的单个文件,否则相对路径引用会断。
运行时可调参数有两个:ECC_HOOK_PROFILE(默认 standard)调整钩子严格度,ECC_DISABLED_HOOKS 用逗号分隔的 ID 列表临时禁用指定钩子。注意 multi-* 命令所需的 ccg-workflow 运行时不在基础安装范围内,钩子也会由 v2.1+ 自动加载——这两点是最常见的"装了但没生效"来源。
安全边界上还有两条硬约束:ecc-memory-mcp 必须由操作者设置小写 ECC_MEMORY_HARNESS 身份,工具调用方不能覆盖;user 范围记忆只有在操作者额外设置 ECC_MEMORY_ALLOW_USER_SCOPE=1 后才能被显式请求,且该服务默认不启用。记忆库运行时也不会随技能安装自动进入 PATH,必须单独 npm install -g ecc-universal。这些"默认关闭 + 显式开启"的设计取向,比任何安全宣传语都更能说明作者的态度。
九、适用场景
多语言技术栈的生产团队最直接受益——Go、Python、Rust、Kotlin、Flutter、Django、Laravel、Spring Boot 的审查与构建修复智能体都已内置,不必自己从零攒。
需要跨 Harness 复用配置的团队是另一类目标用户。当团队里有人用 Claude Code、有人用 Codex、有人用 Cursor 时,一份能同步的安装清单和统一记忆库能省掉大量重复沟通。
希望沉淀个人工作模式的独立开发者会喜欢本能学习这套机制——把"我总这么干"变成可导出、可复用、可演进的显式资产。
需要审计 AI 配置安全的组织则可以直接用 AgentShield 做 CI 门禁,尤其在 MCP 服务数量和权限范围失控的团队里。
反过来看,如果只是偶尔写几行脚本、对上下文窗口和钩子链毫无概念,ECC 的复杂度会成为负担而非助力。
十、总结评价
ECC 最值得肯定的地方,是它完成了一次身份跃迁:从"某人的 Claude Code 配置集合"变成"智能体 Harness 的操作系统"。判断标准很简单——它有安装清单、有运行时、有测试、有 CI、有发布可靠性校验(v2.2.3 里发布流程会等待 npm 最多五分钟再校验已发布包)。这些是把配置当产品做的标志,而不是把产品当配置晒的标志。
它的真正价值不在于 293 个技能里某一个有多聪明,而在于它把"研究优先、验证闭环、模式沉淀、记忆传递、默认拒绝"这几条工程纪律,变成了可以被安装、被继承、被审计的默认行为。安全方面尤其克制:记忆召回内容一律视为不可信数据,MCP 服务默认关闭,user 范围需要显式开关。这些选择在追求"开箱即用好用爽"的 AI 工具圈里是逆潮流的,但正确。
局限也很明确。第一,体量本身就是风险——293 个技能、数十个智能体,如果全量启用,上下文预算会被迅速吃掉,作者自己都提醒 MCP 要控制在 10 个以内。第二,强耦合于 Claude Code 的插件机制,v2.1 的钩子自动加载约定引发过多次"修复—回滚"循环,说明这个抽象层仍在移动,上游一变就得跟着改。第三,部分能力依赖外部运行时(ccg-workflow、ecc-memory-mcp),“装了不等于能用"的理解成本不低。第四,Rust 控制层 **ecc2** 仍标注为 alpha,把它当稳定基础设施为时尚早。
给一句务实的建议:先把 rules/common 和 search-first 用起来,跑通一轮规划—执行—验证,再逐步引入本能与记忆。这套系统的收益随使用深度增长,但它的复杂度也随启用广度增长——这两条曲线必须一起看。