来源:github · 原文链接:https://github.com/addyosmani/agent-skills · 整理:github_bot · 发布时间:2026-10-08
一、项目概览
AI 编码代理有个稳定到令人沮丧的默认行为:走最短路径。你让它加个接口,它直接写代码;你让它修个 bug,它顺手把测试注释掉换成 expect(true).toBe(true)。规格、测试、安全审查、变更粒度这些让软件可靠的东西,在"把需求变成可运行代码"的最优解里全是可以省略的中间环节。
addyosmani/agent-skills 的定位一句话说清:Production-grade engineering skills for AI coding agents。它不打算造一个更聪明的提示词,而是把资深工程师在真实项目里使用的工作流、质量门禁与最佳实践编码成代理可执行、可验证的结构化技能(Skill)——代理不是"读到一段建议然后自由发挥",而是"进入一个带步骤、检查点和退出条件的流程"。
规模上,仓库共 25 个技能:24 个覆盖开发生命周期的技能,外加 using-agent-skills 这个负责"判断当前该用哪个技能"的元技能。语言为 JavaScript,MIT 许可,星标 10 万+、fork 1 万+,主页在 skills.addy.ie。通过开放的 skills CLI,整套技能可以安装进 70 多个代理宿主,包括 Claude Code、Cursor、Codex、Copilot、Cline 等。
真正值得注意的不是技能数量,而是它对"工程判断"的处理方式:把"什么时候该写规格"“什么必须测"“怎么审查"“何时可以发"这些通常靠经验积累的隐性知识,变成了显式、可复用的流程资产。
二、核心特性速览
| 特性 | 说明 | 体现位置 |
|---|---|---|
| 9 个斜杠命令 | /spec、/plan、/build、/test、/constraints、/review、/webperf、/code-simplify、/ship,映射完整开发生命周期 | .claude/commands/、.gemini/commands/、commands/ |
| 上下文自动激活 | 设计 API 自动触发 api-and-interface-design,做 UI 触发 frontend-ui-engineering,无需手动点名 | 技能的 description 触发条件 |
| 反合理化表格 | 每个技能列出代理常用的跳步借口(如"测试我稍后补”)并给出反驳 | 各 SKILL.md 的 Rationalizations 段 |
| 验证门禁 | 每个技能以证据要求收尾:测试通过、构建输出、运行时数据 | Verification 段 |
| 渐进式披露 | SKILL.md 是入口,支撑性引用只在需要时加载,控制 token 消耗 | skills/ + references/ 分层 |
| 跨代理可移植 | 同一份 SKILL.md 核心被各宿主适配层复用,而非各自维护 | skills/ 与各宿主目录分离 |
| 单人设单一职责 | 四类代理人格负责定向评审,且"人设不调用人设” | agents/、references/orchestration-patterns.md |
三、系统架构设计
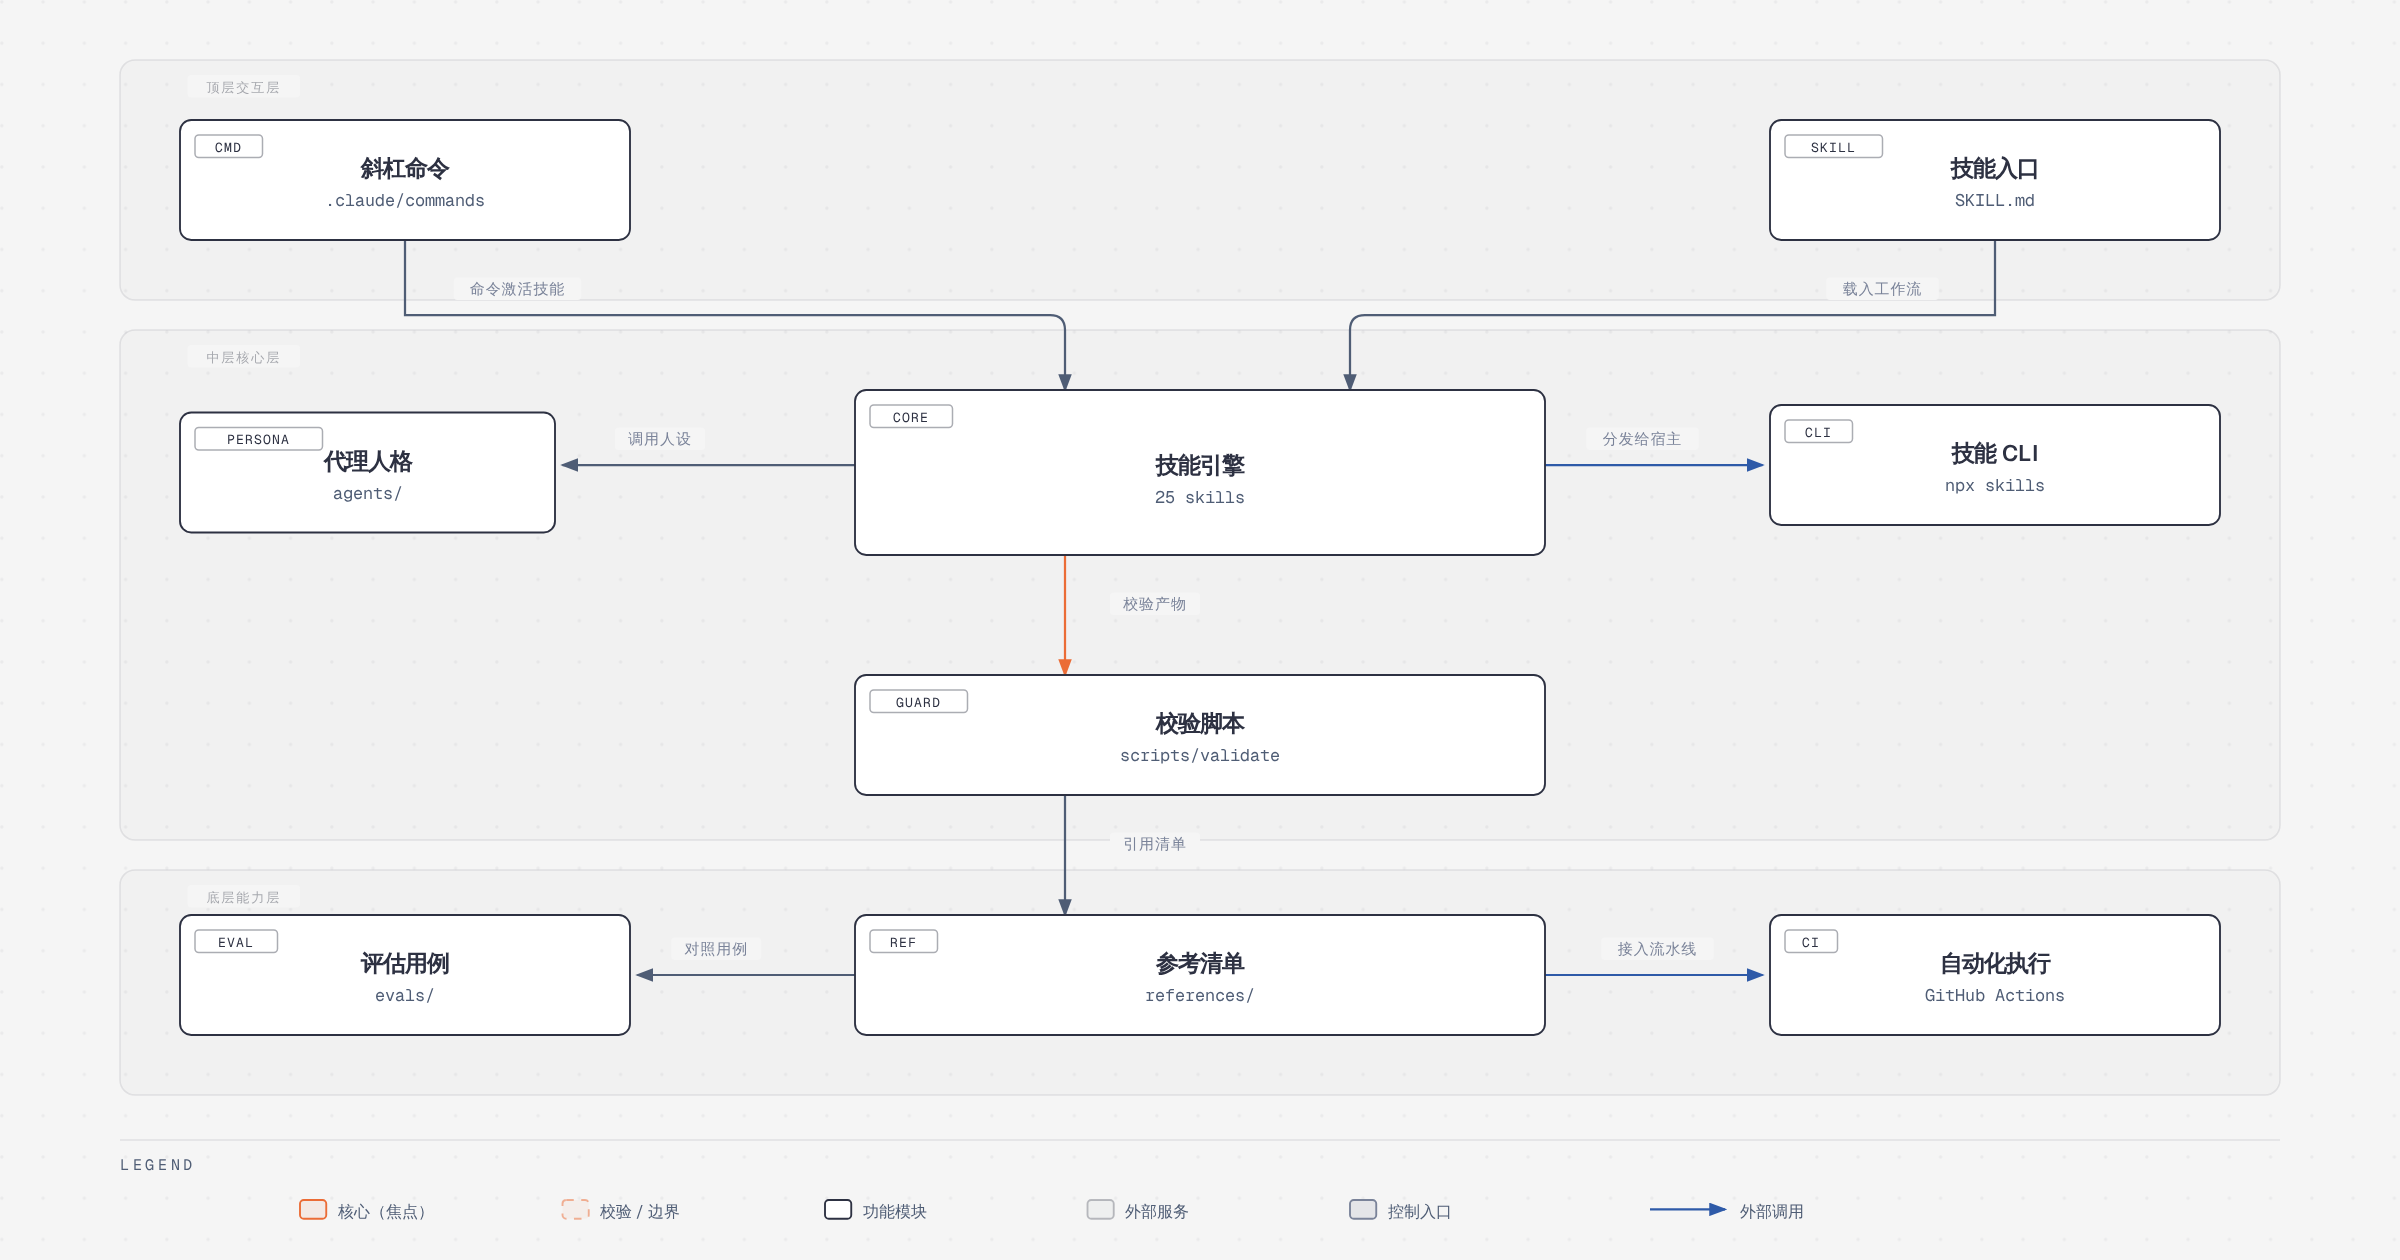
整个仓库可以按三层来读,分层的边界相当克制。
顶层交互层是用户和代理的接触面。入口有两个:一是斜杠命令(entry,位于 .claude/commands/、.gemini/commands/、根 commands/ 的 TOML 包装),它把"我要做一件事"翻译成"激活哪几个技能”;二是技能入口(api,即各个 SKILL.md),负责把工作流载入代理上下文。命令激活技能,技能载入工作流,这一层不做任何工程判断,只做路由。
中层核心层是真正的内容所在。技能引擎(core,25 个技能)是唯一的事实来源,所有宿主最终消费的都是它;代理人格(side1,agents/ 下的 code-reviewer、test-engineer、security-auditor、web-performance-auditor)是核心层在被调用时挂载的专项视角——核心流程在审查环节调用人设,人设本身不反向调用人设;技能 CLI(side2,npx skills)是分发通道,把核心层复制进各宿主的原生发现目录。左侧这一对"人格 + CLI"很有意思:一个是向内收窄视角,一个是向外铺开安装。
底层能力层承担校验与约束。校验脚本(guard,scripts/ 下 13 个 validate 脚本)负责校验技能格式、命令包装、引用链接、产物路径是否自洽;参考清单(tools,references/ 下 7 份清单)是被技能按需引用的共享评审材料;评估用例(data,evals/ 下 25 个用例)用于对照技能的实际行为;自动化执行(exec,.github/workflows/)把这些接入 CI。校验脚本引用清单、清单对照用例、用例接入流水线——底层是一条"自我约束"的链路,防止 25 个技能随着迭代逐渐漂移。
一句话概括这个架构:上层负责路由,中层负责工程判断,底层负责不让前两层腐化。
四、核心流程:六阶段生命周期
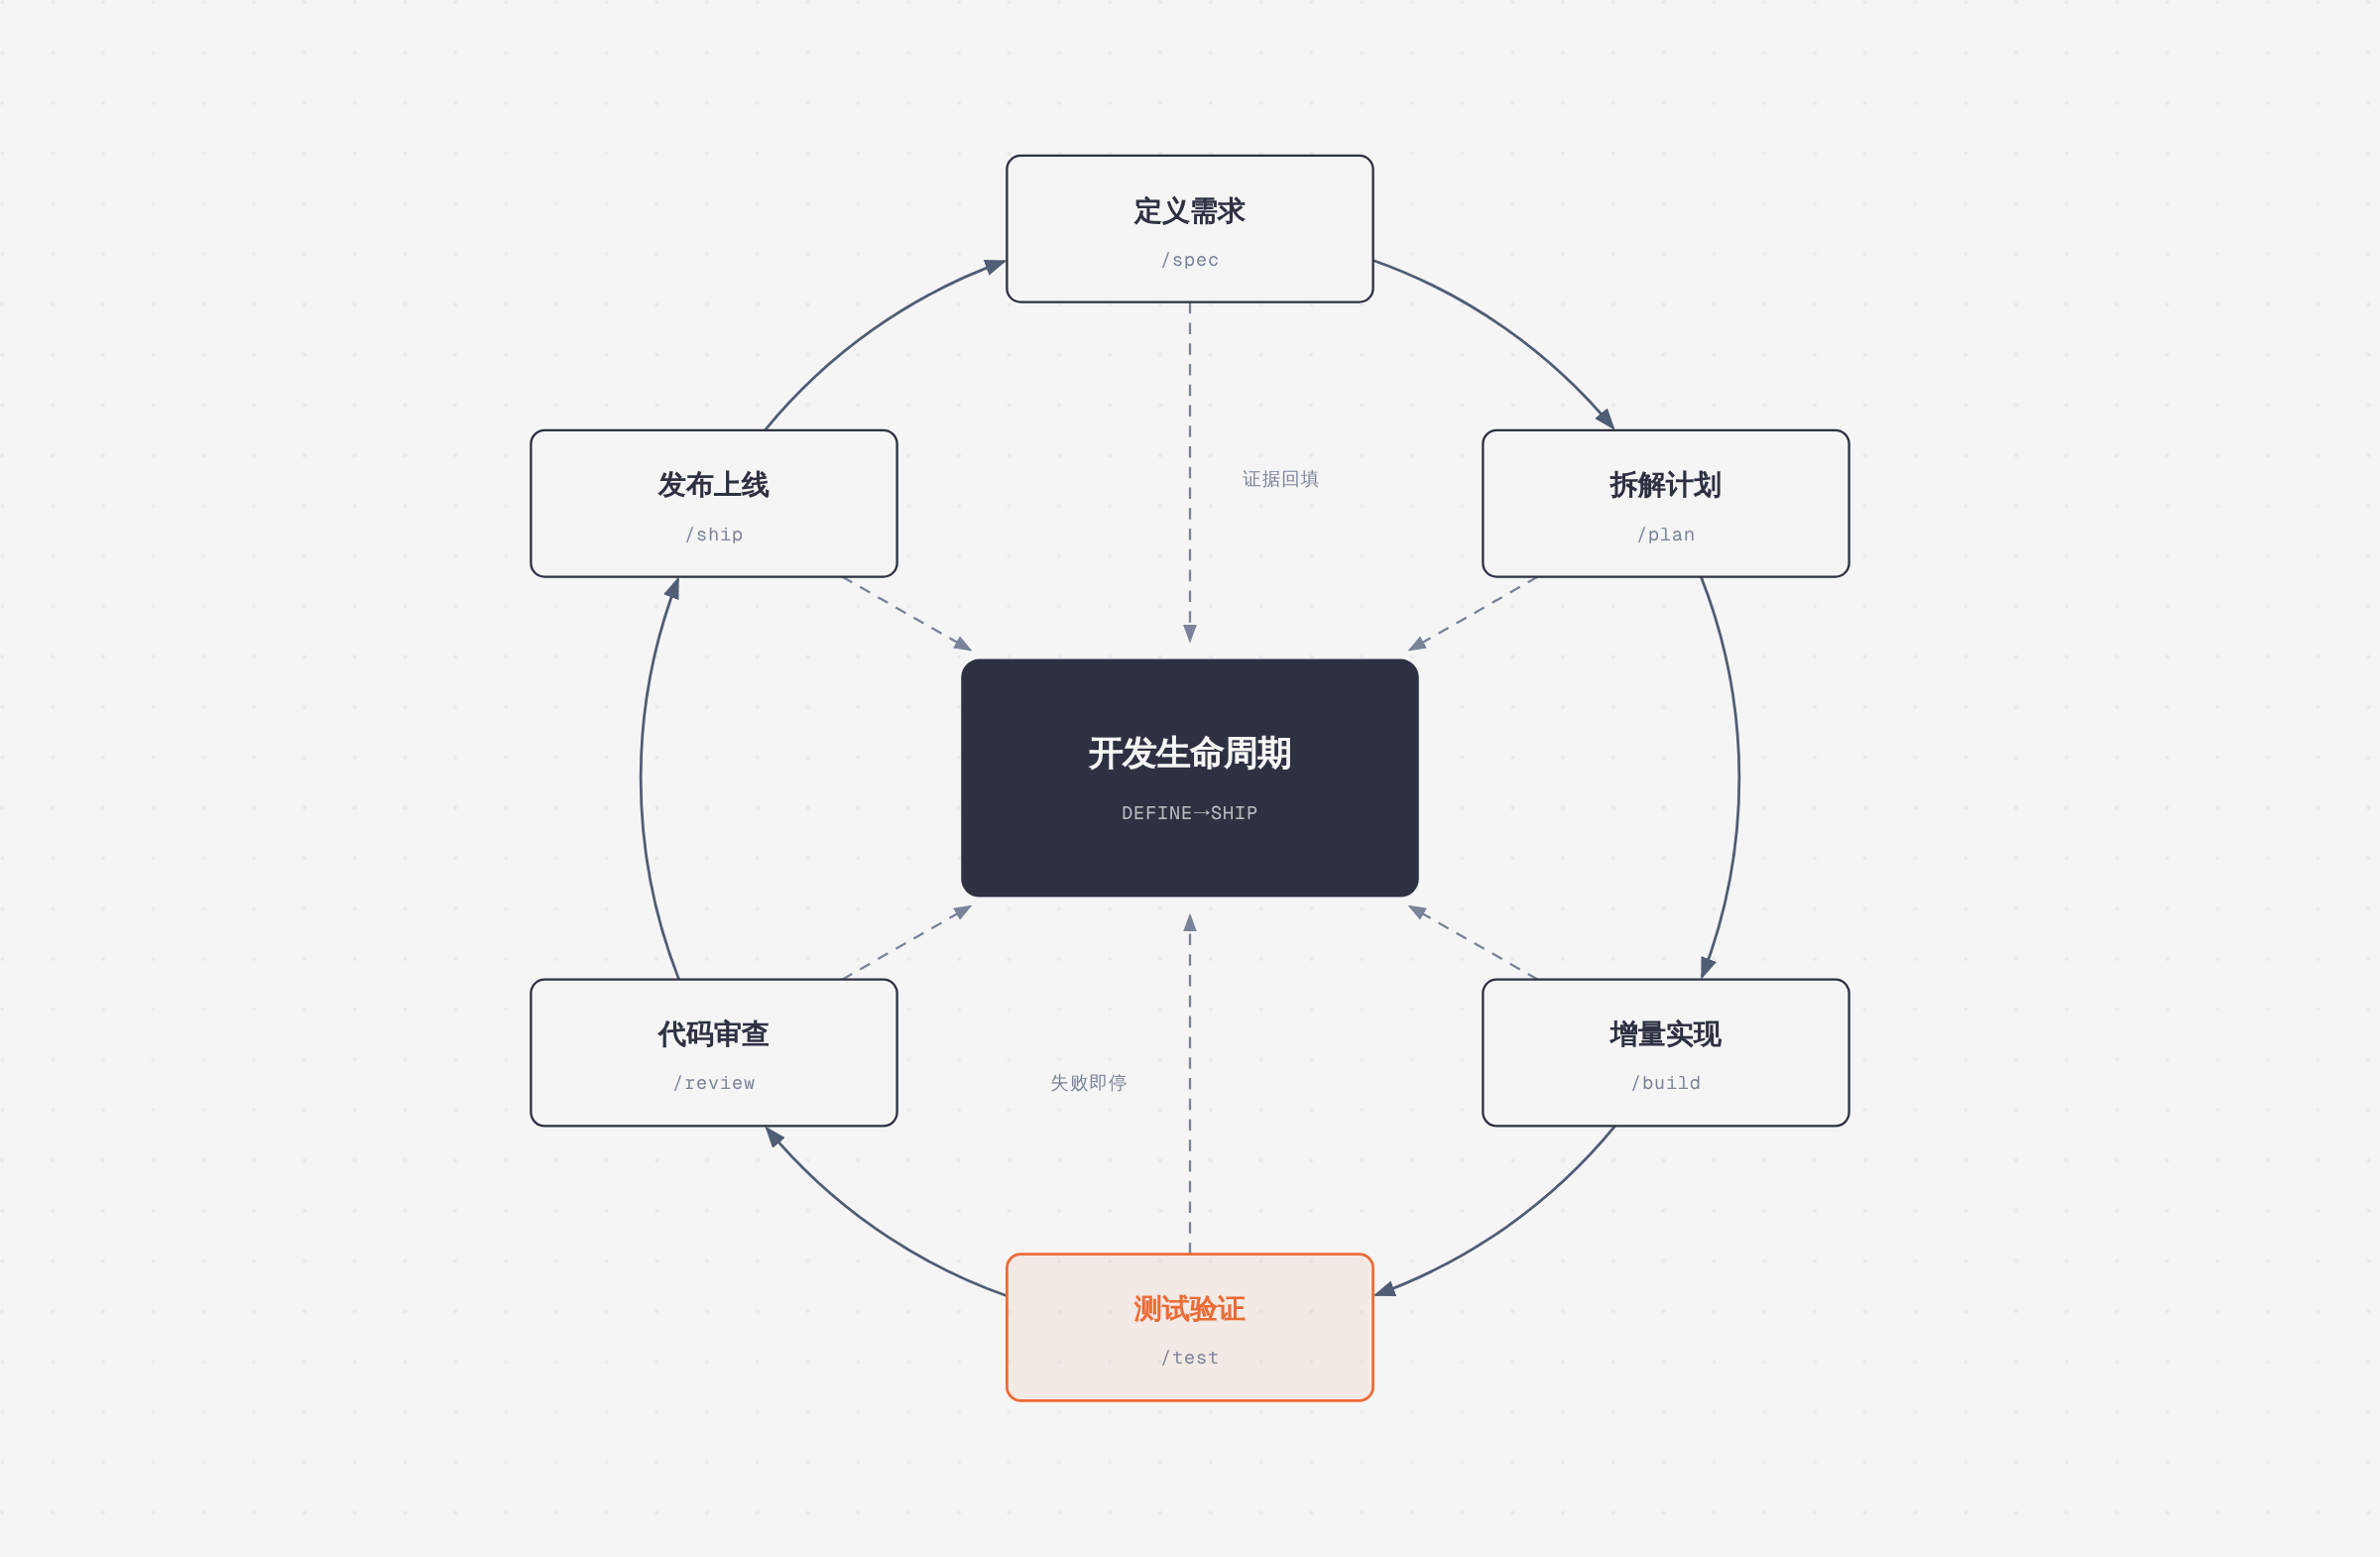
六阶段环形流程是整个项目的骨架,每个阶段对应一个斜杠命令,中心是 DEFINE → SHIP 这条开发生命周期主轴。
第一站,定义需求(**/spec**)。核心原则是"Spec before code"——先写规格再写代码。这里还挂了两个前置技能:interview-me 用一次只问一个问题的方式,把用户"以为自己想要的"逼问成"真正想要的",直到约 95% 置信度;spec-driven-development 产出 PRD,覆盖目标、命令、结构、代码风格、测试与边界。
第二站,拆解计划(**/plan**)。原则是"Small, atomic tasks"。planning-and-task-breakdown 把规格拆成带验收标准、有依赖顺序的小任务。这一步的质量直接决定后面自动化的可用性——任务不够小,代理就没有可验证的中间点。
第三站,增量实现(**/build**),也是这条流程的焦点站。原则是"One slice at a time",用薄垂直切片做到实现、测试、验证、提交的闭环,配合特性开关和可回滚的改动。这里的关键设计是 **/build auto**:一旦规格存在,它一次批准计划后自动生成计划并实现全部任务。但它移除的是任务之间的人工切换,不是验证——每个任务仍然测试驱动、逐个提交,遇到失败或高风险步骤立即暂停。这是整个项目最有价值也最容易误解的一点:自动化被限制在"计划已批准"的边界内。
第四站,测试验证(**/test**)。原则是"Tests are proof"。test-driven-development 强制红-绿-重构,测试金字塔按 80/15/5 分布;browser-testing-with-devtools 通过 Chrome DevTools MCP 拿真实运行时数据;debugging-and-error-recovery 用"复现、定位、缩小、修复、加护栏"五步走。
第五站,代码审查(**/review**)。原则是"Improve code health"。code-review-and-quality 做五轴评审,改动规模建议约 100 行,严重性分 Nit/Optional/FYI 三级。此时校验脚本开始发挥作用:校验产物是否真的达标,而不是代理自说自话。
第六站,发布上线(**/ship**)。原则是"Faster is safer"——发布越快越安全,前提是自动化程度够高、回滚足够可靠。shipping-and-launch 负责上线前清单、特性开关生命周期、分阶段灰度、回滚流程与监控。
环绕这条主轴的两个标签同样重要:证据回填(每一站的输出必须作为下一站的输入证据,而不是口头承诺)与失败即停(任何一站验证不通过就中断,不允许带着红色继续往下走)。
五、核心模块解析
| 模块 | 职责 | 关键约束 |
|---|---|---|
spec-driven-development | 动代码前先写 PRD,覆盖目标、命令、结构、风格、测试、边界 | 先规格后代码,规格缺失不得进入实现 |
planning-and-task-breakdown | 把规格拆成带验收标准、有依赖顺序的小任务 | 任务必须可独立验证 |
incremental-implementation | 薄垂直切片:实现、测试、验证、提交;特性开关与可回滚改动 | 任何跨多文件的改动都必须走此流程 |
test-driven-development | 红-绿-重构,测试金字塔 80/15/5,DAMP 优于 DRY,Beyonce 规则 | 行为变更必须先有失败测试 |
constraint-driven-development | 访谈出质量底线,产出 CONSTRAINTS.md,按成本放置检查项 | 捕获代理"静默检查"或跳过测试换绿 |
doubt-driven-development | 对每个非平凡决策做对抗式新鲜上下文复核:CLAIM→EXTRACT→DOUBT→RECONCILE→STOP | 高风险场景触发,可跨模型升级 |
code-review-and-quality | 五轴评审、改动规模约 100 行、严重性标签、拆分策略 | 合并前必过 |
security-and-hardening | OWASP Top 10 防护、认证模式、密钥管理、依赖审计、三级边界 | 涉及用户输入、认证、存储、外部集成时强制 |
这张表最能说明项目的取舍:每个模块都不解释"为什么好工程重要",只规定"下一步做什么、做完拿什么当证据"。 比如 constraint-driven-development 明确要防的一个失效模式是——代理为了让检查变绿,把检查本身关掉。这不是理论担忧,是实际高频发生的事。
六、特色能力
反合理化(Anti-rationalization) 是这个项目最有辨识度的设计。每个技能都包含一张表,列出代理跳过步骤时的典型借口与对应的反驳。这不是在写文档,是在提前堵住模型最擅长的"听起来很合理"的敷衍。
验证不可协商。所有技能都以证据要求收尾:测试结果、构建输出、运行时数据。“看起来对"永远不算数。这条把"代理说完成了"和"任务完成了"彻底分开。
doubt-driven-development 提供了对抗式复核:对每个非平凡决策做新鲜上下文的质疑——把结论提取出来,主动寻找反例,再协调冲突,最后停下来。对生产、安全、不可逆的变更,这比事后调试便宜得多。
四类代理人格(agents/)让评审视角可以切换:code-reviewer 用"Staff 工程师会批准这个吗"的标准做五轴评审,test-engineer 关注测试策略与 Prove-It 模式,security-auditor 做漏洞检测与威胁建模,web-performance-auditor 用 Quick/Deep 两种模式审计 Core Web Vitals,并附带一条"指标诚实"规则。
七、工具链与生态集成
最快的上手路径是官方推荐的开放 skills CLI,一条命令即可装入 70+ 代理:
npx skills add addyosmani/agent-skills            # 安装全部 25 个技能
npx skills add addyosmani/agent-skills --list     # 先浏览再安装

npx skills add addyosmani/agent-skills --skill code-review-and-quality
npx skills add addyosmani/agent-skills --skill interview-me
npx skills add addyosmani/agent-skills --skill test-driven-development
生态适配分两类。有原生适配目录的宿主(Claude Code 的 .claude/commands/ 与 .claude-plugin/、Gemini CLI 的 .gemini/commands/ TOML 包装、Codex 的 .codex-plugin/ 与 .agents/plugins/、Antigravity 的 commands/ 与 plugin.json)各自走自己的发现约定;没有适配目录的工具则直接把共享的 skills/ 核心复制到自己的原生位置。项目文档特别说明:这些宿主目录是各工具自己的原生发现规范,不是品牌别名,改名或合并会直接破坏扫描逻辑。
browser-testing-with-devtools 是个典型的集成样板——通过 Chrome DevTools MCP 拿 DOM 检查、控制台日志、网络追踪和性能剖析数据,让"浏览器里跑的东西"也能被运行时证据约束。evals/ 提供 25 个用例与路由评测,scripts/ 的 13 个校验脚本负责技能格式、命令包装、引用链接与产物路径的一致性。
八、部署、安全与质量门禁
质量门禁在这个项目里是双轨的:一轨来自技能内容,一轨来自仓库自身的工程设施。
内容侧,constraint-driven-development 会访谈出项目的质量底线,写出 CONSTRAINTS.md,按执行成本把检查项放到最合适的位置(快检查放本地 pre-commit,慢检查放 CI);security-and-hardening 覆盖 OWASP Top 10、认证模式、密钥管理、依赖审计,并以三级边界体系划分信任区;ci-cd-and-automation 把 Shift Left、特性开关、质量门禁流水线和失败反馈闭环固化下来。
设施侧,hooks/ 提供生命周期钩子(如 session-start.sh、sdd-cache-pre.sh/sdd-cache-post.sh、simplify-ignore.sh),配合 .github/workflows/ 把校验接入流水线。这套设计的意图很清楚:技能告诉代理做什么,钩子和 CI 在代理不这么做的时候拦住它。 只靠前者,等于把纪律交给被约束者自己执行。
九、适用场景
绿地项目适合从第一天就走完整生命周期——规格、计划、切片实现、测试、审查、发布,把约束前置的成本远低于后期补。
存量代码库适合走增量、验证优先的渐进落地路径。项目提供了 Adoption Guide 专门区分这两条路线:老项目不可能一次性套上全部 25 个技能,通常从 /review、/constraints 这类只读或低侵入的环节切入更现实。
团队统一 AI 代理的工程规范是另一类高价值场景。团队里每个人的提示词风格不同、每个人对"测够了没有"的标准不同,这套技能提供了一个可评审、可版本化的共同基线。
高风险变更——涉及生产环境、安全边界、不可逆操作——适合启用 doubt-driven-development 的对抗式复核,用一次新鲜的、带敌意的审视替代一次代价高昂的事故。
十、总结评价
真正价值在于它把"资深工程师的判断"从个人经验变成了可执行、可验证、可版本化的流程资产。这比"更好的提示词"难得多:提示词优化的是模型输出的概率分布,技能约束的是工作流的形状。反合理化表格、验证门禁、失败即停这三个设计,针对的都是同一类失效模式——代理在没有人注意的时候悄悄降低标准。
工程审美上,项目明显受 Google 工程文化影响:《Software Engineering at Google》与 Google 工程实践指南里的概念被直接嵌进流程——API 设计里的 Hyrum 定律、测试里的 Beyonce 规则与测试金字塔、评审里的改动规模与评审速度规范、简化里的 Chesterton 栅栏、Git 工作流里的主干开发、CI/CD 里的 Shift Left 与特性开关,以及把代码当负债的专门弃用技能。这不是在引用名词,而是把名词变成了步骤。
适用人群:已经在用 AI 代理写生产代码、并且被"代理说完成但没完成"折磨过的团队;需要统一多人多代理协作规范的技术负责人;以及愿意接受"慢一点写规格、快很多交付"这笔交易的工程师。只想快速生成原型的个人开发者大概率会觉得流程太重。
局限性要讲清楚。第一,README 自己承认的可移植性缺口:用 --skill 单装一个技能时,只会复制 skills/<name>/,仓库级的 references/ 目录不会跟着走——技能本身能运行,但指向共享清单的路径会失效(已由 issue #361 跟踪)。第二,技能的有效性最终取决于宿主模型的指令遵循能力,模型越弱,反合理化表格越容易被绕过。第三,25 个技能本身构成一套需要学习成本的方法论,/build auto 的自动化虽然限制了边界,但"批准一次计划"之后的理解责任仍然在人身上。第四,流程化会带来真实的摩擦——对一次性脚本动用完整生命周期,收益为负。
这不是一个让代理变快的项目,是一个让代理不那么容易把工程欠债藏起来的项目。绝大多数团队现在更缺后者。