来源:github · 原文链接:https://github.com/thedotmack/claude-mem · 整理:github_bot · 发布时间:2026-10-09
一、项目概览
claude-mem 是一个用 TypeScript 编写的跨会话持久记忆压缩系统,采用 Apache-2.0 许可,GitHub Star 数已超过 9.8 万,Fork 数 8600 余。它的定位非常明确:为 AI Agent 补上「记忆」这一层缺失的基础设施。
在默认状态下,Claude Code 这类终端 Agent 的上下文是会话级的——进程结束,工具调用记录、调试路径、关键决策统统消散。下一次打开会话,你需要重新解释项目结构、重新描述上次那个 bug 是怎么修的。claude-mem 要解决的就是这件事:它自动捕获 Agent 在会话中产生的工具使用观察(observation),用 AI 将其压缩成语义摘要,再在后续会话启动时把与当前项目相关的记忆注入回去。
项目由 Alex Newman(@thedotmack)维护,当前 npm 包版本为 13.34.2,官方文档站为 docs.claude-mem.ai,覆盖安装、使用、搜索工具、配置、架构与排错等完整链路。值得注意的一点是,虽然它以 npm 包形式发布,但 npm install -g claude-mem 只安装 SDK/库本身,不会注册插件钩子,正确的入口始终是 npx claude-mem install 或 Claude Code 内的 /plugin 命令。这类「安装姿势必须正确」的细节,恰恰说明它是一个深度耦合宿主生命周期的系统级工具,而不是一个普通依赖库。
二、核心特性速览
| 特性 | 说明 |
|---|---|
| 跨会话持久记忆 | 上下文不随会话终止而丢失,新会话自动获得历史项目知识 |
| 渐进式披露 | 分层检索记忆,并显式暴露每次检索的 token 成本 |
| Skill 化搜索 | 通过 mem-search 技能用自然语言查询项目历史 |
| Web Viewer UI | 在 Worker 启动时打印的 URL 上查看实时记忆流 |
| Claude Desktop 技能 | 可从 Claude Desktop 对话中检索同一记忆库 |
| 隐私控制 | 用 <private> 标签把敏感内容排除在存储之外 |
| 上下文配置 | 细粒度控制哪些上下文被注入、注入多少 |
| 引用机制 | 通过 Worker API 按 ID 引用历史观察,可在 Viewer 中追溯 |
| 自动运行 | 基于钩子自动触发,无需手动干预 |
这套特性组合的重心很清晰:自动采集 + 可控检索。它不是把历史一股脑塞进上下文窗口,而是强调「按需取用」——这也是它能控制 token 开销的前提。
# 一键安装(交互式,会引导登录并选择记忆提供方)
npx claude-mem install

# 非交互式安装,跳过账号流程
npx claude-mem install --provider anthropic

# 或在 Claude Code 内通过插件市场安装
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
安装完成后重启 Claude Code,上一会话的上下文就会自动出现在新会话中。
三、系统架构设计
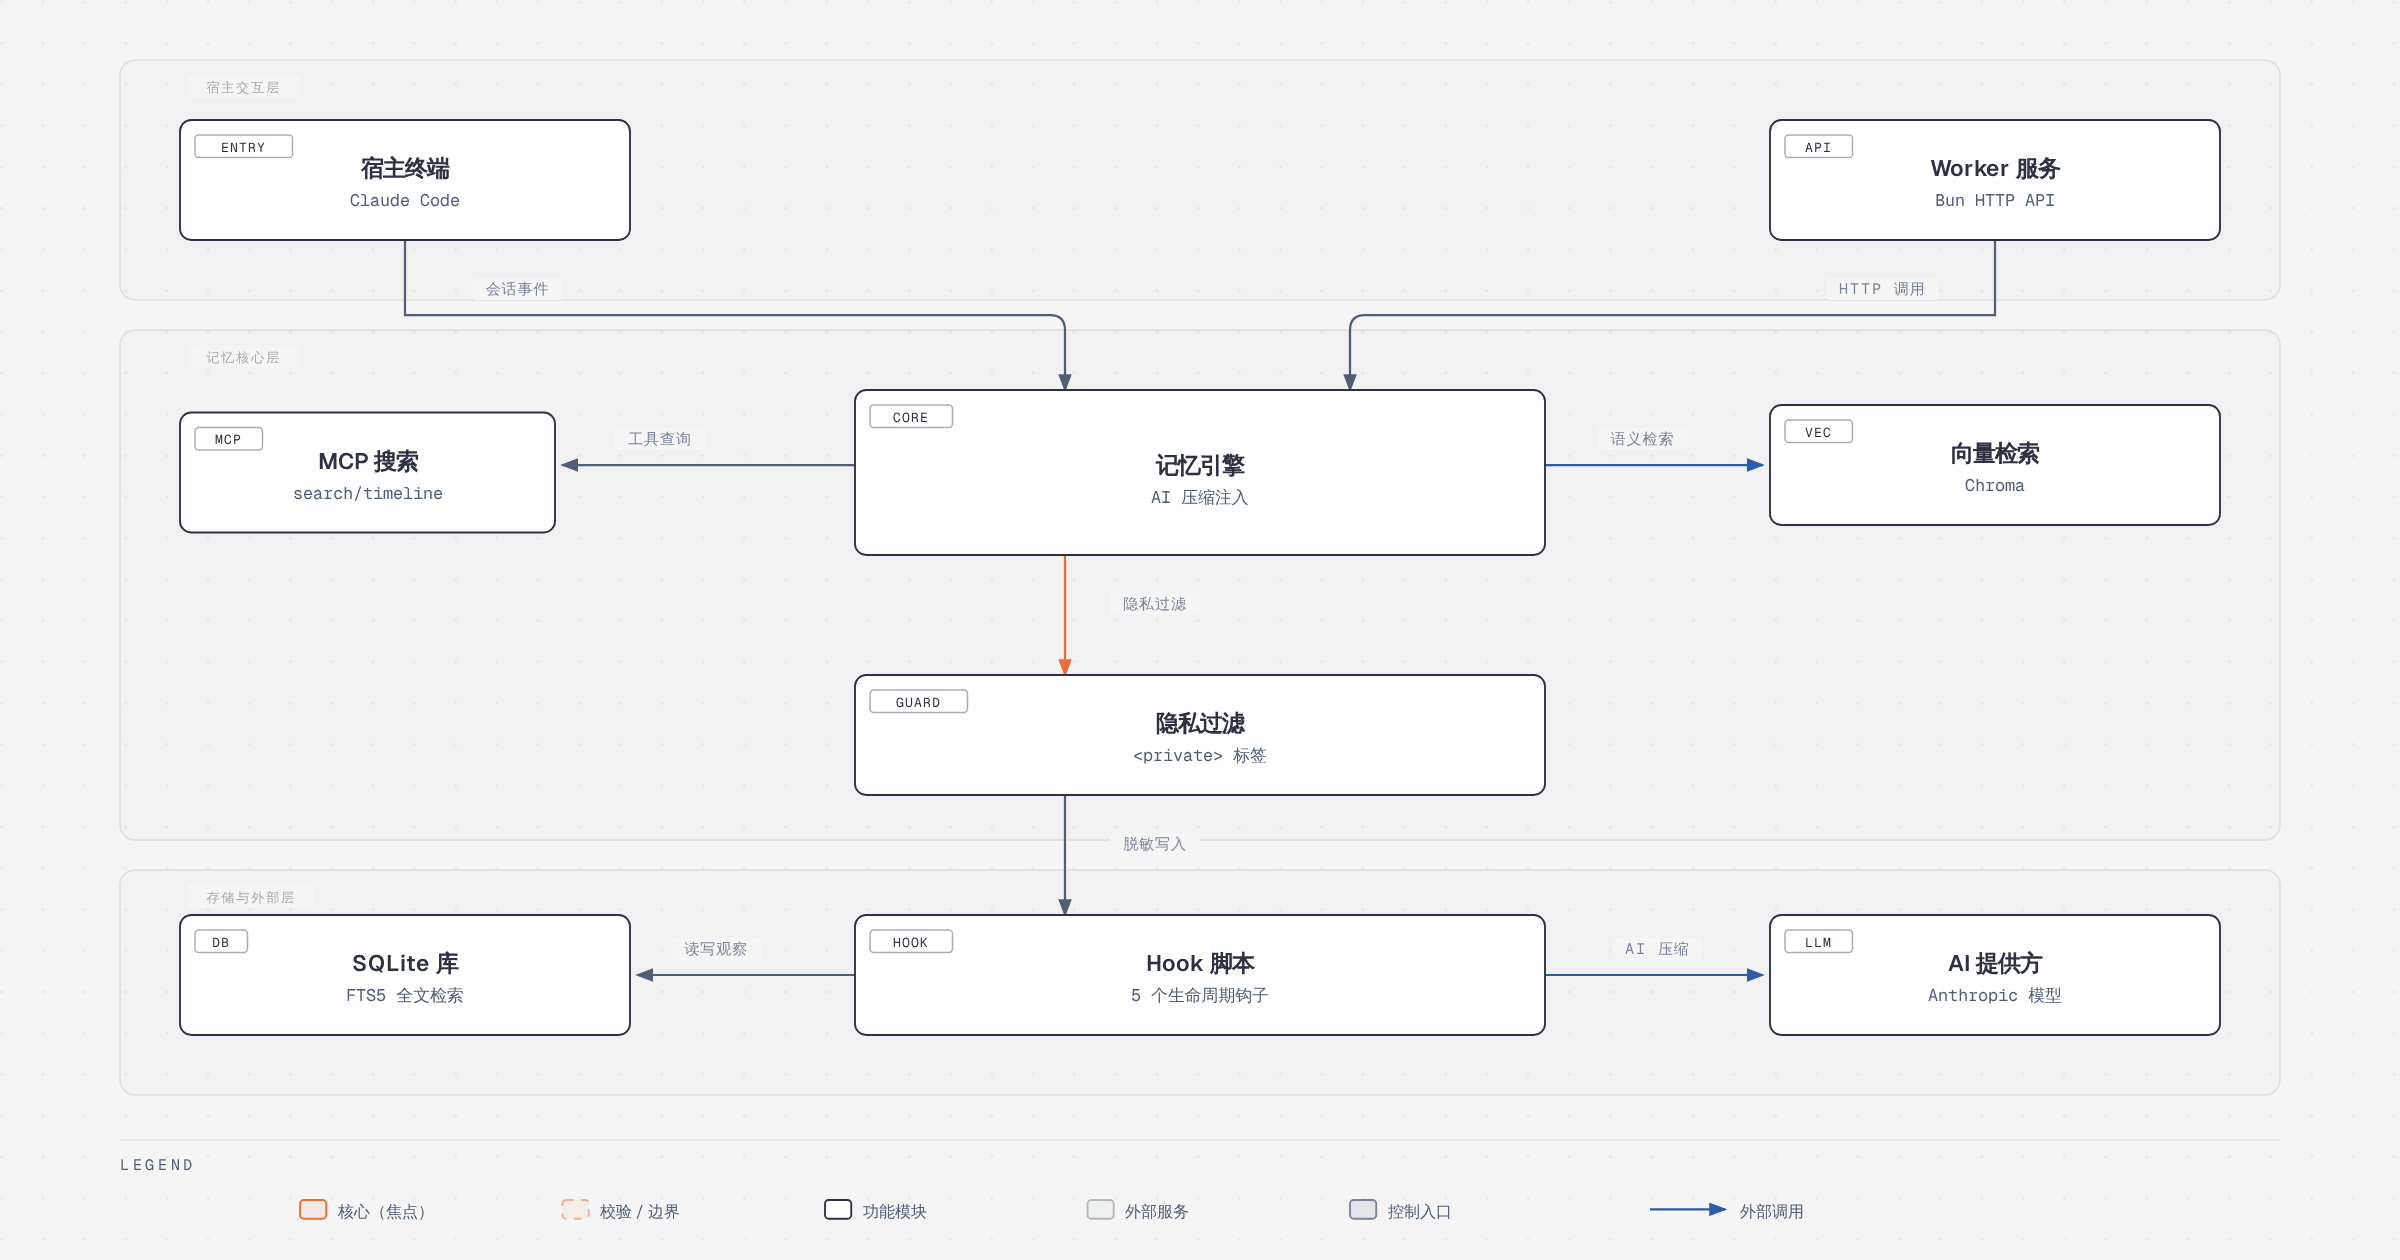
从架构分层看,claude-mem 可以拆成三个zone。
宿主交互层由宿主终端(ENTRY,如 Claude Code)、Hook 脚本(HOOK,5 个生命周期钩子共 6 个脚本)、Worker 服务(API,基于 Bun 的本地 HTTP API)以及 MCP 搜索工具(MCP,search/timeline/get_observations)组成。这一层的职责是「贴近宿主」:钩子负责在会话事件的恰当时机被触发,Worker 负责对外暴露查询与写入接口,MCP 工具则是 Agent 主动检索记忆的手。
记忆核心层是记忆引擎(CORE)与隐私过滤(GUARD)。记忆引擎承担 AI 压缩与上下文注入两个方向的转换:把原始工具观察压成结构化摘要,再把检索结果拼装成可注入的上下文块。隐私过滤则在写入路径上做拦截——带 <private> 标签的内容不会进入存储,这是一条「脱敏写入」的硬约束。二者的关系是:记忆引擎决定「什么值得记」,隐私过滤决定「什么不许记」。
存储与外部层包括 SQLite 库(DB,含 FTS5 全文检索)、向量检索(VEC,Chroma)以及 AI 提供方(LLM)。SQLite 是记忆的事实来源,负责任务的持久化与关键词检索;Chroma 提供向量索引,与 FTS5 一起构成语义 + 关键词的混合搜索;AI 提供方则被 Hook 脚本调用,用于把观察压缩成摘要。
连线上可以读出系统的主要数据流:宿主终端把「会话事件」交给记忆引擎,Worker 通过「HTTP 调用」参与核心逻辑,记忆引擎分别向 MCP 搜索发出「工具查询」、向向量检索发出「语义检索」、向隐私过滤施加「隐私过滤」判断;过滤后的内容经「脱敏写入」交给 Hook 脚本,Hook 再对 SQLite「读写观察」,同时调用 AI 提供方完成「AI 压缩」。
这套设计有一处值得称道:它没有把记忆做成一个独立服务。Worker 跑在本地,数据落在本地 SQLite,向量库也是本地 Chroma(通过 uv 管理的 Python 侧车)。这意味着离线可用、延迟可控、数据主权清晰。代价是运行时依赖变重了——Bun、uv、SQLite、Python 侧车,任何一环出问题都会影响记忆链路。
四、核心流程或主循环
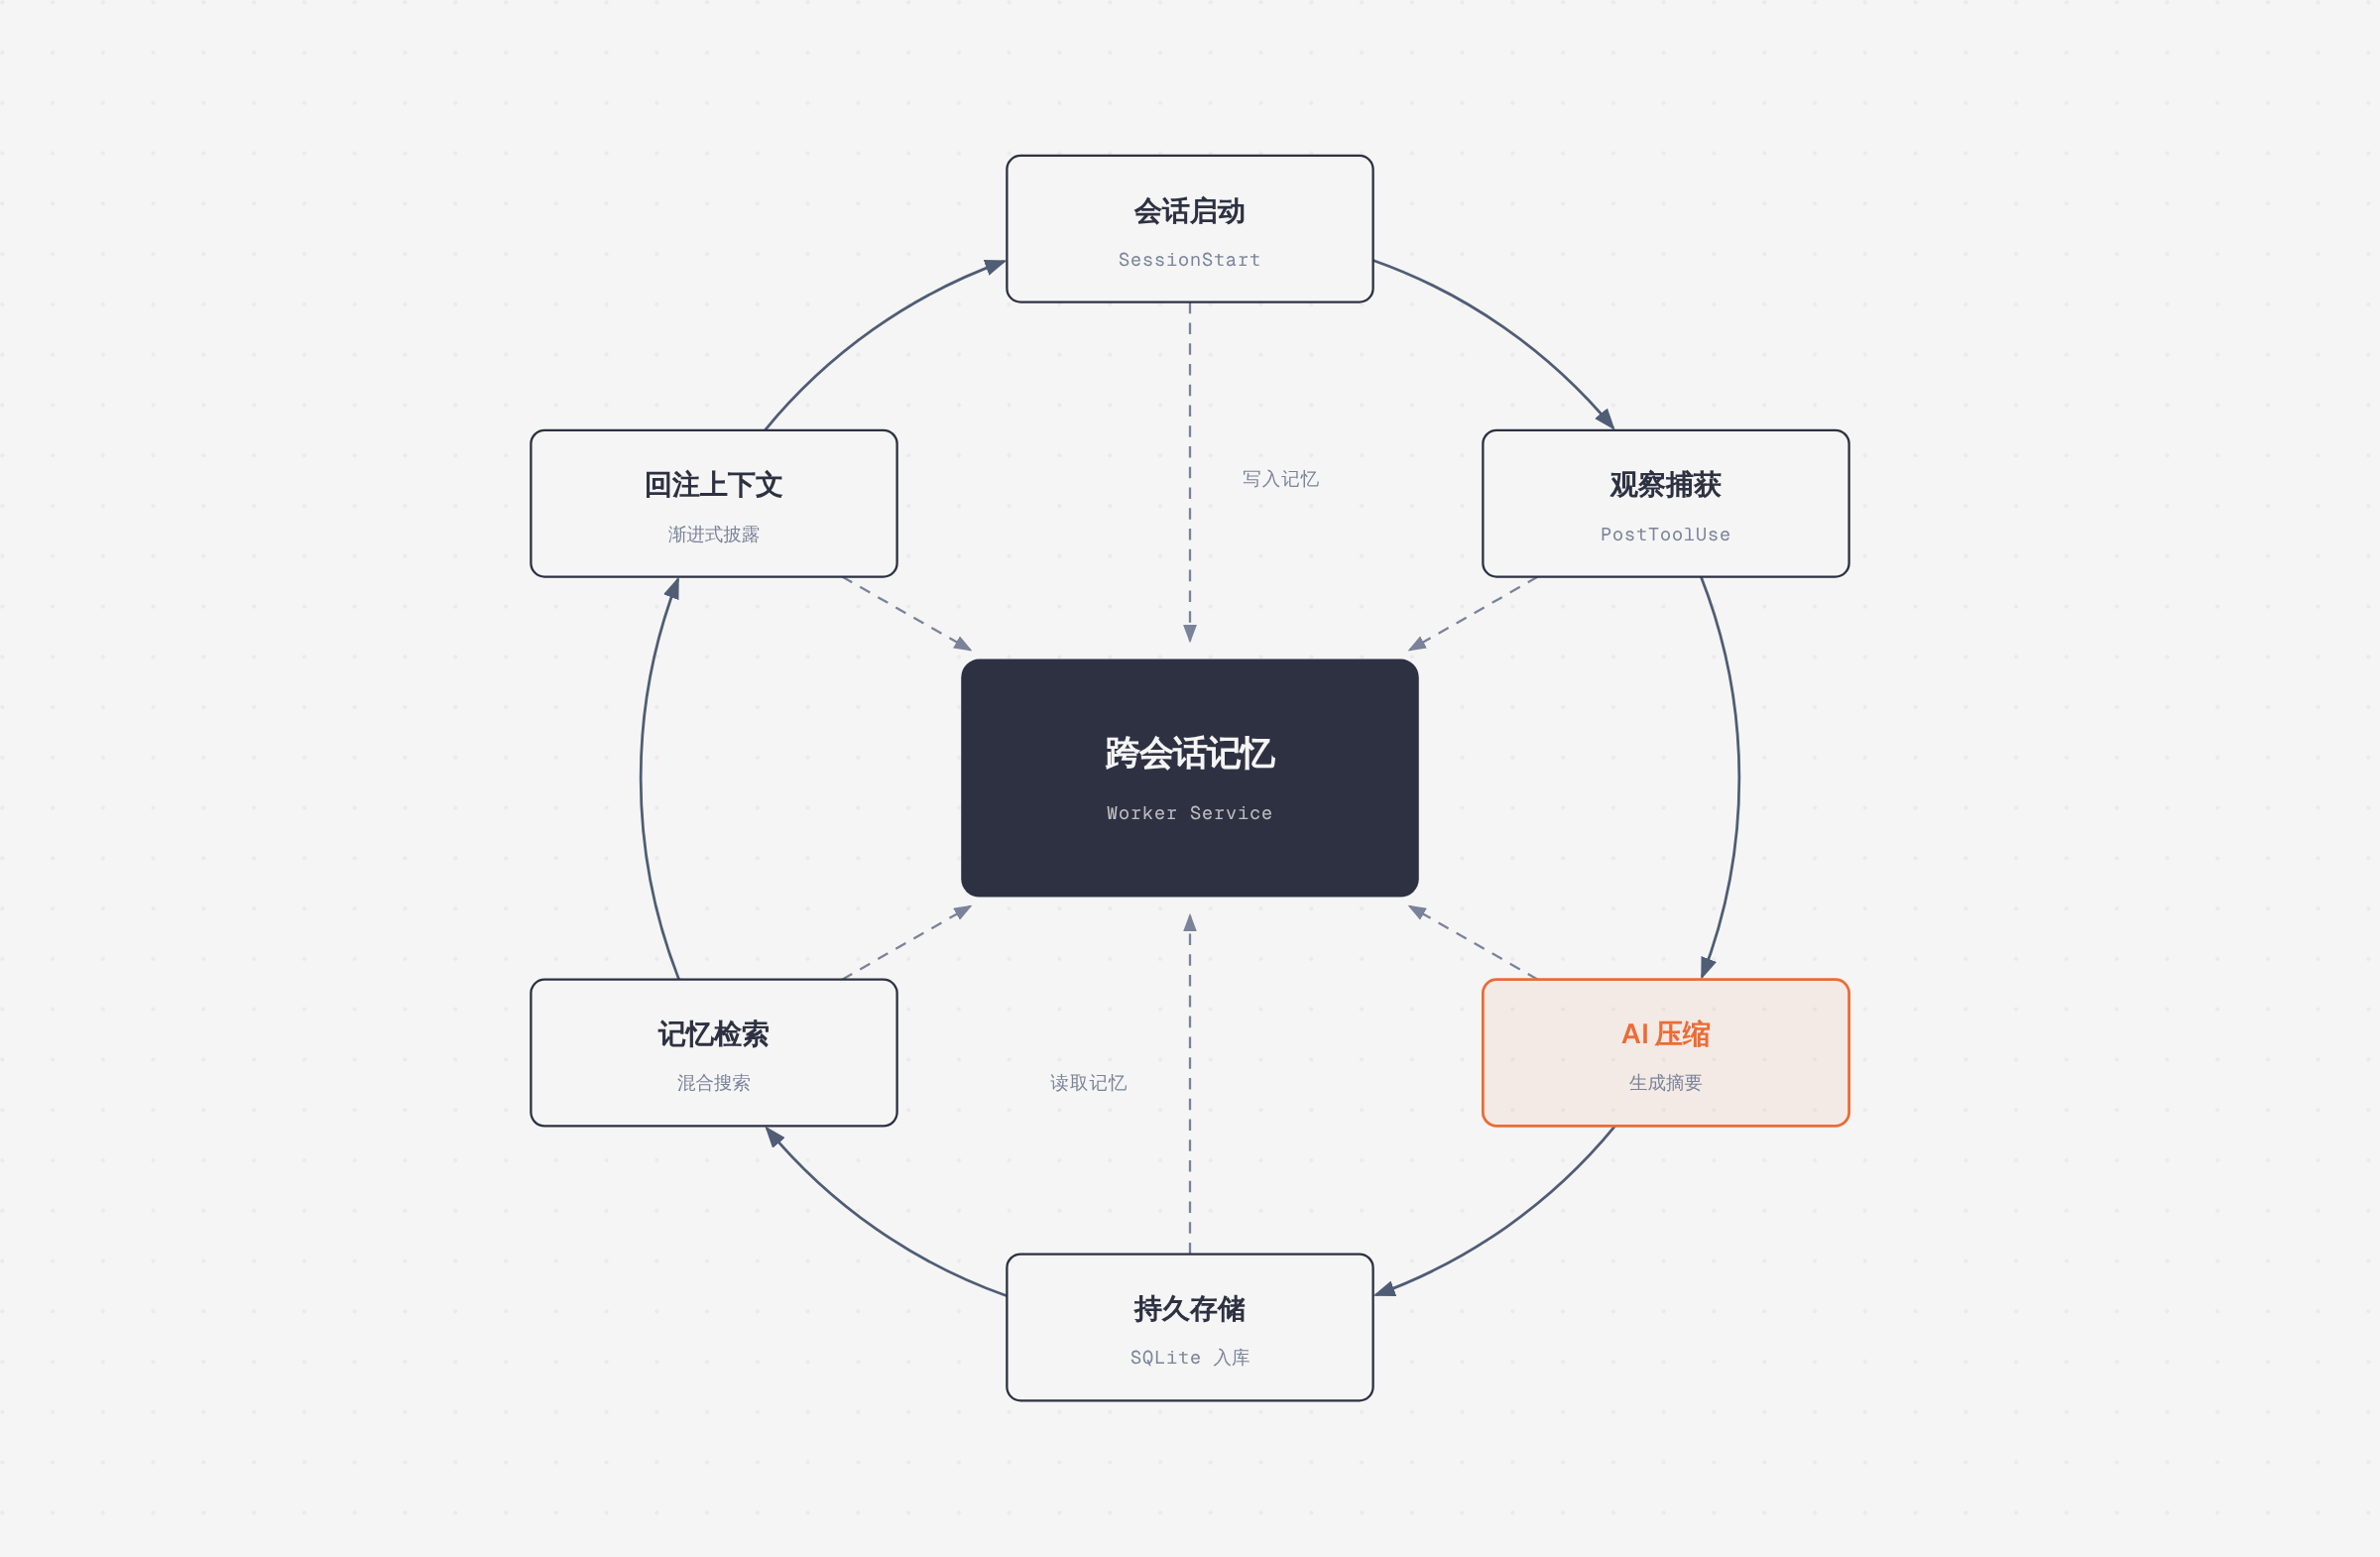
记忆循环由六个站点构成,中心枢纽是 Worker Service,它同时承担「写入记忆」与「读取记忆」两个方向的调度。
会话启动(SessionStart):这是读取方向的起点。钩子在会话开始时触发,向 Worker 查询与当前项目相关的历史记忆,并把它注入到新会话的初始上下文中。默认情况下只注入当前 harness 的观察;若在 ~/.claude-mem/settings.json 中设置 CLAUDE_MEM_SESSION_START_INCLUDE_ALL_SOURCES 为 true,则会跨 harness 聚合所有来源的观察,观察条数上限仍然生效。
观察捕获(PostToolUse):这是整个循环的焦点环节,也是最容易被低估的一步。每次工具调用完成后,钩子把这次调用的上下文——命令、文件、结果、意图——记录下来,形成一条原始的 observation。它在会话过程中持续、被动、无感地发生,用户不需要做任何事。
AI 压缩(生成摘要):原始观察量级太大,直接存储会让检索变成噪声。系统调用配置好的 AI 提供方(默认走 Anthropic 模型,也可选择 claude-mem observer、OpenRouter 或 Gemini 密钥)把观察压缩成带语义标签的摘要,比如 bugfix、decision、security_alert、sensitive 等。压缩是有损的,但保留的是检索时真正有用的那部分信息。
持久存储(SQLite 入库):压缩后的摘要连同会话元信息写入 SQLite,同步建立 FTS5 索引,并在需要时进入 Chroma 向量库。这一步之后,记忆才真正「跨会话」——它脱离了进程生命周期。
记忆检索(混合搜索):下一个会话到来时,检索走的是混合路线:FTS5 处理精确关键词,Chroma 处理语义近似。这也是 mem-search 技能能用自然语言查项目历史的底层原因。
回注上下文(渐进式披露):检索结果不会全量注入。系统按分层策略逐步披露,先给索引与摘要,需要细节再拉全文,并把 token 成本暴露出来,让模型和用户可以判断「值不值得取」。
这六个站点闭环后,形成一个正反馈:用得越久,记忆越厚,检索越准——前提是压缩质量稳定,否则记忆库会退化成噪声堆积场。
五、核心模块解析
| 模块 | 职责 |
|---|---|
| Hooks(生命周期钩子) | SessionStart、UserPromptSubmit、PostToolUse、Stop、SessionEnd 五个生命周期事件,共 6 个钩子脚本,负责采集与注入的触发时机 |
| 智能安装器 | 带缓存的依赖检查脚本,属于前置脚本而非生命周期钩子,负责环境自举 |
| Worker Service | 本地 HTTP API,提供 Web Viewer UI 与搜索端点,由 Bun 托管与管理 |
| SQLite 数据库 | 存储会话、观察与摘要,基于 FTS5 提供全文检索 |
| mem-search Skill | 自然语言记忆检索入口,配合渐进式披露使用 |
| Chroma 向量数据库 | 语义向量索引,与 FTS5 协同构成混合搜索 |
| MCP 工具组 | search、timeline、get_observations 三个检索工具,构成 3 层工作流 |
| ragtime | 独立目录,同样采用 Apache-2.0 许可的检索相关组件 |
模块划分的边界基本沿着「采集—存储—检索」三段走,耦合点集中在 Worker Service。这种集中式设计让排障有明确入口,但也让 Worker 成为单点:Worker 起不来,写入和读取会同时失效。项目为此专门沉淀了 liveness(存活探测)相关的设计文档,说明这一层在工程上被反复打磨过。
六、特色能力
最值得单独拿出来讲的是 3 层 MCP 工作流。传统记忆系统往往是「检索即返回全文」,token 消耗随结果数量线性膨胀。claude-mem 把它拆成三步:
search—— 返回紧凑索引与 ID,约 50–100 token/条;timeline—— 围绕感兴趣的结果拉取时间线上下文,帮助判断相关性;get_observations—— 仅对筛选后的 ID 批量拉取完整详情,约 500–1000 token/条。
// 第一步:拿到索引
search(query="authentication bug", type="bugfix", limit=10)

// 第二步:看时间线,确认 #123、#456 是否真的相关

// 第三步:只为筛出来的 ID 付全文成本
get_observations(ids=[123, 456])
官方给出的估算是通过先过滤再取详情,可节省约 10 倍 token。这个数字是否精确可以商榷,但方向是对的:把「粗筛」和「精读」分离开,本质上是把检索成本从「按结果数」改成「按需」。
另外两项能力也值得一提。**<private>**** 标签**提供了内容级的隐私开关,敏感片段不落库;引用机制则让记忆可追溯——每条观察有稳定 ID,可以通过 Worker API 引用,也能在 Web Viewer 里查看实时记忆流。可追溯性对「AI 记忆」这类容易产生幻觉信任的场景尤其重要:你至少能验证它记住的东西是不是真的发生过。
七、工具链或生态
生态覆盖面是这个项目最直观的护城河。官方描述里点名的宿主包括 Claude Code、OpenClaw、Codex、Gemini、Hermes、Copilot、OpenCode 等,安装器则通过 --ide 参数支持多端:opencode、t3code、antigravity、omp、pi、dsh、grok-bot。OpenCode 需要 1.3.4 及以上版本;T3 Code 会先探测已启用的 provider,再为其注册原生插件。
OpenClaw 网关走的是另一条路径,一条 curl 命令完成依赖、插件、AI provider 配置与 Worker 启动,并且可以把实时观察流推送到 Telegram、Discord、Slack 等渠道。这让记忆从「被动查询」变成「主动播报」。
云同步侧提供 cmem.ai 备份,卖点是「无守护进程」——Worker 在写入时同步,不需要额外常驻服务。仓库结构与分支策略也值得一提:main 是稳定分支并发布到 npm,core-dev 与 community-edge 是源码运行分支,分别承接早期可靠性修复与社区集成。这种三轨制在迭代速度快的 AI 工具里比较务实,能避免实验性改动污染稳定用户。
八、部署与安全
部署的主路径就是前面那条 npx claude-mem install。安装器先完成环境自举,再引导浏览器登录(邮箱魔法链接,无需信用卡),登录后自动配发记忆密钥并开启 30 天免费试用,试用结束后若不订阅则回落到 Anthropic 套餐。想跳过登录的话,可以显式传 --provider,或设置 CLAUDE_MEM_ONLINE_OPTIN=false,或在 CI/非交互 shell 中运行。这一点需要提前知道:默认安装路径是带账号环节的,纯本地用户应当明确选择本地 provider。
运行时依赖包括 Node.js 20.0.0+、Bun(缺失时自动安装)、uv(向量检索用的 Python 包管理器,缺失时自动安装)以及内置的 SQLite 3。Windows 用户容易踩的坑是 npm 未加入 PATH,报 The term 'npm' is not recognized,装完 Node 后重启终端即可。所有配置集中在 ~/.claude-mem/settings.json,首次运行自动生成默认值,可配置 AI 模型、Worker 端口、数据目录、日志级别与上下文注入策略。
安全层面有两道设计:一是本地优先,记忆数据默认落在本机;二是 <private> 标签的写入前过滤。许可证是 Apache-2.0,作者明确解释了选它的原因——希望持久化 Agent 记忆能被方便地嵌入开发者工具、本地 Agent、MCP 服务器、企业系统与机器人栈。同时仓库通过 docs/ip-boundary.md 划清了开源与商业功能的边界,ragtime/ 目录单独持有一份 Apache-2.0 许可。这种「开放核心 + 明确边界」的做法,比含糊其辞的许可声明要诚实。
九、适用场景
长周期项目的上下文延续是首要场景。当项目跨越数周甚至数月,每次会话都重新交代背景是纯粹的浪费,记忆注入直接省掉这段成本。
多 Agent、多 IDE 共享记忆层是第二个场景。同一个人可能上午用 Claude Code、下午用 Codex、偶尔在 Cursor 里改代码,如果记忆绑定在单个工具上,价值会大打折扣;claude-mem 的跨 harness 聚合(需显式开启 all-sources)正是为这种情况准备的。
回溯历史 bugfix 与关键决策是第三个场景。半年后你想知道「当初为什么没用方案 B」,检索比翻 git log 高效得多——因为压缩后的摘要保留了「为什么」,而 commit message 往往只有「做了什么」。
个人与团队的知识沉淀是第四个场景。虽然当前形态更偏个人工具,但云同步与共享记忆库的存在,让团队级的记忆复用具备想象空间。
不太适合的场景也要说清楚:如果你只是偶尔用一两次 Agent 写脚本,记忆注入带来的检索开销与依赖复杂度并不划算;如果工作内容涉及大量不可外传的代码,需要先确认默认的记忆提供方与账号流程是否符合合规要求。
十、总结评价
claude-mem 的真正价值不在于「给 Agent 加了记忆」这个说法,而在于它对记忆成本的克制处理。很多同类项目的第一反应是「全都存下来、需要时全塞回去」,结果是上下文窗口被垃圾填满。claude-mem 选择了两条更难的路线:写入时用 AI 压缩(有损但有结构),读取时分层披露(先索