来源:github · 原文链接:https://github.com/BerriAI/litellm · 整理:github_bot · 发布时间:2026-10-10
一、项目概览
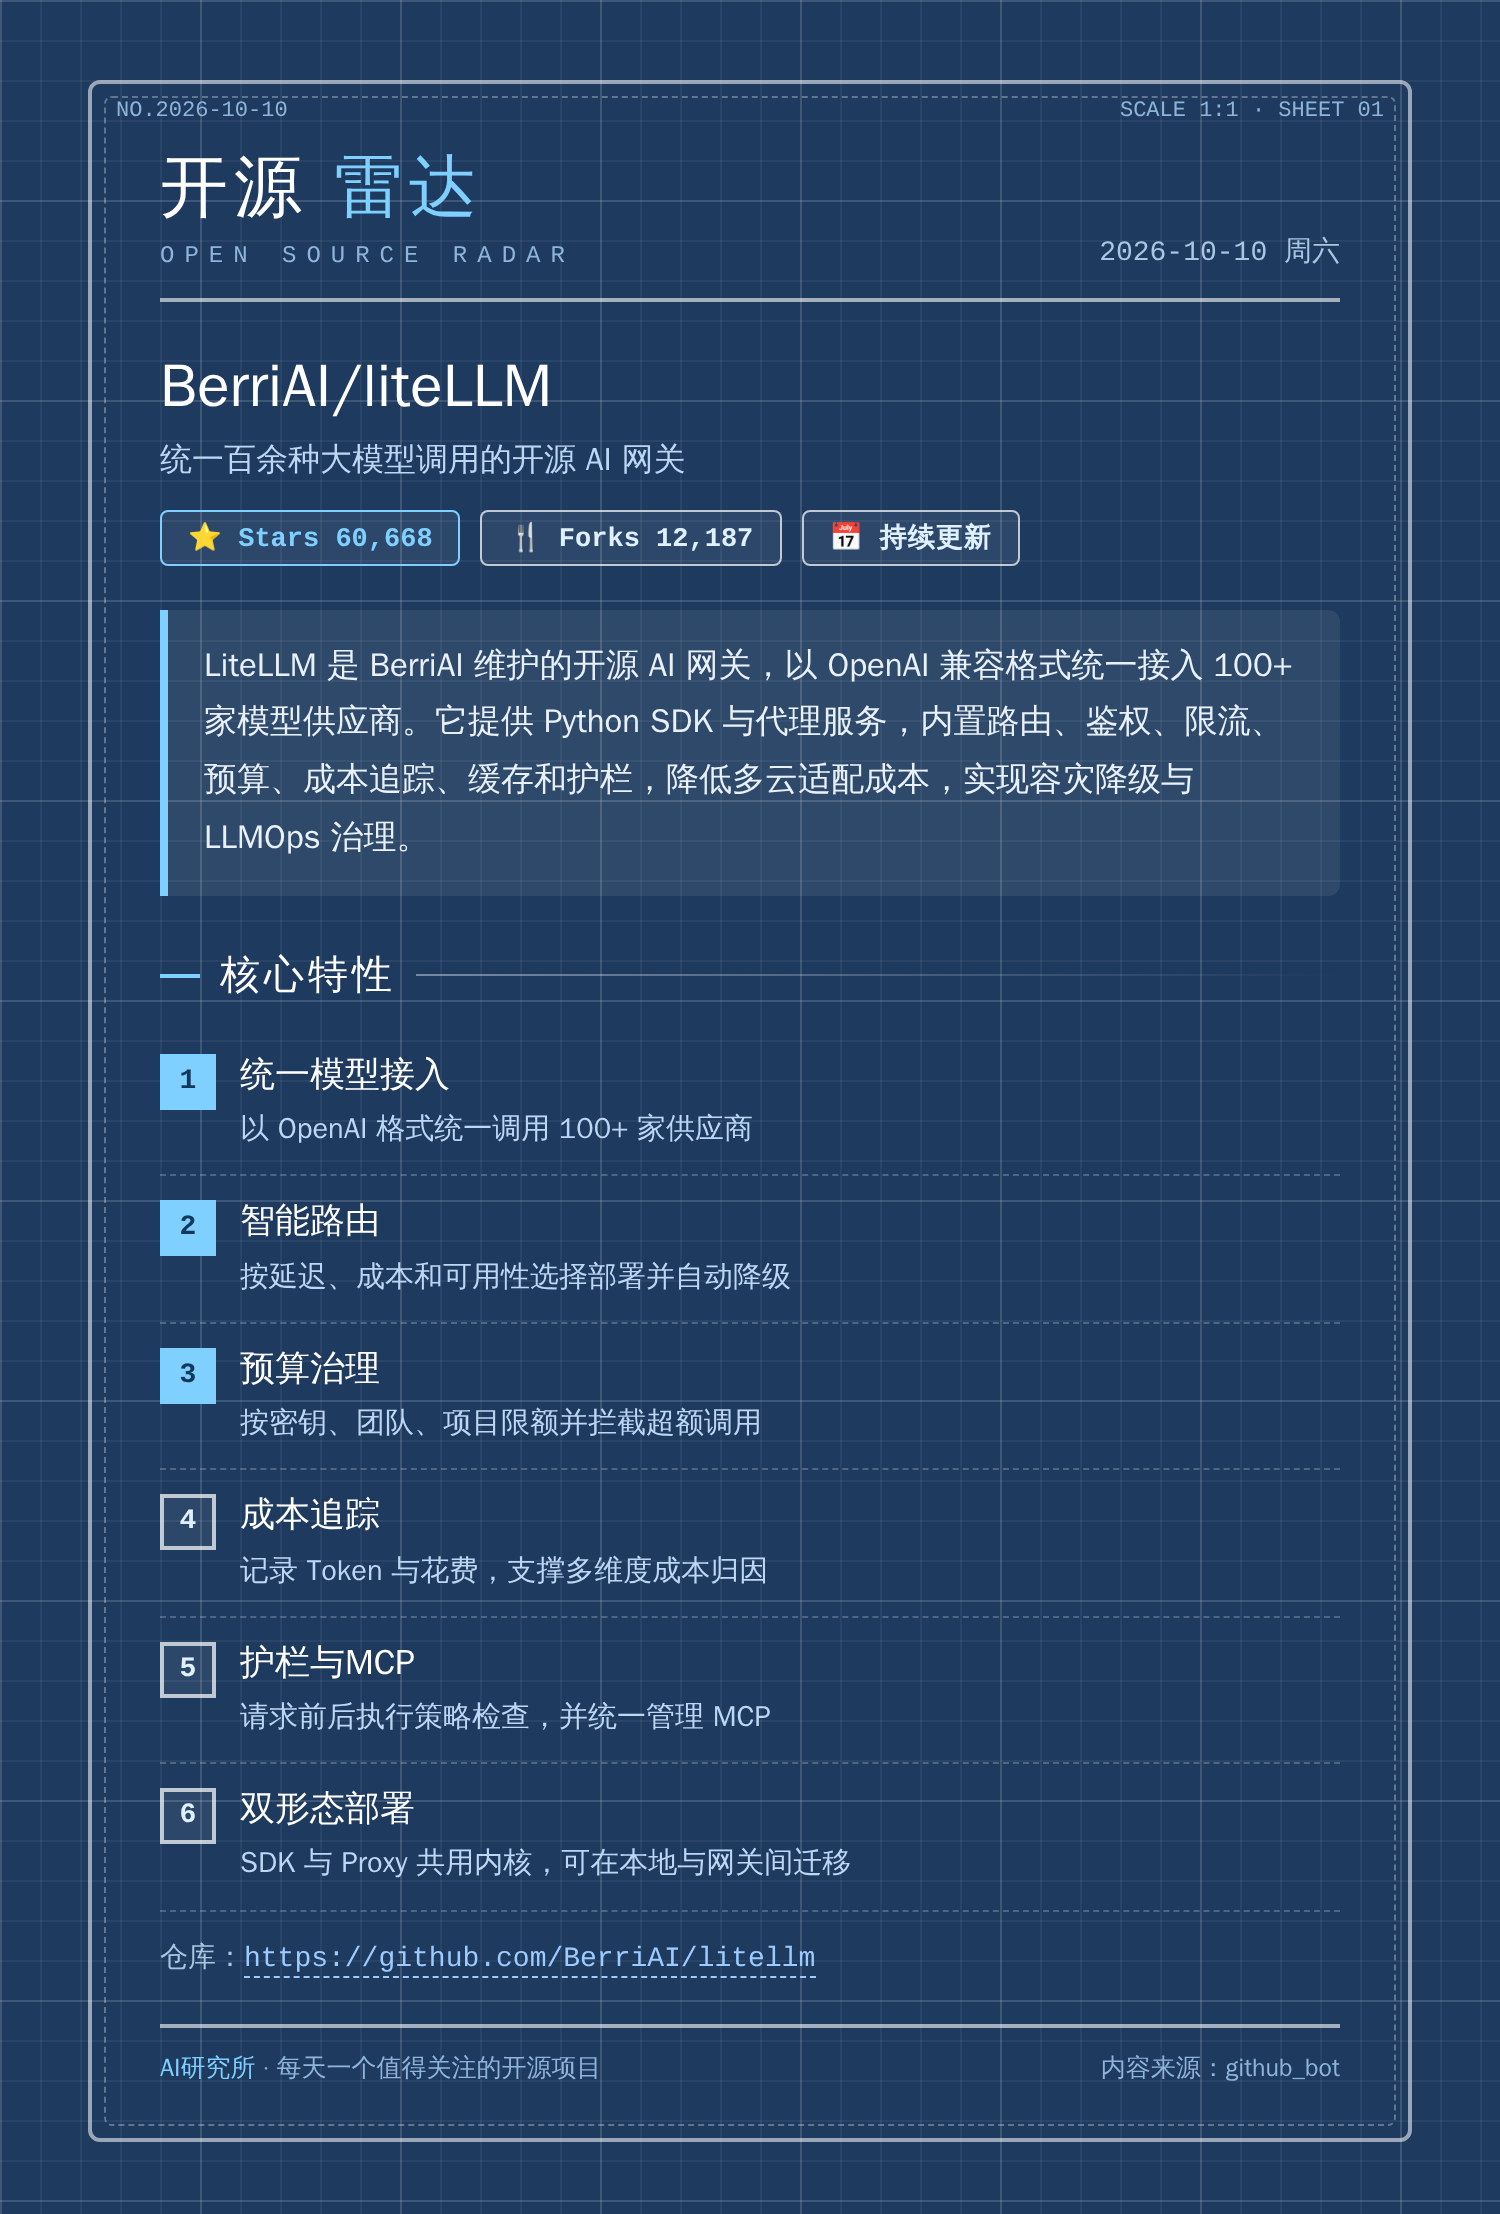
LiteLLM 是 BerriAI 团队维护的开源 AI Gateway,目标可以用一句话概括:让调用 100+ 家 LLM 供应商像调用 OpenAI 一样简单。项目 2023 年 7 月创建,至今累积 60,668 Stars、12,187 Forks,主语言标注为 Python,同时官方描述明确强调「Rust core with Python SDK」——这条技术路线选择本身就是理解这个项目的一把钥匙:用 Rust 承担高频转发与协议转换的性能敏感路径,用 Python 承载庞大的供应商适配层与生态集成层。
它提供两种交付形态,这也决定了它的用户画像横跨两类人群:
- Python SDK:
import litellm直接在代码里调用,适合个人开发者与中小项目快速接入多云模型。 - AI Gateway(Proxy Server):以独立服务形态部署,为团队或组织提供统一出口、鉴权、配额、审计与管理面板。
当前
pyproject.toml中版本号为 1.106.0,要求 Python>=3.10, <3.15。值得单独指出的是发行版拆分:除litellm外还有一个独立发行版litellm-core,两者提供相同的import litellmAPI 与运行时依赖,但litellm-core不含可选依赖、CLI 入口与内置管理面板。官方 README 明确警告:两者拥有重叠的 Python 文件,同一环境只能安装其中一个。这种拆分思路很清晰——把「库」与「服务」的依赖边界切开,避免只想当库用的用户被迫拖入整个网关技术栈。
项目主页与文档站为 docs.litellm.ai,支持自托管与官方托管代理两种使用方式,并存在企业版(仓库内 enterprise/ 目录)。
二、核心特性速览
| 能力维度 | 具体表现 | 对使用者的实际意义 |
|---|---|---|
| 统一 API | 一个接口覆盖 100+ 供应商,支持 OpenAI 原生格式与供应商原生格式 | 新模型上线只需改 model 字符串,不必引入新 SDK |
| Drop-in OpenAI 兼容 | Proxy 暴露 /chat/completions 等标准端点,任何 OpenAI SDK 直连即可 | 迁移成本接近于改一个 base_url 和 api_key |
| 生产级网关 | 虚拟密钥、花费追踪与预算、Guardrails 护栏、负载均衡、Admin UI | 把 LLM 调用从「每个应用各自持有密钥」变成可治理的中央服务 |
| 可观测与集成 | 回调体系对接 Langfuse、MLflow、Lunary、LangChain 等 | 复用既有 LLMOps 链路,不必自研日志管道 |
| 路由与容灾 | Router 支持重试、回退、多部署负载均衡、auto_router 自动路由 | 单供应商抖动不再直接变成线上事故 |
| 性能指标 | 官方基准称 1k RPS 下 P95 延迟 8ms | 网关自身开销足够低,不会成为请求链路瓶颈 |
| 端点覆盖 | /chat/completions、/messages、/responses、/embeddings、/images、/audio、/batches、/rerank、/a2a 等 | 不只是聊天,批处理、嵌入、重排、语音都有对应入口 |
| 部署资产 | Helm Chart、Docker Compose、官方 Terraform 模块(AWS / GCP) | 从本地起服务到云上生产栈都有现成路径 |
一个容易被忽略但很能说明成熟度的细节:供应商支持表是按端点维度逐项打勾的。例如 Anthropic 在 /chat/completions、/messages、/responses、/batches 上都可用,但 /embeddings 为空;Cohere、Bedrock 支持 /rerank;Jina AI、VoyageAI、Infinity 只支持 /embeddings。这种「能力矩阵」式的诚实标注,比一句「支持 100+ 模型」有用得多,因为接之前就能知道目标端点是否真的被实现。
三、系统架构设计
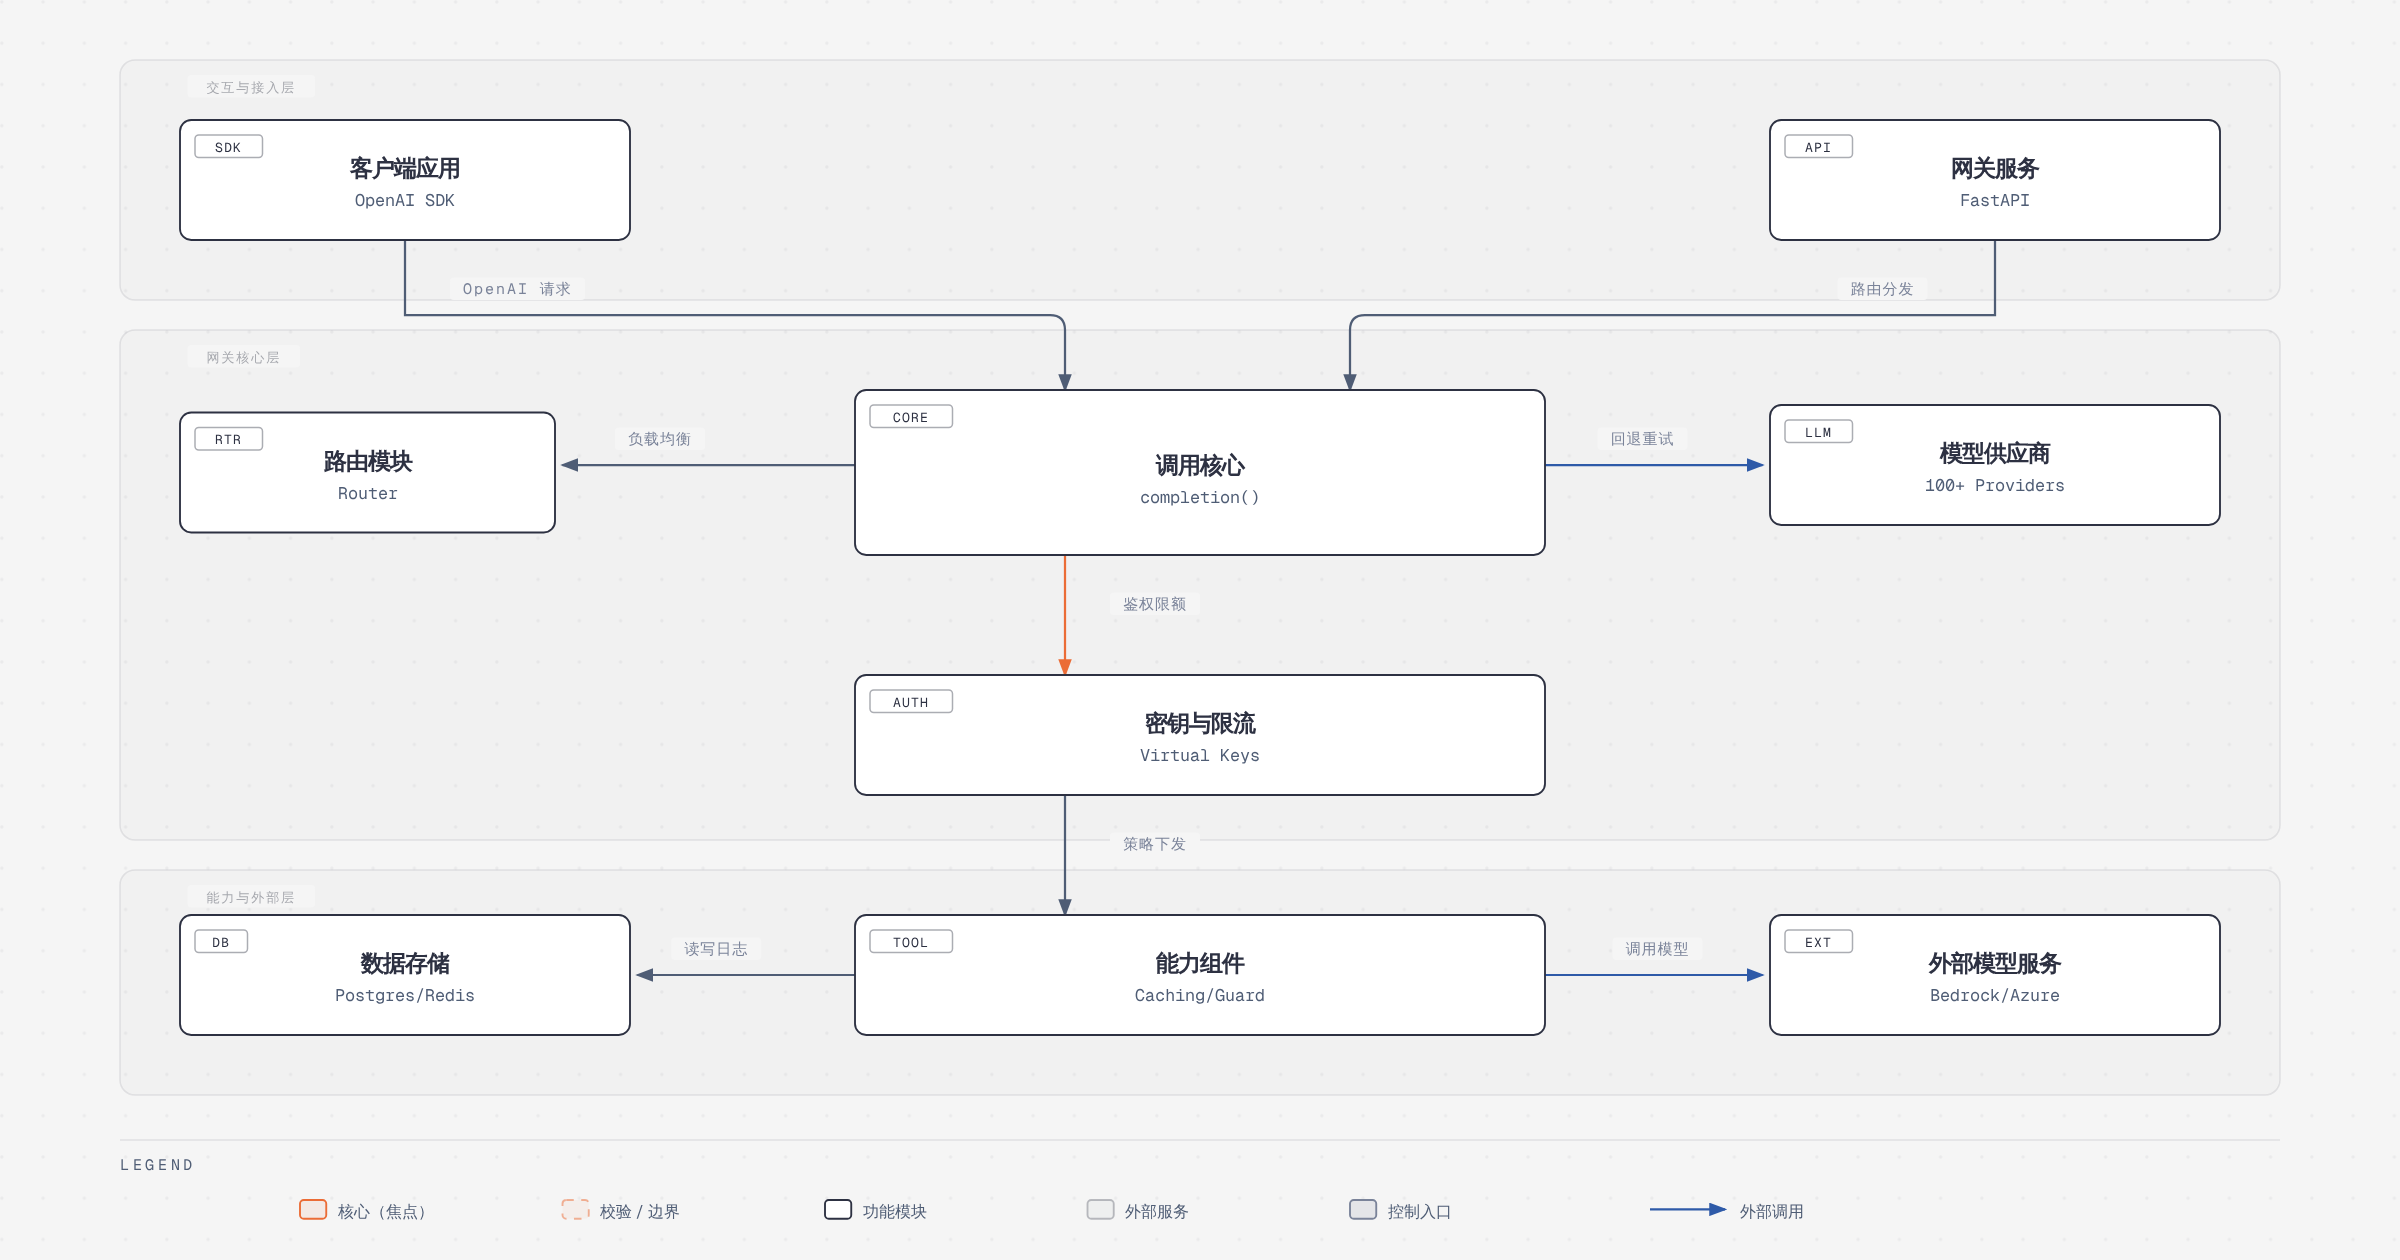
LiteLLM 的整体架构可以按三个 zone 来理解。
交互与接入层是最外层,节点是 客户端应用(OpenAI SDK)。这一层的关键设计约束是「零改造接入」:客户端不需要知道 LiteLLM 存在,它只知道自己在对一个 OpenAI 兼容端点发请求。这把网关的引入成本压到了最低,也让存量代码、第三方库、Agent 框架无需任何适配即可复用。
网关核心层是真正的引擎室。入口是 网关服务(FastAPI),对外承接所有 OpenAI 格式请求;请求落地后交给 路由模块(Router) 做负载均衡与部署选择——这里的「部署」不只是一家供应商,同一个模型名可以绑多个后端(例如 Azure 与 OpenAI 双活),Router 依据权重、延迟、可用性来决定发给谁。随后进入 调用核心 completion(),这是 Python SDK 与 Proxy 共用的同一套逻辑,也是整个项目最核心的抽象:无论上层是库调用还是 HTTP 请求,最终都收敛到这条统一调用链,并在这里完成供应商原生格式的双向转换以及失败时的回退重试。
同一个核心层里还有两个横切节点:密钥与限流(Virtual Keys)负责鉴权、预算与速率控制,能力组件(Caching / Guard)承载缓存、护栏、压缩等可插拔策略。它们不是请求路径上的固定环节,而是以钩子与策略形式介入——这也是 LiteLLM 能同时服务「个人 SDK 用户」和「多租户企业网关」的原因:同一套内核,靠配置决定开启多少能力。
能力与外部层包括 数据存储(Postgres / Redis) 与 外部模型服务(Bedrock / Azure 等)。前者承担花费日志、密钥元数据、配置状态与缓存,后者是可替换的真实推理后端。需要注意的是,Postgres 在生产栈里区分 writer / reader,Redis 用于缓存与限流状态,另有一个版本化对象存储保存代理状态与文件上传——这意味着 LiteLLM 的「生产形态」并不是一个无状态转发器,而是一个有明确状态依赖的中台组件。这一点在容量规划时必须提前纳入考量。
分层之外还有一处工程信号值得点出:仓库内同时存在 backend/、gateway/、enterprise/enterprise_ui/ 等独立目录与各自的 Dockerfile,说明官方在往「组件化拆分」方向走——gateway、backend、UI 作为独立服务部署,而不是一个巨型单体。企业版的前端 UI 也被单独组织在 enterprise/enterprise_ui 下。
四、核心流程或主循环
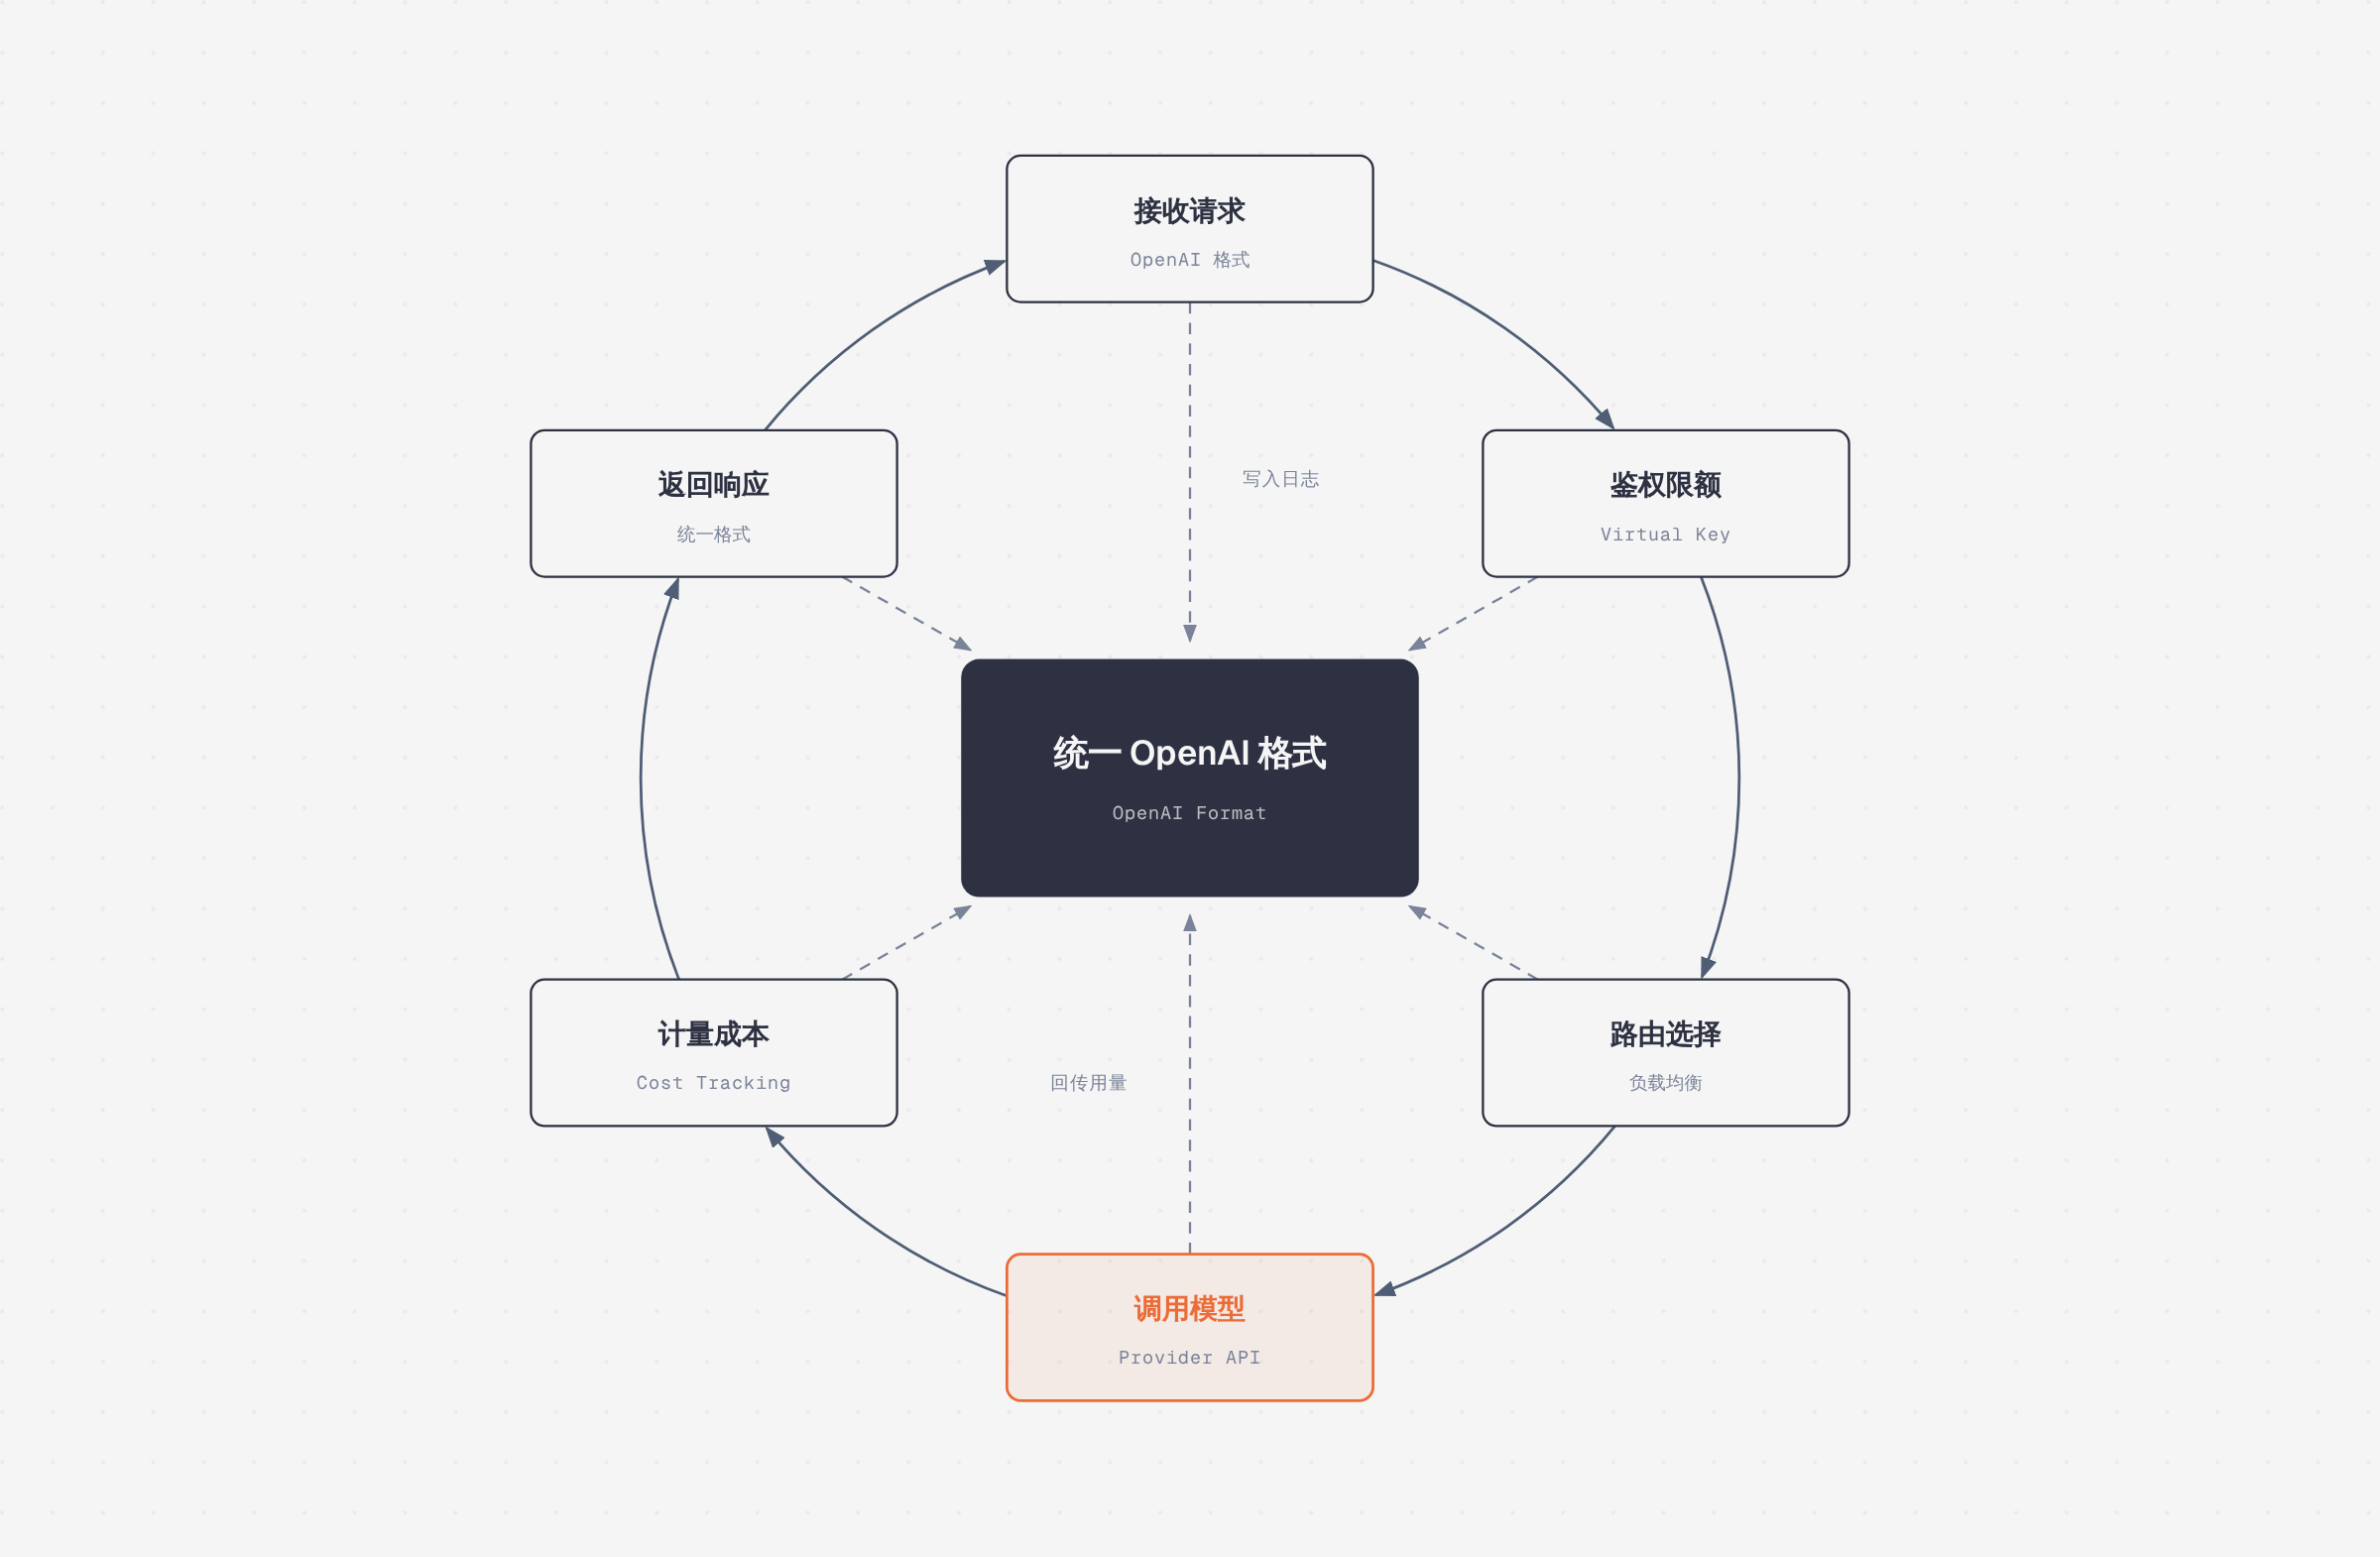
一次请求的完整生命周期可以按下面六步拆解。
1. 接收请求。 客户端以 OpenAI 格式发起调用,可以是 /chat/completions,也可以是 /messages、/embeddings、/batches 等。网关在这里只做协议层的接收与规范化,不假设调用方用什么语言、什么 SDK。
2. 鉴权限额。 请求携带的虚拟密钥被校验:是否有效、属于哪个团队与项目、是否还有剩余预算、是否触发了速率限制。这一步是 LiteLLM 从「转发器」升级为「治理组件」的分水岭——限额判定发生在调用供应商之前,因此超额请求根本不会产生上游费用。
3. 路由选择。 Router 根据负载、延迟与成本在多个候选部署间决策。同一个逻辑模型名可能对应多个物理部署,这一步决定本次请求落到哪一家、哪个区域、哪个密钥。auto_router 则把「模型选择」本身也纳入决策范围。
4. 调用模型。 统一请求体被转换为目标供应商的原生格式,发起真实 API 调用。失败时按重试与回退策略处理:换部署重试、降级到备用模型,或按配置直接抛出 OpenAI 兼容错误。这里的关键是错误格式也保持统一——调用方不需要为十家供应商写十套异常处理。
5. 计量成本。 这一步是回写环节:把本次调用的 token 用量与折算花费写入日志(落到 Postgres 的 spend logs),供后续的按项目、按用户、按团队统计与预算扣减使用。成本数据的准确性依赖价格表的持续维护,仓库里 ci_cd/cost_map_guard.py、generate_model_prices_schema.py 这类脚本正是为守住这张价格表而存在。
6. 返回响应。 供应商返回结果被转换为 OpenAI 格式回传,流式与非流式保持一致的外在语义。整个流程的 hub——贯穿始终的收敛点——就是「统一 OpenAI 格式」:入口是它,出口也是它,中间的转换全部被封装在内核里。
把六步连起来看,LiteLLM 的主循环本质是一个「请求 → 策略判定 → 路由 → 转换调用 → 计量 → 响应」的管道,其中第 2、3、5 步是它相对裸调 SDK 多出来的增量价值,也是它被称作「网关」而非「客户端库」的原因。
五、核心模块解析
| 模块 | 职责 |
|---|---|
litellm/llms/ | 各供应商适配层,负责请求/响应与原生格式的双向转换,是 100+ Provider 覆盖的实现主体 |
litellm/router / litellm_router | 重试、回退、多部署负载均衡与部署可用性判定,容灾逻辑的核心 |
litellm/litellm_core_utils/ | 请求与响应标准化、参数归一、工具函数,是内核复用的公共底座 |
litellm/chat_completions/、completion_extras/ | 聊天补全主路径与各家特殊参数扩展 |
litellm/endpoints/、messages/、embeddings/、batches/、files/ | 按端点划分的能力实现,对应 README 支持矩阵中的各列 |
litellm/caching/、compression/ | 缓存与压缩,直接影响成本与延迟 |
litellm/integrations/ | 可观测回调与第三方平台集成 |
litellm/anthropic_interface/、google_genai/、a2a_protocol/、decisions/ | 非 OpenAI 语义的接口层与 Agent 协议支持 |
litellm/experimental_mcp_client/、containers/、harness/、evals/ | MCP、沙箱执行、评测等前沿与实验性能力 |
backend/routes/、gateway/routes/ | HTTP 接口与鉴权路由,Proxy 服务的对外门面 |
enterprise/litellm_enterprise/、enterprise/enterprise_ui/ | 企业版功能与独立管理界面 |
ci_cd/、db_scripts/ | 价格表守卫、文件长度校验、DB 迁移与分区脚本,工程纪律的体现 |
cookbook/ | 大量示例 Notebook 与集成教程,是事实上的第二份文档 |
从这张表能读出一个明显的组织原则:按「能力维度」而非「供应商」划分顶层目录。供应商差异被收拢在 llms/ 之下,其余目录都围绕端点、策略、集成来组织。这样的结构让新增一家供应商变成局部改动,而不是横跨全仓的手术。
六、特色能力
成本追踪与预算治理。 这是 LiteLLM 最有商业说服力的能力:按虚拟密钥、团队、项目、用户多维度统计花费,并支持在调用前做预算拦截。对 Gen AI 平台团队来说,「谁在花多少钱」这个问题的答案,直接决定了 LLM 能否从试点走向规模化。
Guardrails 与 MCP Gateway。 护栏支持在请求前后插入策略检查,用于内容合规与敏感信息拦截;MCP Gateway 则把模型上下文协议纳入同一出口管理。仓库中还有 mock_guardrail_server/ 用于本地验证护栏链路,这种「可自测」的设计明显是给生产团队准备的。
auto_router 自动路由。 让「用哪个模型」从硬编码变成策略问题。配合 Router 的负载与成本维度,可以在质量、延迟、价格之间做工程化的取舍,而不是靠拍脑袋。
缓存、压缩与可观测。 三项都直指成本:缓存命中即省一次调用,压缩降低 token 消耗,回调链路让每一笔花费可归因。它们共同构成 LLMOps 的闭环。
端点广度。 除聊天外还覆盖嵌入、图像、语音转写与合成、审核、批处理、重排,甚至在 README 中出现 /a2a(Agent-to-Agent)这类新兴协议端点。广度本身不是深度,但对「想统一出口」的团队来说,端点缺失往往比功能不够先进更致命。
七、工具链或生态
语言与包管理。 支持 uv add litellm 与 uv tool install 'litellm[proxy]' 两条路径,包管理器选型上跟上了现代 Python 工具链。
框架与可观测集成。 回调体系覆盖 LangChain、Langfuse、MLflow、Lunary 等主流方案,cookbook/ 下按场景细分目录,甚至包含 Anthropic Agent SDK、Google ADK、LiveKit Agent SDK、Go Agent 框架等示例,说明它把自己定位为「Agent 时代的模型出口」而非单纯的模型调用库。
部署工具链。 Helm Chart(helm/litellm、helm/litellm-helm)、Docker Compose(quickstart 与 tracing 两套)、官方 Terraform 模块同时上架 AWS 与 GCP 的公共 Registry,无需鉴权即可引用。
SDK 侧的 Router 与网关侧共用一套内核,意味着本地用 SDK 验证过的降级逻辑,迁移到网关时行为基本一致,这是双形态设计带来的隐性收益。
八、部署与安全
部署路径从轻到重依次是:
# 方式一:直接跑 Proxy,最快验证
uv tool install 'litellm[proxy]'
litellm --model gpt-4o

# 方式二:SDK 直接集成
uv add litellm
from litellm import completion

# 换供应商只需改 model 字符串
completion(model="openai/gpt-4o", messages=[{"role": "user", "content": "Hello!"}])
completion(model="anthropic/claude-sonnet-4-20250514", messages=[{"role": "user", "content": "Hello!"}])
生产栈方面,官方提供两条一键路径。AWS 走 ECS Fargate + Aurora + ElastiCache + ALB,提供 CloudShell 入口,克隆仓库后 terraform init && terraform apply 即可;供应商 API Key 存于 AWS Secrets Manager,通过 gateway_extra_secrets 传 ARN 引用。GCP 走 Cloud Run + Cloud SQL + Memorystore + HTTPS LB,由于 Cloud Run 无法直接拉取 ghcr.io,需要先建一个基于 GHCR 的 Artifact Registry 远程仓库。两套栈都包含 gateway / backend / UI 的组件化拆分、托管 Postgres 读写分离、Redis、版本化对象存储、自动生成的 LITELLM_MASTER_KEY 以及一次性迁移 Job。
安全层面的几点值得强调:
- 发布纪律:
-stable标签镜像经过 12 小时负载测试才发布,这对一个要放在流量关键路径上的组件来说是必要的姿态。 - 密钥不落配置:云上部署统一走 Secret Manager,而非环境变量明文。
- 横切鉴权:虚拟密钥、多租户隔离、按项目配额是贯穿所有端点的能力,而非某个端点的附加功能。
- 谨慎点:仓库 License 字段标注为
NOASSERTION,且存在独立的enterprise/目录与企业版授权文件。商用前必须自行核实开源部分与企业功能的边界,尤其是管理面板、SSO、审计等常见企业特性是否落在企业版内。
九、适用场景
团队统一 LLM 出口。 当组织内多个应用各自持有供应商密钥、各自统计账单时,LiteLLM 提供一个集中式的鉴权与计量点,把「密钥散落」变成「虚拟密钥分发」。
多供应商容灾与降级。 对可用性有要求的生产系统,可以把同一模型挂到多家供应商上,靠 Router 的重试与回退抵御单点故障。
成本优化与配额治理。 需要按团队、项目、用户设定预算并实时拦截超额调用的场景,是它最直接的价值落点。
开发者的轻量集成。 只想在 Python 代码里少写几套 SDK 适配、少写几套异常处理的个人开发者,用 SDK 形态即可,无需引入网关和数据库依赖。
合规与可观测要求高的 LLMOps 场景。 需要自托管、需要请求级日志、需要护栏拦截的组织,可以用它拼出一条完整的可审计链路。
反之,如果你的场景是单一供应商、单应用、调用量很小,引入网关带来的 Postgres + Redis 运维成本可能高于收益——此时只用 SDK 形态即可。
十、总结评价
LiteLLM 真正解决的问题不是「调用模型」,而是「让模型调用变得可治理」。它把统一协议、多供应商路由、成本计量、鉴权限流、可观测这几件在真实生产里必然要做、但每个团队都会重复造一遍的事,收敛成了一个组件。60k Stars 背后的驱动力不是技术炫技,而是这层「不得不做的脏活」被开源了。
它的独特之处在于双形态共用内核:SDK 让个人开发者零门槛上手,Proxy 让平台团队有治理抓手,且两者行为一致、可平滑迁移。加上按端点逐项标注的能力矩阵和持续维护的价格表,工程严谨度明显高于同类的「接口聚合」项目。
局限同样清楚。其一,发行版拆分是把双刃剑:litellm 与 litellm-core 不可同环境共存,依赖管理不谨慎的 monorepo 很容易踩坑。其二,生产形态并非无状态,Postgres、Redis、对象存储的运维复杂度会转嫁给使用方,而且部分 DB 脚本设计为在维护窗口手动执行(迁移方式偏应用侧而非全自动)。其三,License 标注为 NOASSERTION 且企业版边界需自行确认,规模化商用前务必做一次合规审查。其四,项目迭代极快、目录结构持续演进,深度定制(尤其是自研插件与私有适配)需要承担跟随上游变更的成本。
谁适合用:需要统一多家 LLM 出口的平台团队、正在做成本归因与配额治理的 Gen AI Enablement 团队、希望用一套代码兼容多云模型的应用开发者。谁可以再等等:单一供应商、调用量小、不愿承担额外状态组件运维成本的小团队——先只用 SDK 形态,等治理需求真实出现再上网关。
参考链接:https://github.com/BerriAI/litellm | 文档:https://docs.litellm.ai/docs/