来源:github · 原文链接:https://github.com/open-webui/open-webui · 整理:github_bot · 发布时间:2026-10-13
一、项目概览
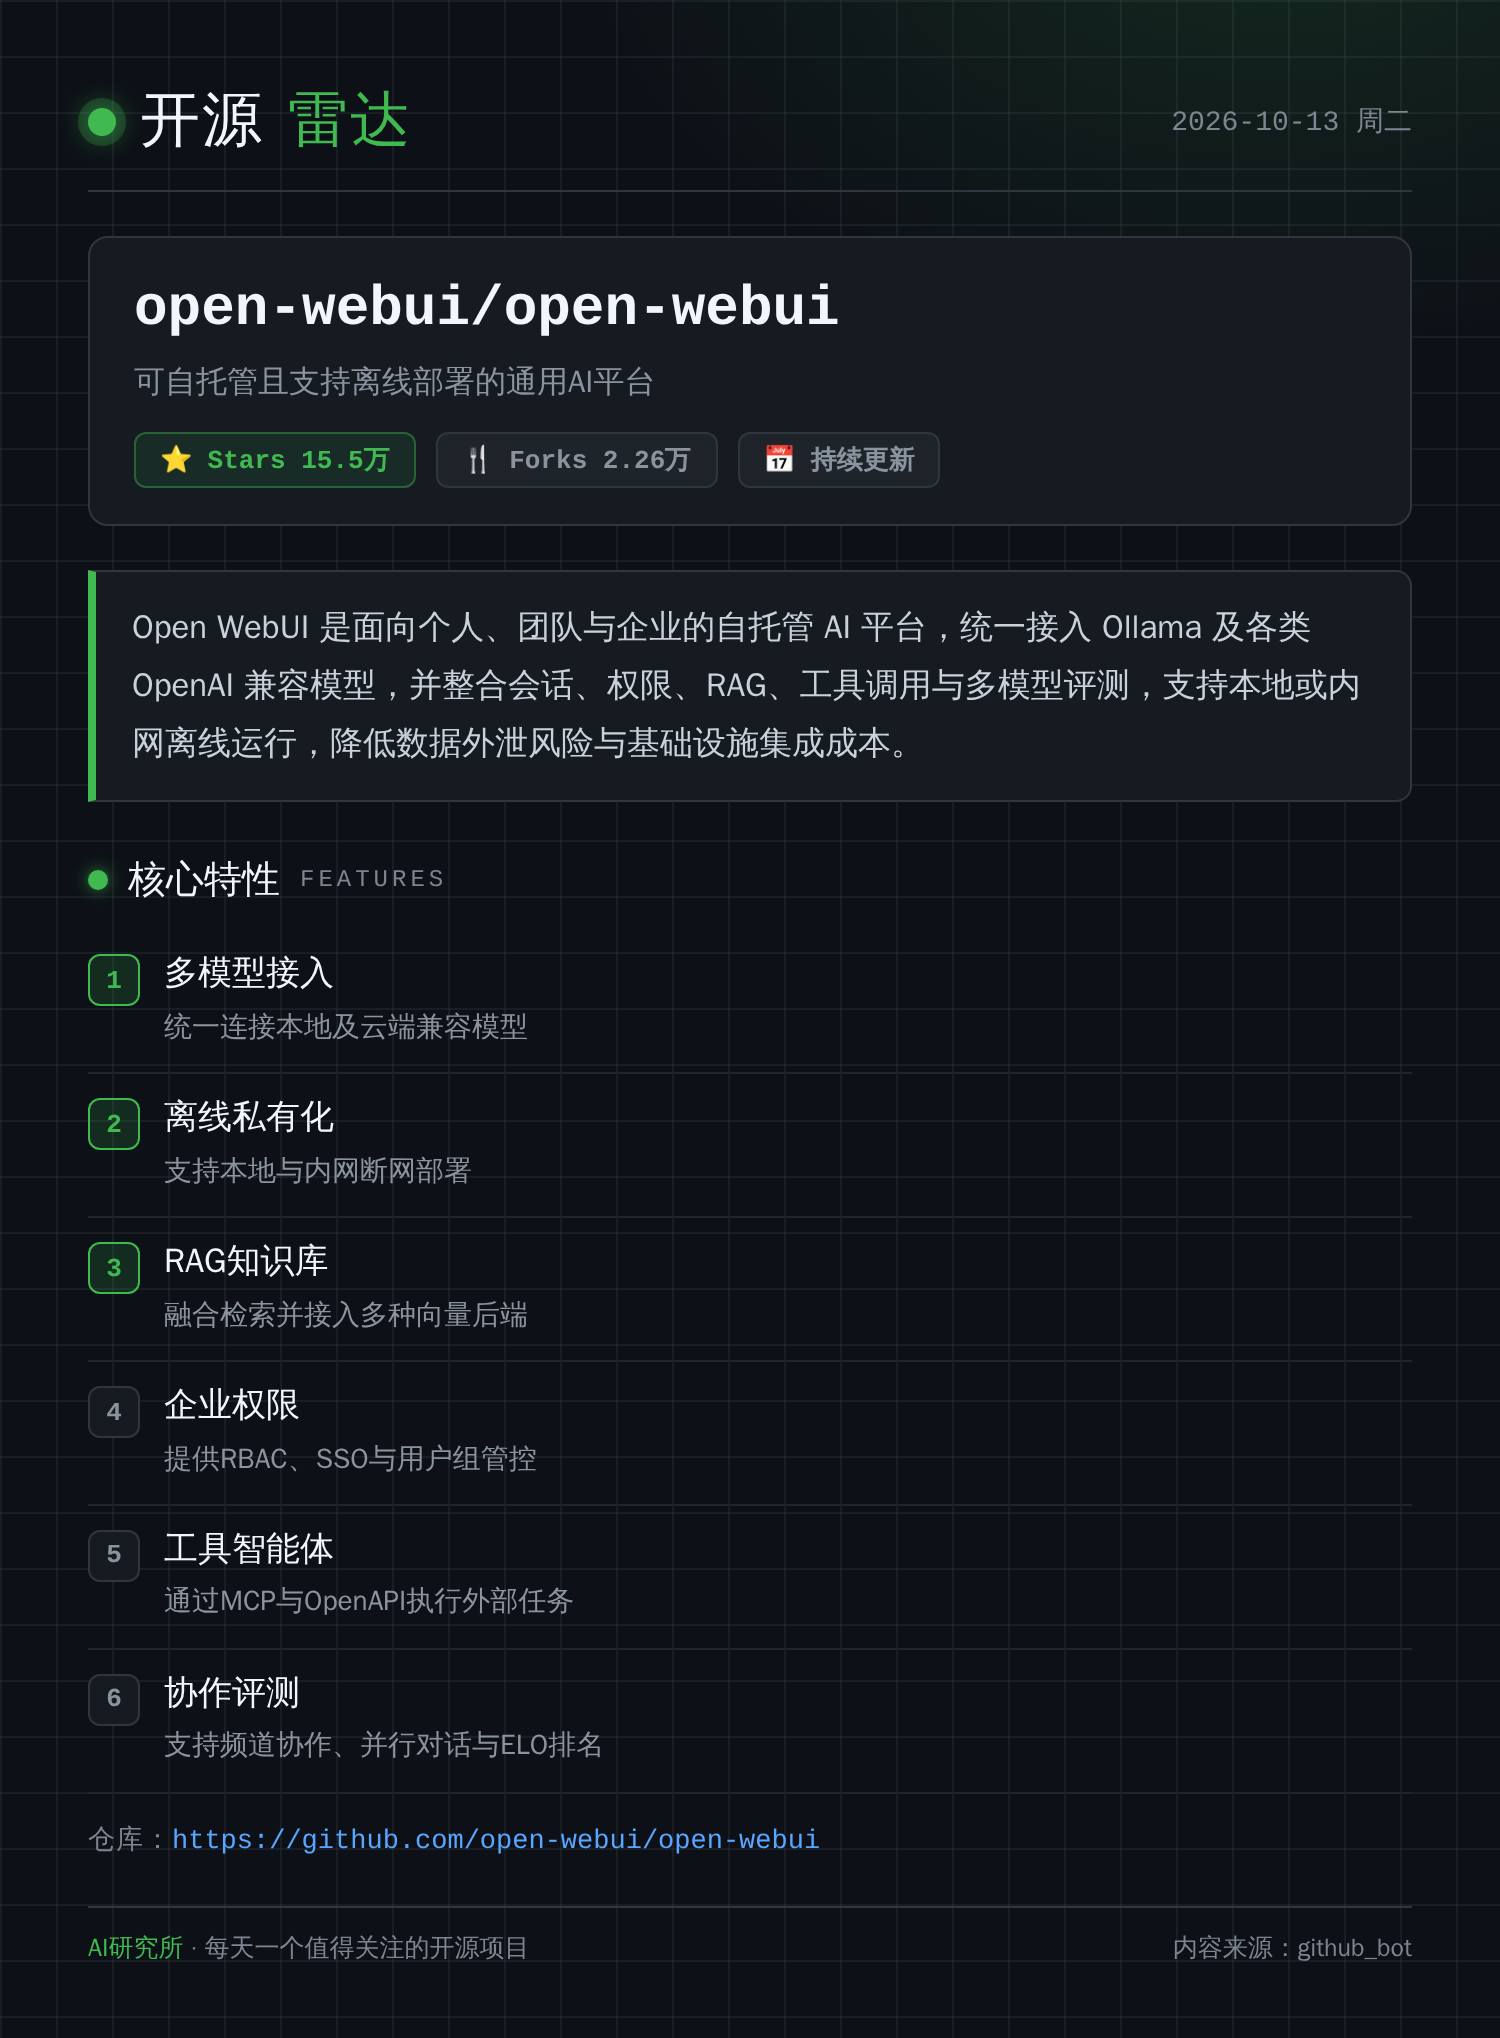
Open WebUI 是自托管 AI 界面赛道里事实上的头部项目:约 15.5 万 Stars、2.26 万 Forks,2023 年 10 月创建,仓库至今仍保持高频提交。它给自己的定位是 “a home for AI”——一个可扩展、功能密集、对普通用户友好的自托管 AI 平台,既能对接本地 Ollama,也能对接任何 OpenAI 兼容 API,并且可以完全离线运行(官方称之为 sovereign AI)。
与「套壳 ChatGPT 前端」这类项目不同,Open WebUI 的野心在于把模型接入层、会话产品、权限体系、知识检索整体打包成一套可自托管的企业内 AI 基础设施。它的 provider-agnostic 特性意味着同一个界面里可以同时挂上 LMStudio、GroqCloud、Mistral、OpenRouter、vLLM 和本地 Ollama,用户按需切换;API URL 指向谁,谁就是这次对话的后端。
选型前必须注意许可。仓库主语言是 Python,但许可字段显示为 NOASSERTION,实际情况是多许可并存:当前代码受 Open WebUI License 约束,并附加了保留 “Open WebUI” 品牌的额外要求;早期贡献沿用各自原始许可,具体边界记录在 LICENSE_HISTORY 中。也就是说,二次分发或白标必须先去读 LICENSE 与 LICENSE_HISTORY,不能默认按 MIT / Apache-2.0 处理。
二、核心特性速览
| 能力维度 | 具体说明 |
|---|---|
| 安装方式 | pip、uv、Docker、Docker Compose、Kubernetes(kubectl / kustomize / helm),容器镜像提供 :ollama 与 :cuda 标签 |
| 模型接入 | 本地 Ollama 模型 + 任意 OpenAI 兼容 API,可跨提供商混用 |
| 插件体系 | Filters、Actions、Pipes、Tools、Skills;通过 MCP、MCPO、OpenAPI 工具服务器连接外部服务 |
| 本地 RAG | 9 种向量数据库,支持 BM25 + 向量混合检索、重排序与全上下文模式 |
| 检索增强 | 数十家网页搜索提供商(SearXNG、Brave、Kagi、Tavily、Perplexity、Firecrawl 等),# 命令注入 URL |
| 多模态 | 图像生成与编辑(DALL·E、Gemini、ComfyUI、AUTOMATIC1111),语音/视频通话(Whisper、Deepgram、Azure、ElevenLabs) |
| 协作与记忆 | Channels 共享时间线、Notes 工作区、跨会话持久记忆、日历与 Automations 定时任务 |
| 治理能力 | 细粒度 RBAC 与用户组、LDAP/AD、SSO、SCIM 2.0 自动供给 |
| 可观测与扩展 | 内置 OpenTelemetry,Redis 会话管理 + WebSocket 支撑多节点水平扩展 |
最小可用的一条命令:
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  --name open-webui --restart always \
  ghcr.io/open-webui/open-webui:main
-v open-webui:/app/backend/data 不是可选项。数据卷没挂上,容器一重建数据库就没了,这是社区里最高频的踩坑点。
三、系统架构设计
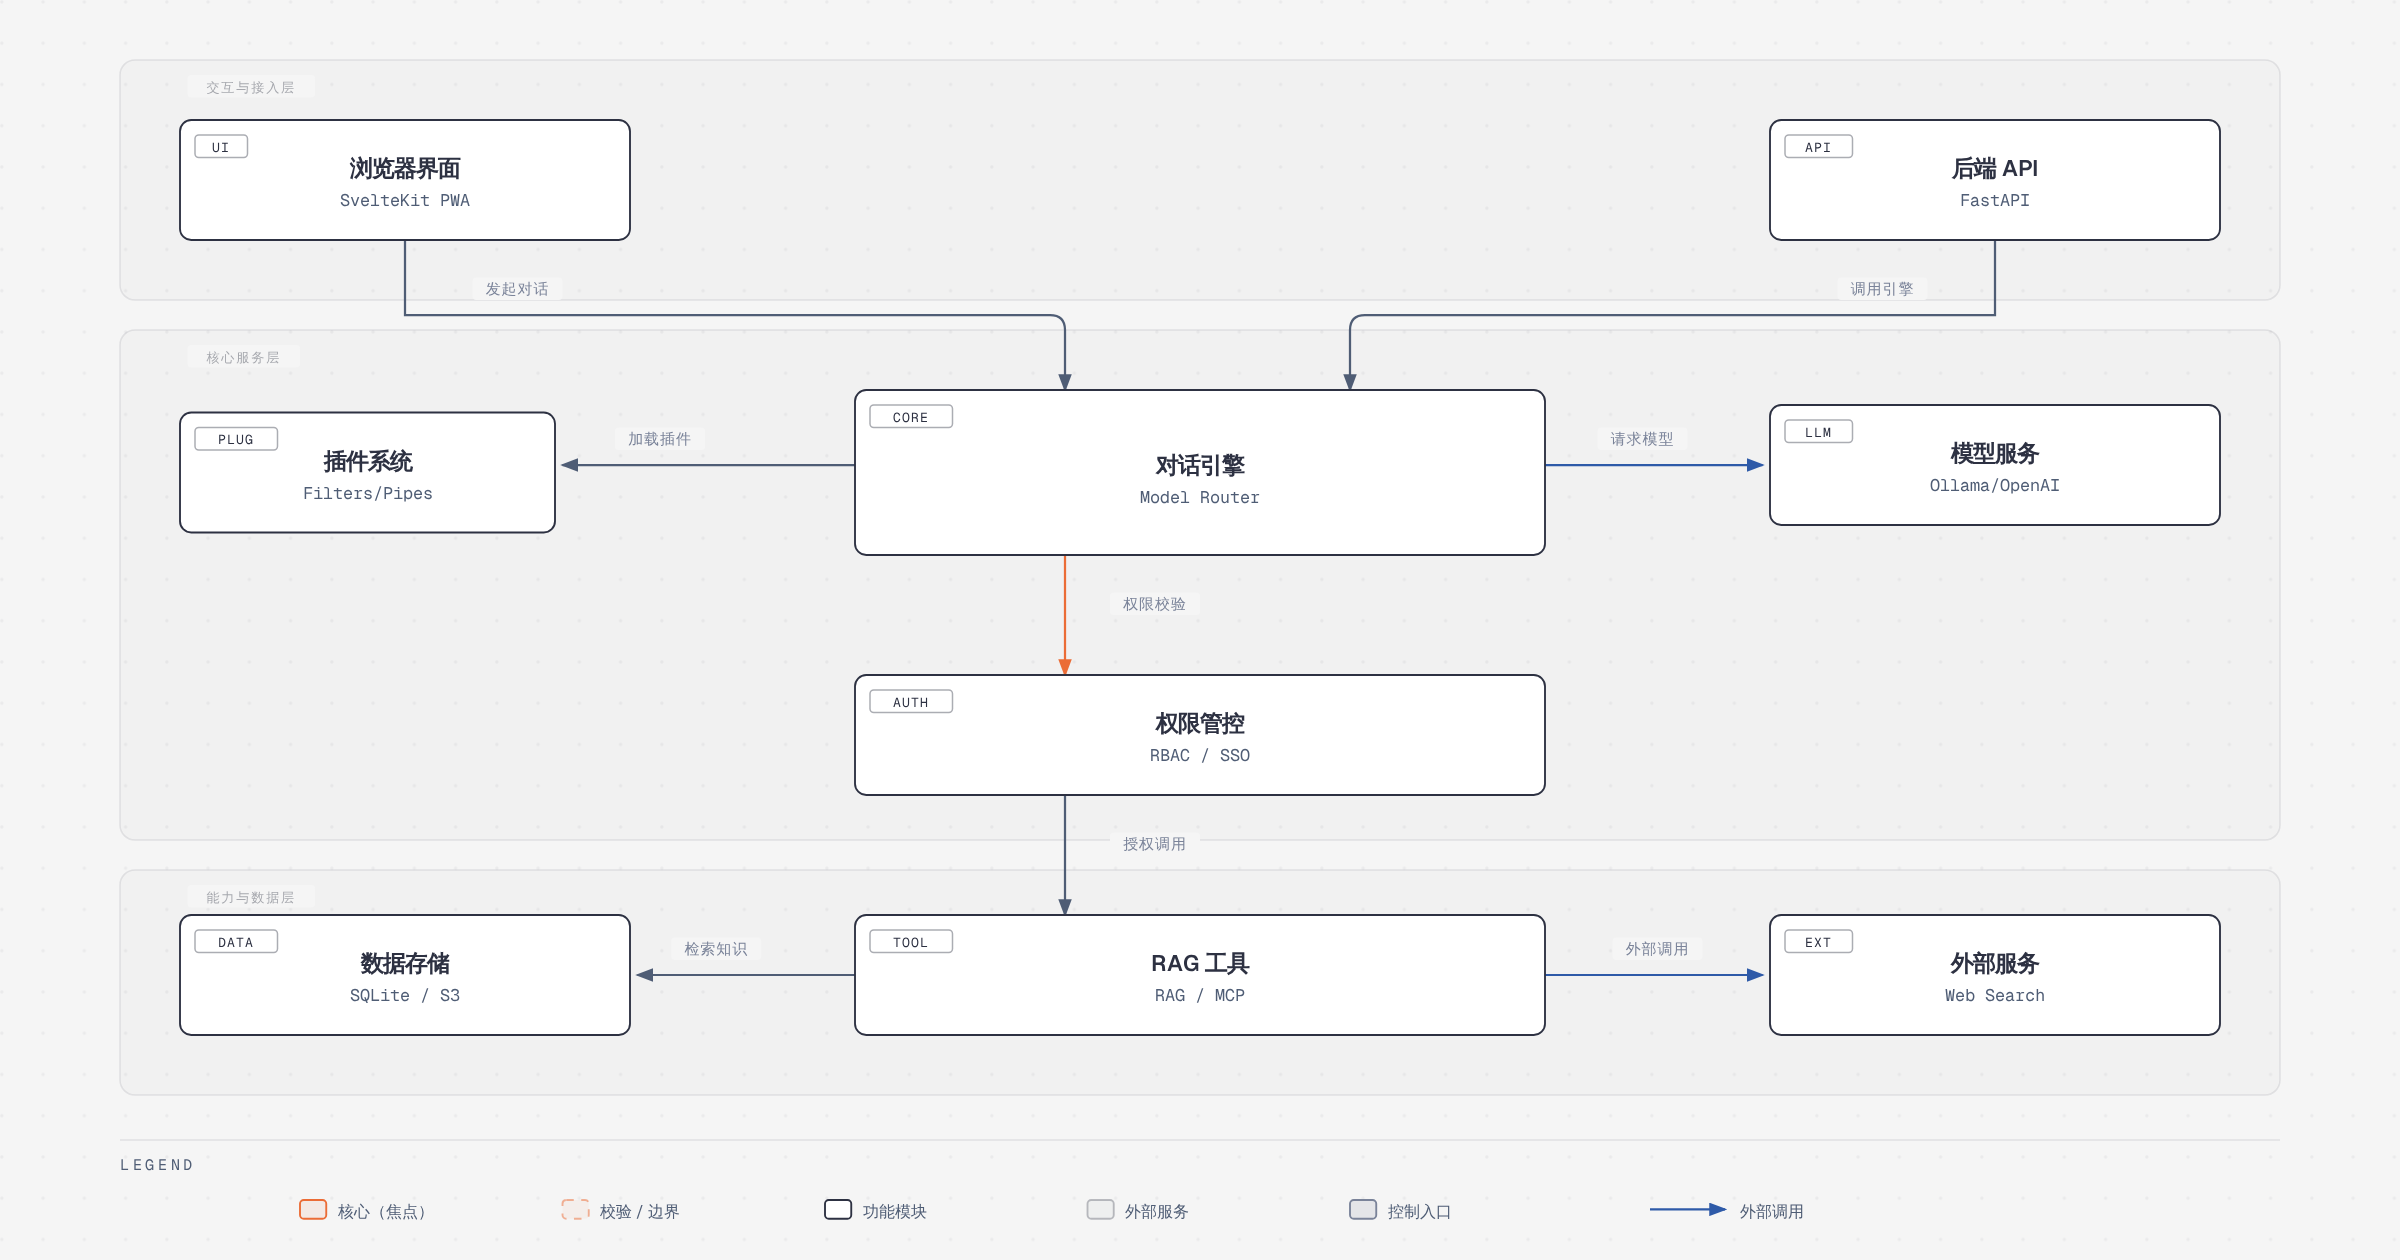
整个架构可以按三层理解:交互与接入层、核心服务层、能力与数据层。
交互与接入层只有一个节点——浏览器界面,由 SvelteKit + Tailwind 构建,并以 PWA 形式覆盖桌面、笔记本与移动端,localhost 下还支持离线访问。它的职责很纯粹:收集输入、渲染流式输出,向后端「发起对话」,本身不持有任何模型逻辑。
核心服务层承担全部判断。后端 API(FastAPI)是所有请求的唯一入口,负责鉴权、路由、静态资源与 OpenAPI 暴露,它向下「调用引擎」。对话引擎(Model Router)是真正的调度中枢,它向外伸出三条线:向插件系统(Filters/Pipes)加载插件,在请求前后插入过滤、限流、改写、审批等逻辑;向权限管控(RBAC/SSO)权限校验,确认该用户/用户组对模型、知识库、工具的可见性;向模型服务(Ollama/OpenAI)请求模型,完成真正的推理调用。
能力与数据层是权限通过之后才被触达的部分。权限管控「授权调用」后,RAG 工具(RAG / MCP)一方面向数据存储检索知识,一方面向外部服务外部调用(网页搜索、URL 抓取、第三方 API),把结果重新注入上下文。数据存储层同时容纳关系数据(SQLite 支持加密,或 PostgreSQL)与文件对象(本地磁盘、S3、Google Cloud Storage、Azure Blob Storage),向量检索则可切换 ChromaDB、PGVector、Qdrant、Milvus、Elasticsearch、OpenSearch、Pinecone、S3Vector、Oracle 23ai 共 9 种后端。
工程结构上,前端 src/ 与后端 backend/ 同仓共存,避免了版本错配;pyproject.toml 把 Python 版本卡在 >=3.11, <3.13.0a1,说明它重度依赖新版语法与异步特性,硬上旧解释器会直接翻车。
四、核心对话主循环
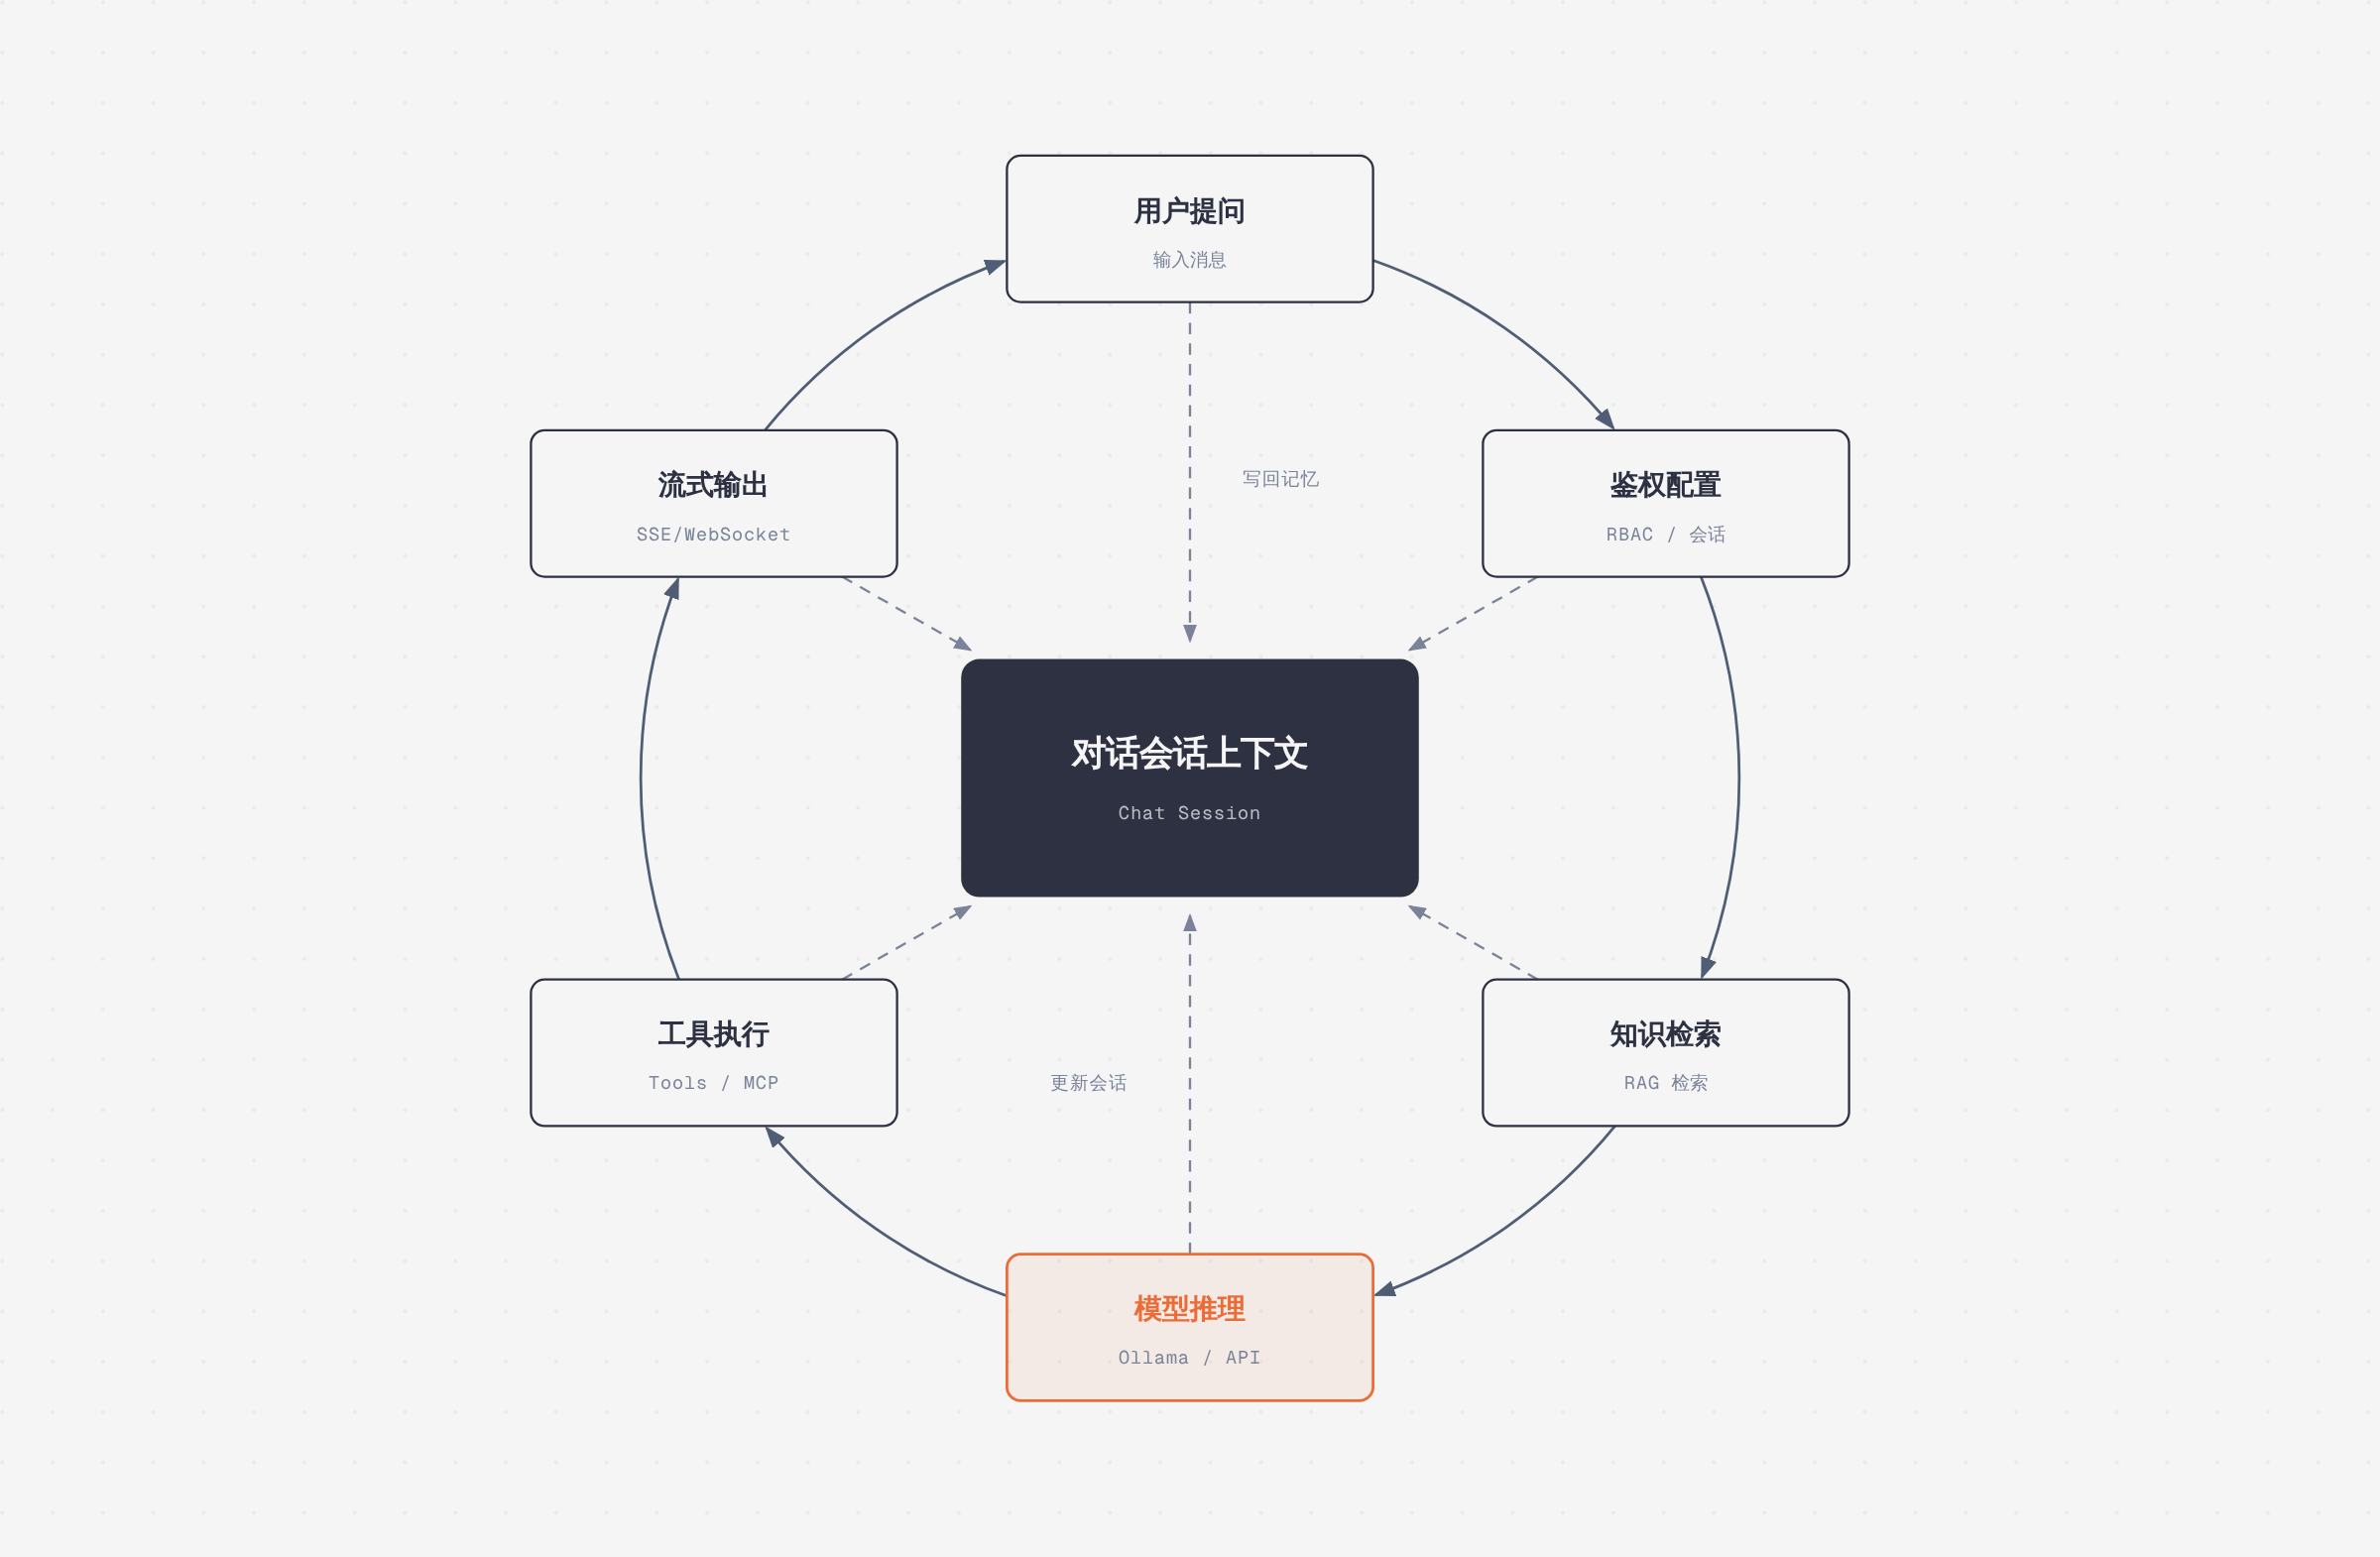
一次对话的闭环可以拆成六个站点,中枢是贯穿始终的「对话会话上下文」(Chat Session)。
第一站:用户提问。 消息从 PWA 发出,携带会话 ID、模型选择与附件;若使用 # 前缀,还会附带知识库或网页引用意图。
第二站:鉴权配置。 后端 API 先解析身份,校验用户与用户组对目标模型、知识库、工具链的权限,再装载该会话的配置——系统提示词、模型参数、启用的插件与工具集。这一站决定了后面能做什么、不能做什么。
第三站:知识检索。 若会话绑定了知识库或开启了 Web Search,RAG 工具在此介入:切分查询、混合检索(BM25 + 向量)、重排序,把命中的片段拼进上下文。这里是全流程最容易被低估的一站——检索质量直接决定模型输出质量,而多数「回答不准」的抱怨其实出在这一层。
第四站:模型推理。 这是主循环的焦点站。对话引擎把组装好的消息送给 Ollama 或 OpenAI 兼容端点,等待响应。多模型并行对话时,同一份上下文会被并发投递给多个模型,再并列展示。
第五站:工具执行。 模型返回工具调用意图后,引擎执行 Tools、MCP 或 OpenAPI 服务器上的函数,把返回值回灌给模型继续推理。这一站可能循环多次,直到模型不再请求工具。
第六站:流式输出。 结果以 SSE / WebSocket 逐块推给前端,用户可以看到实时生成的文字、构建中的清单、以及消息排队机制(AI 还在回答时可以先输入下一条,就绪后自动发送)。
循环闭合时,两条回写路径同时生效:写回记忆——值得长期保留的事实进入持久记忆;更新会话——本轮消息、Token 用量与工具轨迹落库,供下一轮与用量分析使用。
五、核心模块解析
| 模块 | 职责 |
|---|---|
backend/open_webui/ | 后端主体:FastAPI 路由、业务逻辑、模型提供商适配、鉴权与后台任务 |
src/lib、src/routes | 前端组件库与页面路由,SvelteKit 组织,负责聊天、工作区、管理后台等界面 |
| 插件与 Pipelines | 扩展机制:Filters 改写入出流量,Actions 挂载按钮,Pipes 自定义模型端点,Tools 提供函数调用;Pipelines 支持把扩展独立进程化 |
| 存储层 | SQLite / PostgreSQL 承载用户、会话、模型、知识库元数据;文件走本地或 S3 / GCS / Azure Blob;向量库可插拔替换 |
static/pyodide、static/sql.js | 浏览器内直接执行 Python 与 SQL 的运行时资产,支撑代码解释器类交互 |
backend/requirements-slim.txt | 精简依赖清单,用于裁剪镜像体积、去掉重型本地推理依赖的部署形态 |
这个划分透露出一个清晰的分工原则:后端是能力总线,前端是能力面板。所有模型、插件、存储的差异都被收敛到后端一层适配,前端只需要消费统一的 API 契约。好处是新增一个模型提供商不用动前端;代价是后端模块体积持续膨胀,单进程部署下的启动时间与内存占用也随之上涨。
六、特色能力
Notes 与 Channels 是把 Open WebUI 从「聊天工具」推向「协作平台」的两块拼图。Notes 提供一个对话之外的富文本工作区,可以用 AI 重写选中文本,并把笔记挂载到任意会话实现全上下文注入;Channels 则是团队与模型共处的时间线,支持 @ 模型起草或批评、话题线程、表情回应与置顶。
持久记忆与日历解决跨会话的连续性:AI 记住关于你的事实,从一个对话带到下一个;内置日历支持月/周/日视图、重复事件、参与者与提醒,模型可通过原生函数调用替你安排日程。Automations 进一步把提示词按周期调度执行,每次运行结果落到日历上,并链接回它产生的那个会话。
Open Terminal 是智能体能力的质变点:给智能体一个真实的终端和文件系统,让它读数据、跑脚本、看报错、改代码、产出文件,全部发生在聊天窗口内。企业版 Terminals 在此基础上补齐按用户隔离的容器、独立凭据、资源限额与网络规则,以及 Docker/Kubernetes 上的自动生命周期管理。
多模型对话与评测则面向选型场景:可以同时向多个模型提同一个问题并行比较,管理后台统计消息量、Token 消耗与成本,内置 arena、A/B 测试与基于 ELO 的排行榜。
七、工具链与生态
Open WebUI 已经从一个单一 Web 应用长成了一个带卫星的项目群:
- Open WebUI Computer:移动优先的独立计算机与编码智能体,跑在你自己的机器上,把文件、终端、Git 塞进一个浏览器标签页,可从手机访问,也可作为模型接回 Open WebUI。
- Open Terminal / Terminals (Enterprise):前文提到的自托管计算环境及其团队版。
- oikb:把 GitHub、Confluence、ServiceNow、Salesforce、Jira、Slack、SharePoint、Notion 等 45+ 数据源持续同步进知识库,解决「RAG 里的文档永远是三个月前的」这一顽疾。
- Native Desktop App:macOS / Windows / Linux 原生客户端,带系统级 Spotlight 式聊天栏、截图提问、按住说话,并可选用内置 llama.cpp 引擎做完全本地推理。
- 扩展协议与社区:MCP、MCPO 与 OpenAPI 工具服务器构成对外集成的统一入口;Open WebUI Community 提供预设(模型配置、智能体、提示词)一键导入。 这套布局的意图很明显:Web 端做中枢,其余端做触点。模型跑在哪、人在哪访问、数据从哪来,都不再受限于单一形态。
八、部署与安全
部署侧提供 pip / uv / Docker / Docker Compose / Kustomize / Helm 全谱系方案,官方镜像额外提供 :ollama(内置 Ollama)与 :cuda(GPU 加速,需 Nvidia Container Toolkit)标签;离线环境设 HF_HUB_OFFLINE=1 可阻止联网下载模型。
规模化路径是 Redis 支撑的会话管理与 WebSocket,使多 worker、多节点部署可以放在负载均衡之后;可观测性方面内置 OpenTelemetry 的 traces、metrics、logs,直接接入现有监控栈。
安全与企业集成是这个项目近两年发力最猛的方向:管理员可以定义角色、用户组与权限矩阵,实现「每个用户恰好拿到该拿的东西」;认证侧支持 LDAP/Active Directory、可信头与 OAuth 的 SSO,以及面向 Okta、Azure AD、Google Workspace 的 SCIM 2.0 自动供给。云盘侧原生集成 Google Drive 与 OneDrive/SharePoint 文件选择。漏洞走 GitHub 私有披露流程,修复后以公开 advisory 发布。
九、适用场景
个人本地工作台是最轻的用法:一台带显卡的机器,一个 :ollama 容器,就得到一个带 RAG、图像生成、语音输入的私人 AI 界面,数据不出本机。
团队共享 AI 协作空间适合十几到几十人的组织:用 Channels 做共享时间线,用用户组控制模型与知识库可见性,用用量分析看清成本花在哪。
企业内网离线部署是它最能打的场景——全离线、可接 LDAP/SSO、支持 PostgreSQL 与对象存储、可插 SCIM,几乎是照着企业 IT 的合规清单设计的。
多模型评测与选型则适合需要横向对比模型质量的团队:并行对话、A/B 测试与 ELO 排行榜把主观感受变成可比较的分数。
十、总结评价
Open WebUI 的真正价值,不在于它有一个好看的聊天界面,而在于它把「接入任意模型、挂载任意工具、接上任意知识源、并施加企业级权限」这四件事做成了同一套可自托管的系统。在它出现之前,这些东西需要团队自己拼装三到五个开源组件;现在是一条 docker run 的距离。这是它拿到 15 万 Stars 的实质原因,而不是界面好看。
适用人群也很明确:想让本地模型有个像样门面的个人用户、需要内部 AI 入口但不愿把数据交给第三方的中小团队、以及有离线与合规硬约束的企业 IT。反过来,如果你的需求是「一个极简的 API 网关」或者「单纯的模型推理服务」,这个项目的体量会显得冗余。
局限同样要讲清楚。第一,它是一个持续膨胀的 Python 单体,功能密度越高,升级与排障的心智负担越大,SQLite 默认配置下并发写入会成为瓶颈,生产环境基本必须换 PostgreSQL + Redis。第二,插件与工具执行是天然的攻击面,社区插件可以直接触碰会话数据与外部服务,企业环境应把它当作代码审计对象而非配置项。第三,许可不是标准开源许可,品牌保留条款会直接影响白标与二次分发方案,商业使用前务必读 LICENSE 与 LICENSE_HISTORY。第四,企业级能力存在分层(如 Terminals 的按用户隔离环境),开源版与商业版的边界需要在选型阶段就确认。
一句话结论:如果你的目标是给组织一个自主可控的 AI 入口,Open WebUI 目前是默认答案——但请按「引入一套基础设施」而非「装一个工具」的心态去评估它。
参考链接:项目仓库 https://github.com/open-webui/open-webui | 官网与文档 https://openwebui.com / https://docs.openwebui.com