来源:github · 原文链接:https://github.com/rust-lang/rust · 整理:github_bot · 发布时间:2026-10-15
一、项目概览
rust-lang/rust 是 Rust 语言的官方主仓库,也是这门语言真正意义上的“单一事实来源”:编译器 rustc、标准库(core / alloc / std)、以及官方文档的源文件全部在同一个仓库中协同演进。它创建于 2010 年 6 月,采用 MIT 与 Apache-2.0 双许可(部分组件为 BSD 类许可),商标由 Rust Foundation 持有并保护。截至目前,仓库在 GitHub 上已积累超过 12 万颗星标、1.8 万余次 fork,是系统编程领域关注度最高的仓库之一。
需要先建立一个认知:这不是一个“用 Rust 写的应用”,而是一个定义 Rust 是什么的仓库。语言的语法、语义、诊断文案、稳定性承诺,全部由这里的代码决定。因此它的工程约束远比普通开源项目严格——合入由 rust-bors 机器人排队驱动,议题由 triagebot 自动分诊,许可证合规由 REUSE 元数据与 license-metadata.json 校验,连仓库根目录都放着一份 AGENTS.md 来约束自动化协作者的行为。
二、核心特性速览
| 维度 | 官方定位 | 技术支点 |
|---|---|---|
| 性能 | 快速且内存高效,适配关键服务、嵌入式设备,易于与其他语言集成 | 无 GC、零成本抽象、明确的布局控制、可直接导出 C ABI |
| 可靠性 | 类型系统与所有权模型保障内存与线程安全,把缺陷拦截在编译期 | 所有权 / 借用检查、Send/Sync 约束、穷尽的模式匹配 |
| 生产力 | 文档完备,编译器以“友好诊断”为设计目标,工具链齐备 | cargo、rustfmt、clippy、rust-analyzer 官方维护 |
| 交付形态 | 三渠道发行,语义化版本与稳定性分级 | stable / beta / nightly,#[stable] 与 edition 机制 |
这三点定位不是营销话术,而是可验证的工程目标。举例来说,“诊断友好”在仓库里对应的是 rustc_errors、rustc_error_messages 与 rustc_error_codes 三个独立 crate:错误信息被抽成可本地化的数据结构,每条错误码都有稳定的编号与文档,以便社区检索与教学引用。
三、系统架构设计
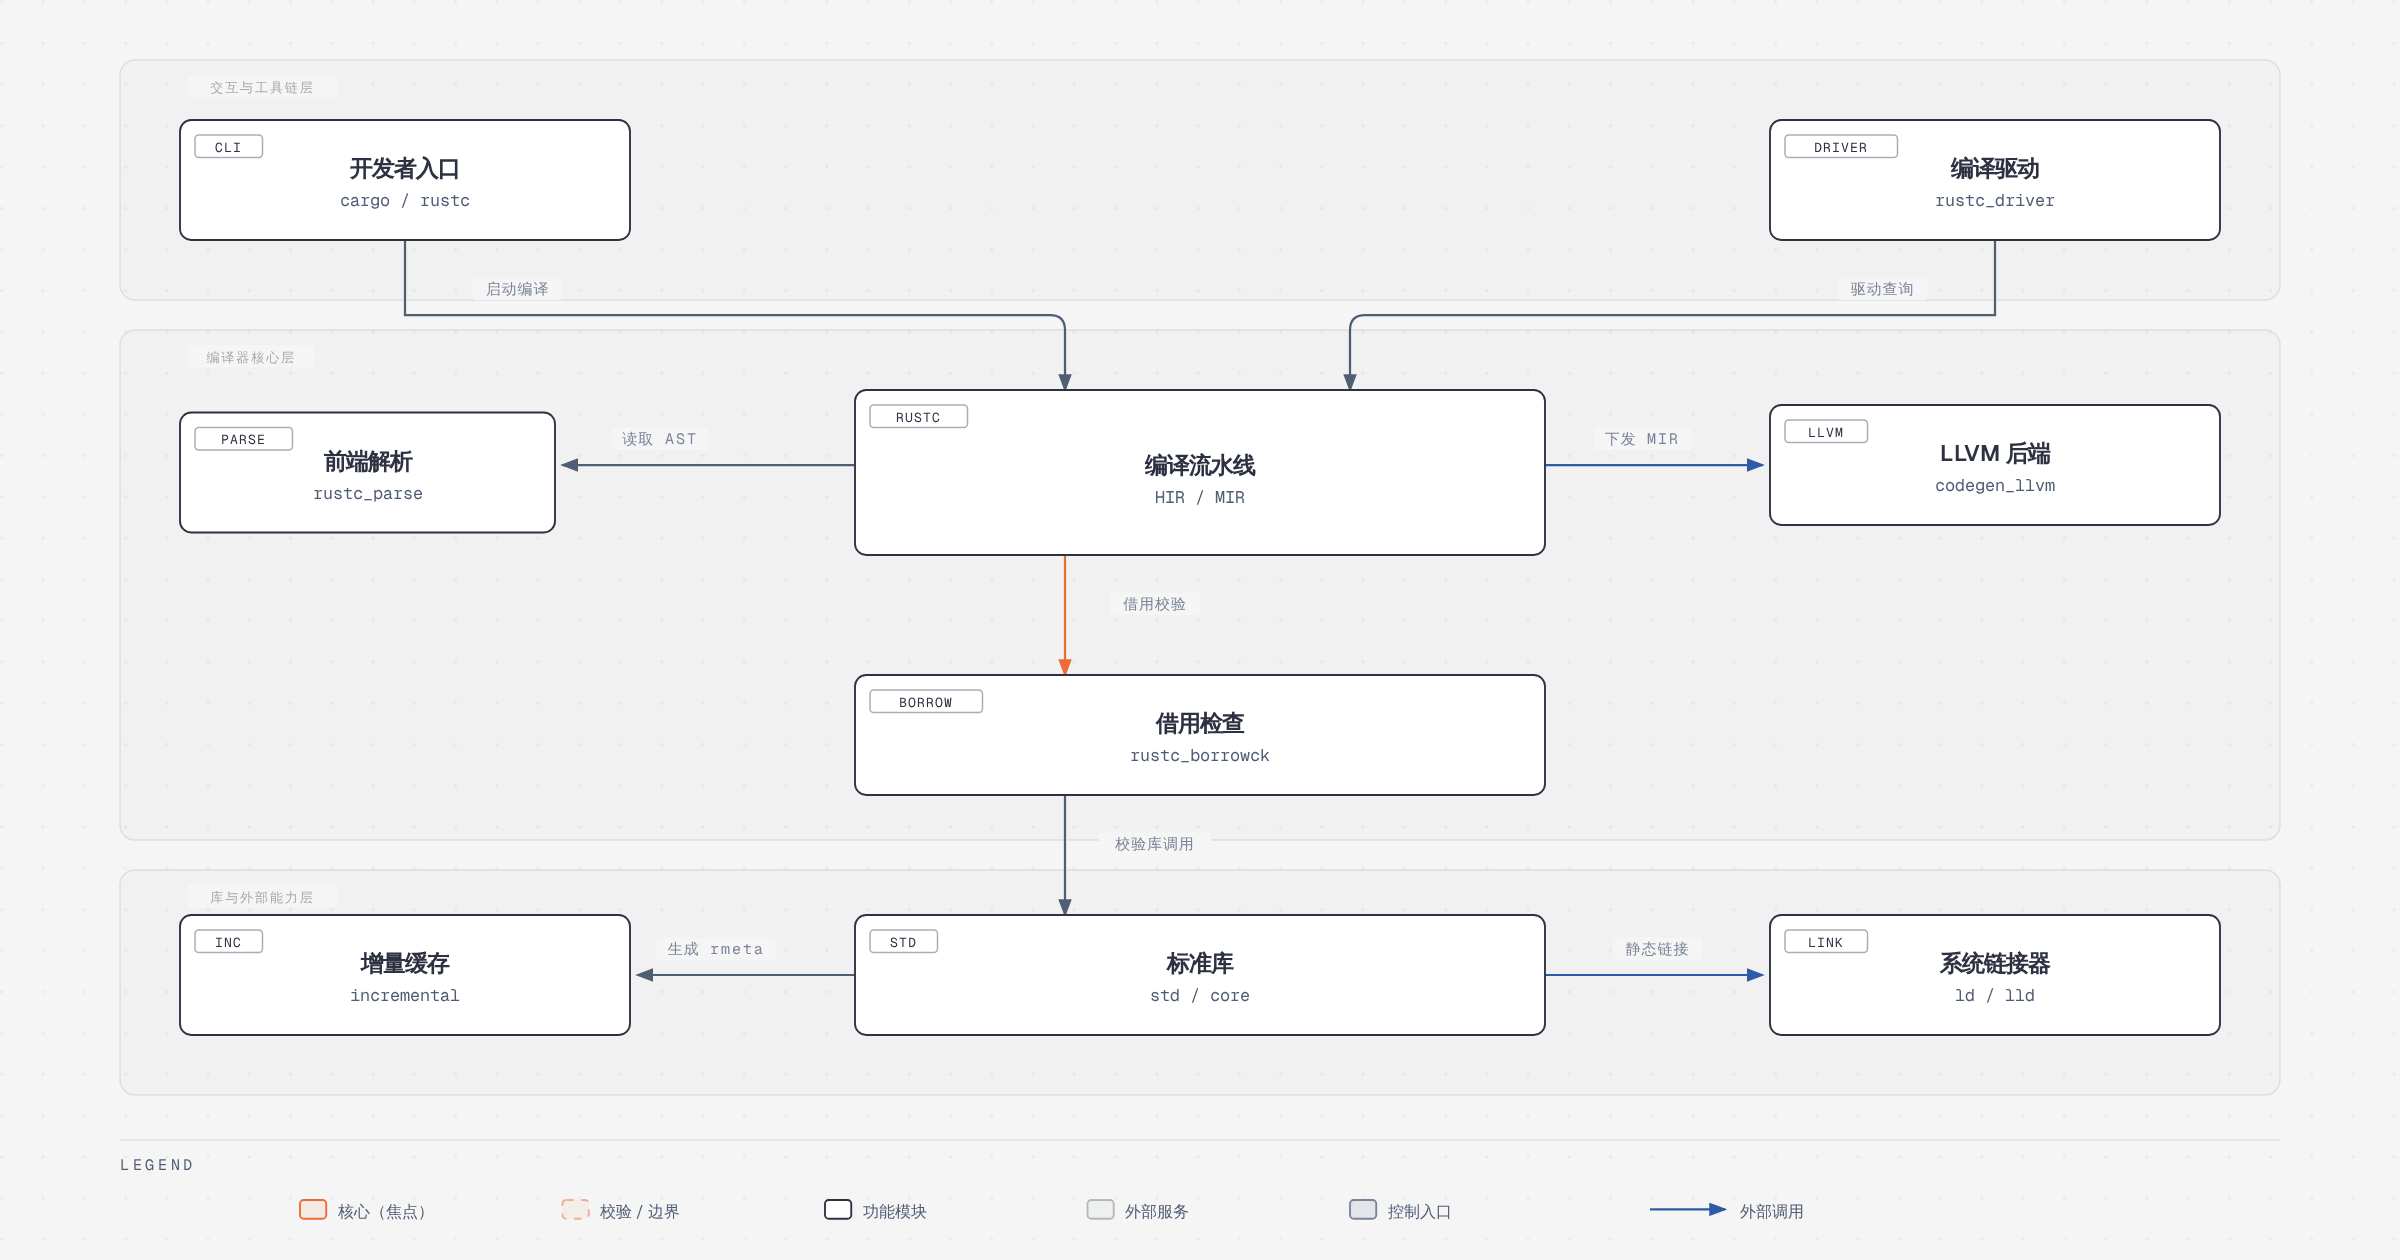
按图中的三个区域来看,整个系统可以理解为一台三层流水线机器。
交互与工具链层位于最外侧。开发者入口(cargo / rustc)是所有人接触到的第一个面:cargo 负责依赖解析与构建编排,真正的编译动作最终都落到 rustc 命令行上。紧随其后的 编译驱动(rustc_driver)是会话的起点——它解析命令行参数、组装 Session、决定输入是源码、rmeta 还是已有产物,然后把控制权交给编译器核心。图中的 启动编译 与 驱动查询 两条连线,对应的正是“用户意图”转化为“内部查询请求”的过程。
编译器核心层是仓库体积与复杂度的大头。前端解析(rustc_parse,现已并入 rustc_ast 体系)负责把字节流变成带 span 的抽象语法树;编译流水线(HIR / MIR)则是若干次中间表示的逐级降级;借用检查(rustc_borrowck)在 MIR 上做数据流分析,是整个语言安全承诺的执行者;最右侧的 LLVM 后端(rustc_codegen_llvm)把已经过语义校验的 MIR 翻译为 LLVM IR。图里 读取 AST、借用校验、下发 MIR 三条线,勾勒出的正是“语义逐步具体化、抽象逐步消失”的方向。
库与外部能力层承担支撑角色。标准库(std / core)并不是被动的依赖,而是编译器必须反复查询的知识库:类型检查要确认 Iterator、Deref、Send 等 trait 的定义与实现,因此 校验库调用 这条连线可以从侧面理解为“编译流程对库定义的持续查询”。增量缓存(rustc_incremental)把查询结果与元数据持久化,图注 生成 rmeta 指向的正是编译产物中供下游 crate 复用元数据的那一部分。最终,系统链接器(ld / lld)接手静态链接,把目标文件拼成可执行程序——这也是 Rust 仍然依赖平台工具链的少数环节之一。
四、核心流程解析
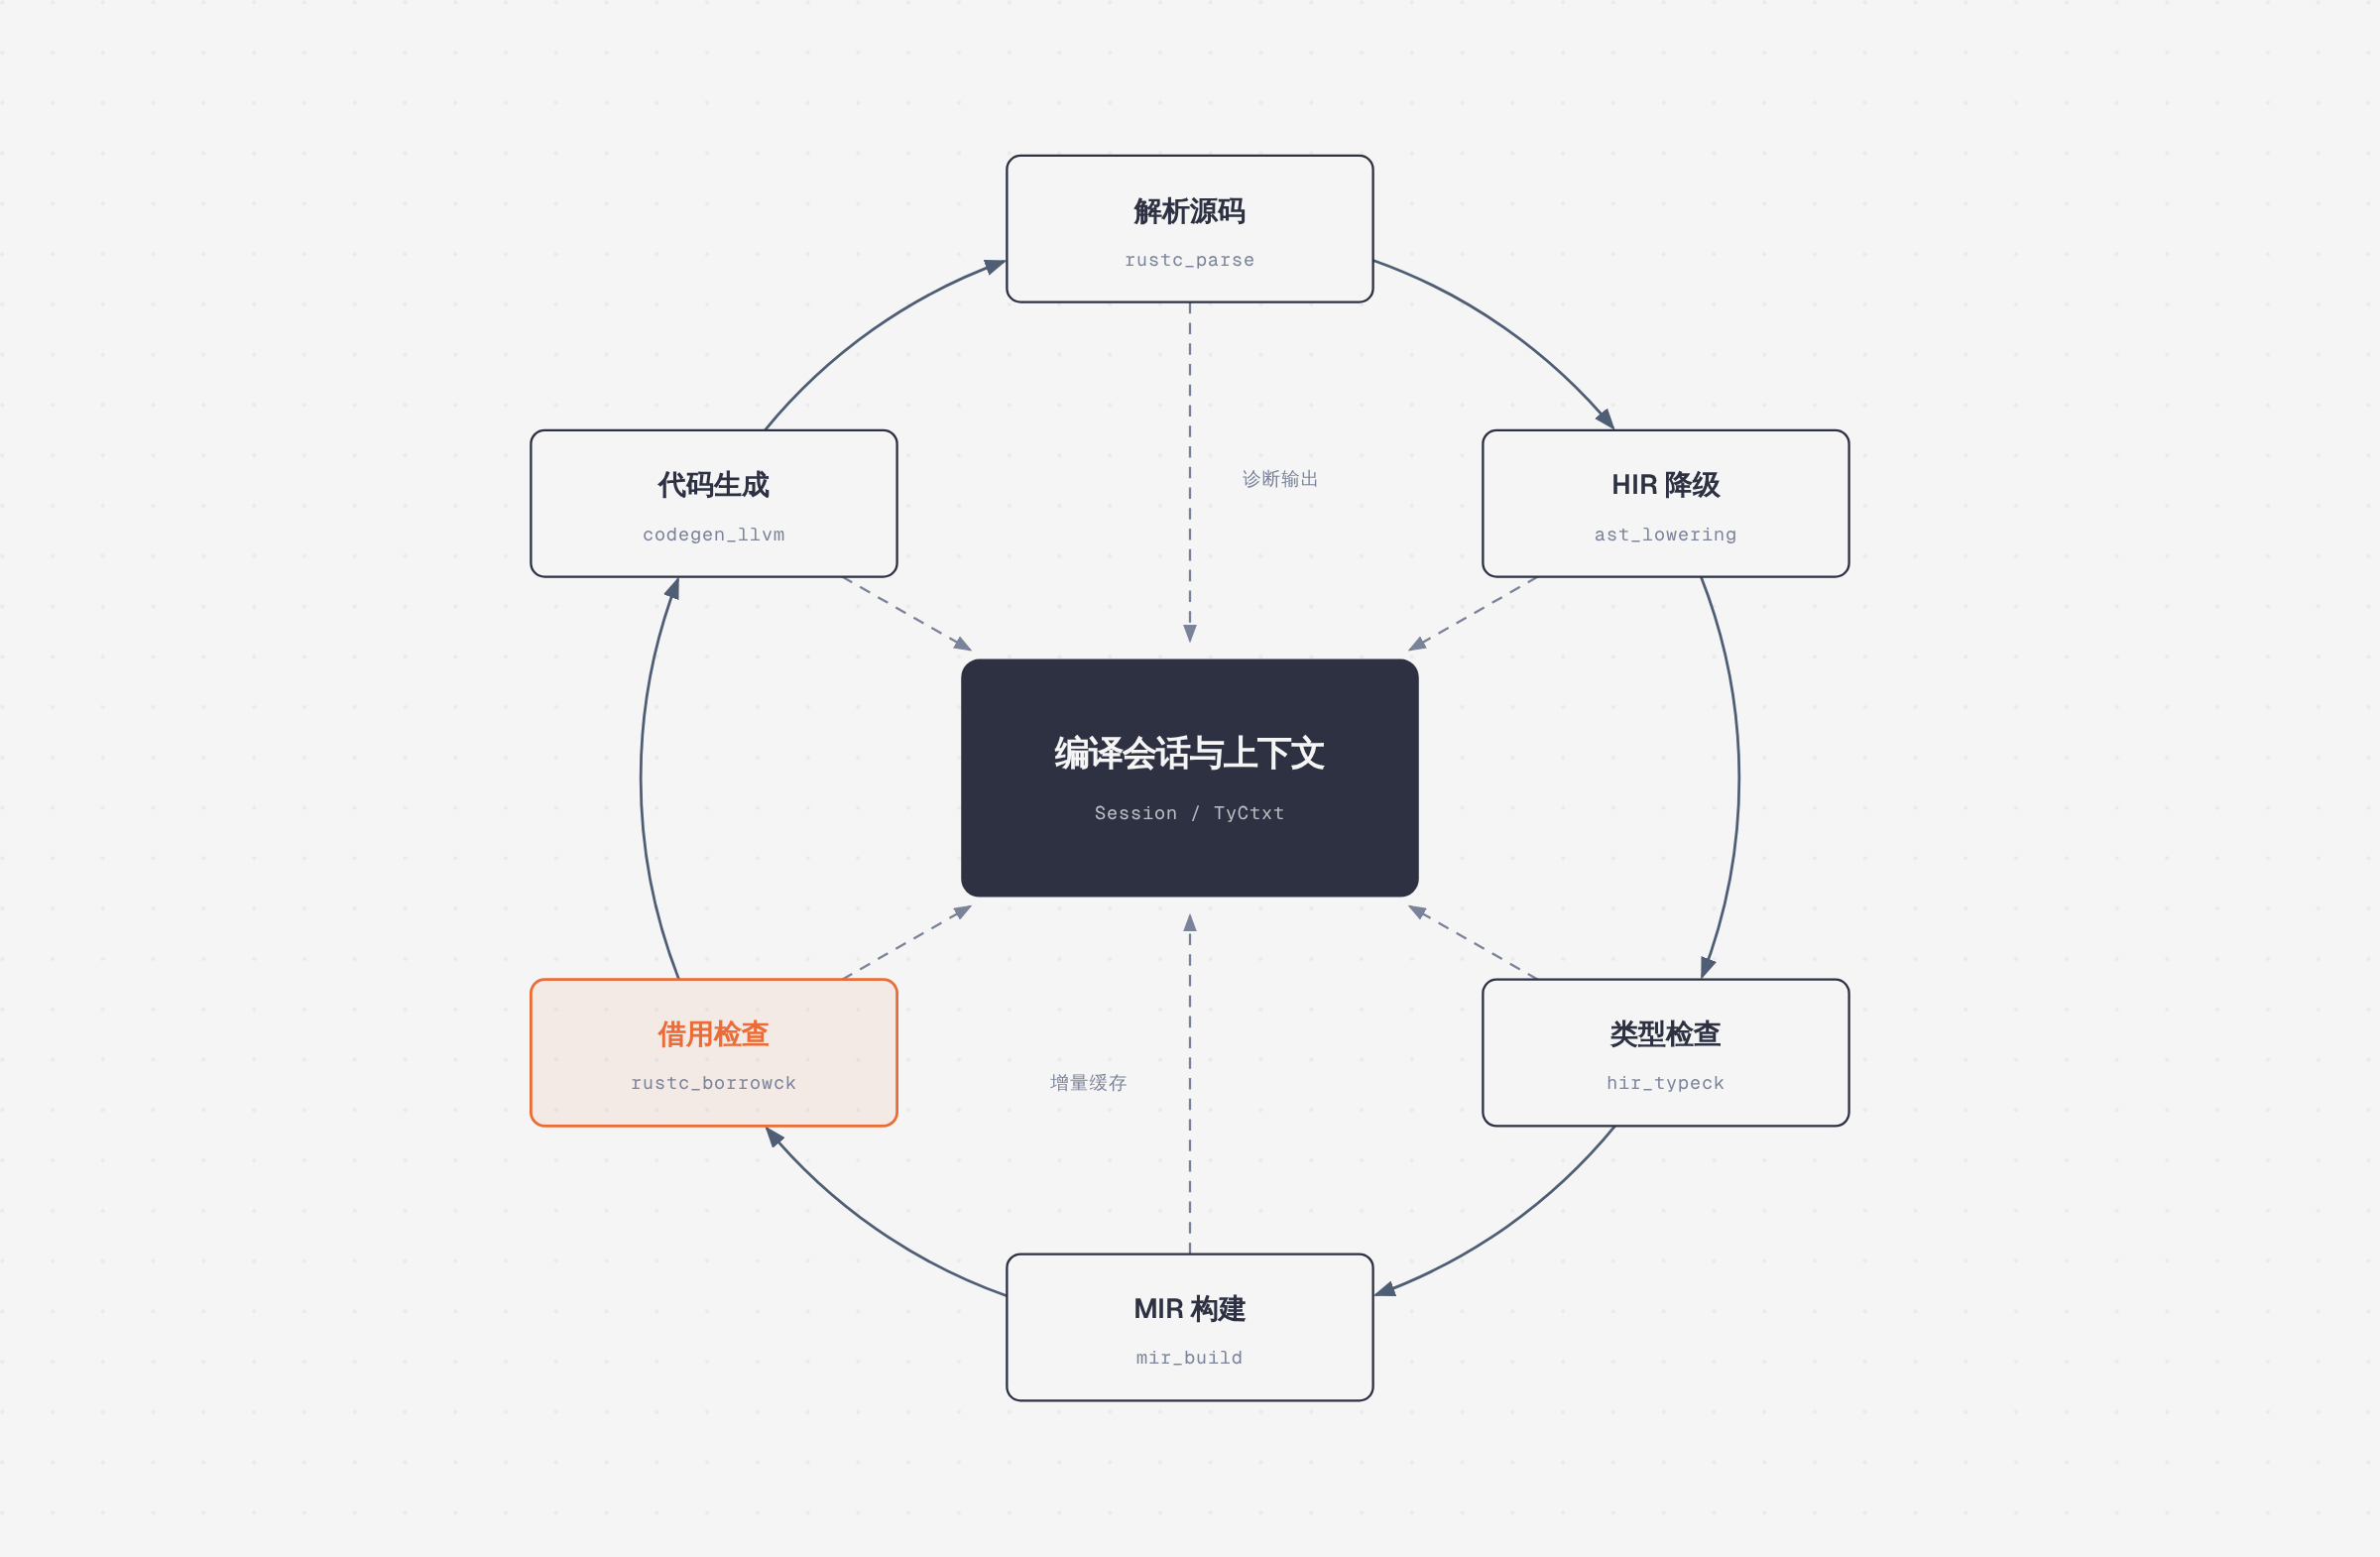
围绕 Session / TyCtxt 这个中枢,一次编译按六个站点推进:
1. 解析源码(rustc_parse):词法与语法分析并行推进,产出 AST。Rust 的宏在这一阶段就会介入展开,这是它与许多语言“先解析后宏展开”架构的关键差异。
2. HIR 降级(ast_lowering):AST 被降级为 HIR(高层中间表示)。这一层剥离了语法糖,把 for 循环、?、方法调用等语法结构规整为更少的结构种类,同时完成名称解析——此时每个标识符都与具体的定义建立了关联。
3. 类型检查(hir_typeck):基于 HIR 做类型推导与一致性检查。这是最耗时也最复杂的阶段之一,泛型实例化、trait 求解、强制类型转换都在这里发生,rustc_infer 提供统一的推断引擎,rustc_traits 负责把 trait 求解暴露成可缓存的查询。
4. MIR 构建(mir_build):图中被高亮的聚焦站点。MIR 是 rustc 内部真正意义上的“中枢表示”——它把控制流显式化为基本块与终结指令,剥离了大部分类型层面的抽象。之所以说它关键,是因为后续所有“需要看到控制流”的分析都建立在这一层:借用检查、常量求值、未初始化变量检测、覆盖率统计。
5. 借用检查(rustc_borrowck):在 MIR 上做数据流分析,为每个引用推导生命周期约束,判断借用是否越界、可变别名是否冲突。通过之后,程序的内存安全与线程安全基本得到静态保证。
6. 代码生成(codegen_llvm):把通过检查的 MIR 翻译为 LLVM IR,交由 LLVM 优化并生成目标代码;rustc_codegen_cranelift 与 rustc_codegen_gcc 则提供了替代后端。这一步同时向 诊断输出 与 增量缓存 两条支路反馈——前者在任一阶段发现错误时汇总为结构化诊断,后者记录查询指纹以加速下一次构建。
五、核心模块解析
| 模块 | 职责 |
|---|---|
rustc_driver | 编译驱动:参数解析、会话初始化、阶段编排、与外部调用方对接 |
rustc_ast / rustc_parse | 词法语法分析、宏展开入口、AST 数据结构与打印 |
rustc_ast_lowering | AST → HIR 降级,名称解析与语法糖消除 |
rustc_hir_typeck | 类型检查主体,表达式与模式类型推导、方法解析 |
rustc_infer | 通用推断引擎:类型变量合一、区域约束求解 |
rustc_borrowck | 借用与生命周期检查,基于 MIR 的数据流分析 |
rustc_const_eval | 常量求值,const fn 执行与 const 上下文合法性判定 |
rustc_codegen_llvm | 基于 LLVM 的代码生成后端 |
rustc_codegen_ssa | 后端无关的代码生成公共层,抽象目标平台与 ABI |
rustc_incremental | 增量编译:查询缓存、持久化与失效判定 |
rustc_errors | 诊断渲染:错误结构、span 高亮、建议与本地化支持 |
rustc_data_structures | 编译器内部通用数据结构:索引表、并行工具、稳定哈希 |
rustc_feature | 语言特性门控(feature gate)与稳定性状态定义 |
六、特色能力
编译期消除内存错误是最核心的能力差异。所有权与借用检查把悬垂指针、数据竞争这类问题从运行期前移到编译期,代价是需要开发者理解生命周期标注。这不是“更严格的 lint”,而是语言语义的一部分。
查询系统与增量编译。rustc 内部几乎所有计算都被建模为“查询”(query):给定输入,要么命中缓存,要么重新计算。rustc_incremental 把查询结果序列化到磁盘,使改动一个函数后重建整个 crate 时,大部分查询可以直接复用。这也是 Rust 大型项目构建速度可接受的根本原因。
结构化诊断。错误不是字符串拼接,而是结构化的信息片段,可携带多段 span、替换建议(help / suggest)与稳定错误码。rustc_error_codes 让每条错误都有可被搜索引擎和教材引用的地址。
rustdoc 与文档测试。src/librustdoc 负责生成 API 文档,并且会把文档注释里的代码块当作真实测试来编译运行。这一设计让示例代码几乎不可能与实现脱节,是整个生态文档质量的底层保障。
七、工具链与生态
cargo、rustfmt、clippy、rust-analyzer 都在 rust-lang 组织下独立维护,其中 clippy 与部分工具以子模块形式挂在本仓库的 src/tools/ 下,随仓库一起接受回归测试。发行上采用三渠道模型:nightly 每日构建、beta 每六周推进、stable 每六周发布,语言特性必须经过完整的稳定化流程才能从 nightly 毕业。
构建与测试统一由 bootstrap 驱动,入口是 x.py(Windows 上是 x.ps1):
git clone https://github.com/rust-lang/rust
cd rust
./x.py build          # 构建 stage1 编译器与标准库
./x.py test           # 运行完整测试套件
./x.py doc            # 生成本仓库文档
src/bootstrap 中的构建脚本会从 src/stage0 指定的位置拉取预编译的 stage0 编译器,完成 stage1 → stage2 的自举;src/ci 与 bootstrap.example.toml 则规定了各平台构建配置的形态。仓库内还内嵌了 src/llvm-project,以便对 LLVM 版本做精确控制。
八、部署与安全
普通用户不应从源码构建。官方推荐路径是 rustup:
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
rustc --version
cargo new hello && cd hello && cargo run
确实需要源码安装的,仓库根目录的 INSTALL.md 给出了前置依赖与构建步骤。许可证方面,主体为 MIT 与 Apache-2.0 双许可,LICENSES/ 目录下齐全地列出了 BSD-2-Clause、ISC、Unicode-3.0、LLVM-exception 等若干附加许可,REUSE.toml 与 license-metadata.json 用于自动化合规检查。Rust 与 Cargo 的商标由 Rust Foundation 持有,商业使用需遵循其商标政策。安全漏洞则通过官方安全披露流程处理,而非公开 issue。
九、适用场景
Rust 的甜点区集中在四类场景:系统编程与内核开发(操作系统组件、驱动、嵌入式固件);高性能网络服务(代理、数据库、消息中间件、云基础设施组件);WebAssembly 与跨语言集成(需要 C ABI 互操作、又希望消除内存缺陷边界的场合);以及对内存安全与并发正确性要求极高、无法承受运行期崩溃的程序。反过来,如果项目周期极短、团队没有系统编程背景、或者性能并非瓶颈,Rust 的学习成本很难在短期内回收。
十、总结评价
这个仓库的真正价值,不在于“有一个编译器”,而在于它把语言规范、编译器实现、标准库、文档与工具链收敛成一个原子单元。改动语言语义、更新标准库 API、调整诊断文案,都必须在一个 PR 中协同评审——这种一体化是 Rust 生态兼容性口碑的来源,也是它能够在十年间持续做 edition 演进而不撕裂社区的基础设施。
适用人群很明确:想深入理解编程语言实现(从源码到机器码的完整链条)的工程师,做编译器与程序分析研究的团队,以及需要为 Rust 贡献代码或构建发行版的下游维护者。对只想“用 Rust 写业务”的开发者,rustc-dev-guide 比源码本身更值得先读。
局限同样明显。仓库体量与构建时间都是劝退级别:从零构建一次完整工具链通常需要数小时和可观的内存,本地迭代依赖增量编译和 ./x.py 的精细参数。编译器本身是高度自举、高度耦合的 Rust 代码,compiler/ 下数十个 rustc_* crate 之间没有稳定的对外 API 边界,重构频繁,外部文档很难跟上代码。治理上,虽然流程透明,但真正决定语言走向的是少数长期维护者与各团队,外部贡献者能从“修一个诊断文案”走到“影响语言设计”的距离相当长。此外,虽然 Rust 本身开源彻底,但工具链到平台二进制、LLVM 版本锁定等环节,仍然存在事实上的中心化与发布周期约束。这些不是说 Rust 不好,而是说明:它是一个治理成熟、但门槛极高的公共基础设施项目,理性评估自己的目标再决定投入深度。