来源:github · 原文链接:https://github.com/zubair-trabzada/geo-seo-claude · 整理:github_bot · 发布时间:2026-10-20
一、项目概览
geo-seo-claude 是一个面向 Claude Code 的“技能包”(skill),它把生成式引擎优化(GEO, Generative Engine Optimization)拆解成一套可执行、可复用的审计流程。它的定位非常明确:GEO-first、SEO-supported —— 优先服务于 ChatGPT、Claude、Perplexity、Gemini 和 Google AI Overviews 这类 AI 搜索入口,同时不放弃传统 SEO 的基础设施(可抓取性、结构化数据、Core Web Vitals)。
项目采用 Python 3.10+ 实现,遵循 MIT 许可;在 GitHub 上已积累约 11.1k stars 与 1.7k forks,从 2026 年初创建到 10 月的持续推送来看,仍在高频迭代(仓库里还留有 pr-draft-agent-http-checks.md、pr-draft-content-signals.md 这类待合并草稿,说明作者正在为子代理补充 HTTP 层检查与内容信号维度)。
它的形态值得特别注意:它不是一个独立运行的 SaaS,也不是一个可以 pip install 的库,而是寄生在 Claude Code 里的斜杠命令集合。装好之后,你在 Claude Code 里输入 /geo audit https://example.com,一组子代理会被并行唤起,抓取页面、检查 robots.txt、扫描跨平台品牌提及、生成 PDF 交付文档。这个“把方法论封装成 AI Agent 可调用的工具链”的思路,是它区别于传统 SEO 桌面工具的核心差异。
二、核心特性速览
| 特性 | 说明 |
|---|---|
| Citability 评分 | 识别 134–167 词、自包含、事实密集的“AI 易引用段落”,按内容块给分而非整页给分 |
| AI 爬虫准入分析 | 解析 robots.txt,覆盖 GPTBot、ClaudeBot、PerplexityBot 等 14+ AI 爬虫,输出 allow/block 建议 |
| 品牌提及扫描 | 覆盖 YouTube、Reddit、Wikipedia、LinkedIn 等 10+ 平台,回应“品牌提及与 AI 可见性相关性是外链 3 倍”的观察 |
| llms.txt 支持 | 校验或生成这一新兴标准文件,帮助 AI 爬虫理解站点结构 |
| 平台差异化优化 | 针对 ChatGPT、Perplexity、Google AIO 分别给建议(同一查询双平台同时引用的域名仅 11%) |
| 可交付报告 | Markdown 与 PDF 双通道,PDF 含分数仪表盘、柱状图、平台就绪度可视化 |
| 轻量 CRM | prospect / proposal / compare 三条命令,把审计结果接进线索漏斗与月度增量追踪 |
其中“段落级引用就绪度”是最有方法论价值的一条。传统 SEO 关心页面级关键词覆盖,而 AI 摘要的取用单位是段落。项目把 134–167 词这一区间作为经验上的最佳引用长度,实际上是在编码一个可验证的假设:足够长以承载完整论证,足够短以不被截断。
三、系统架构设计
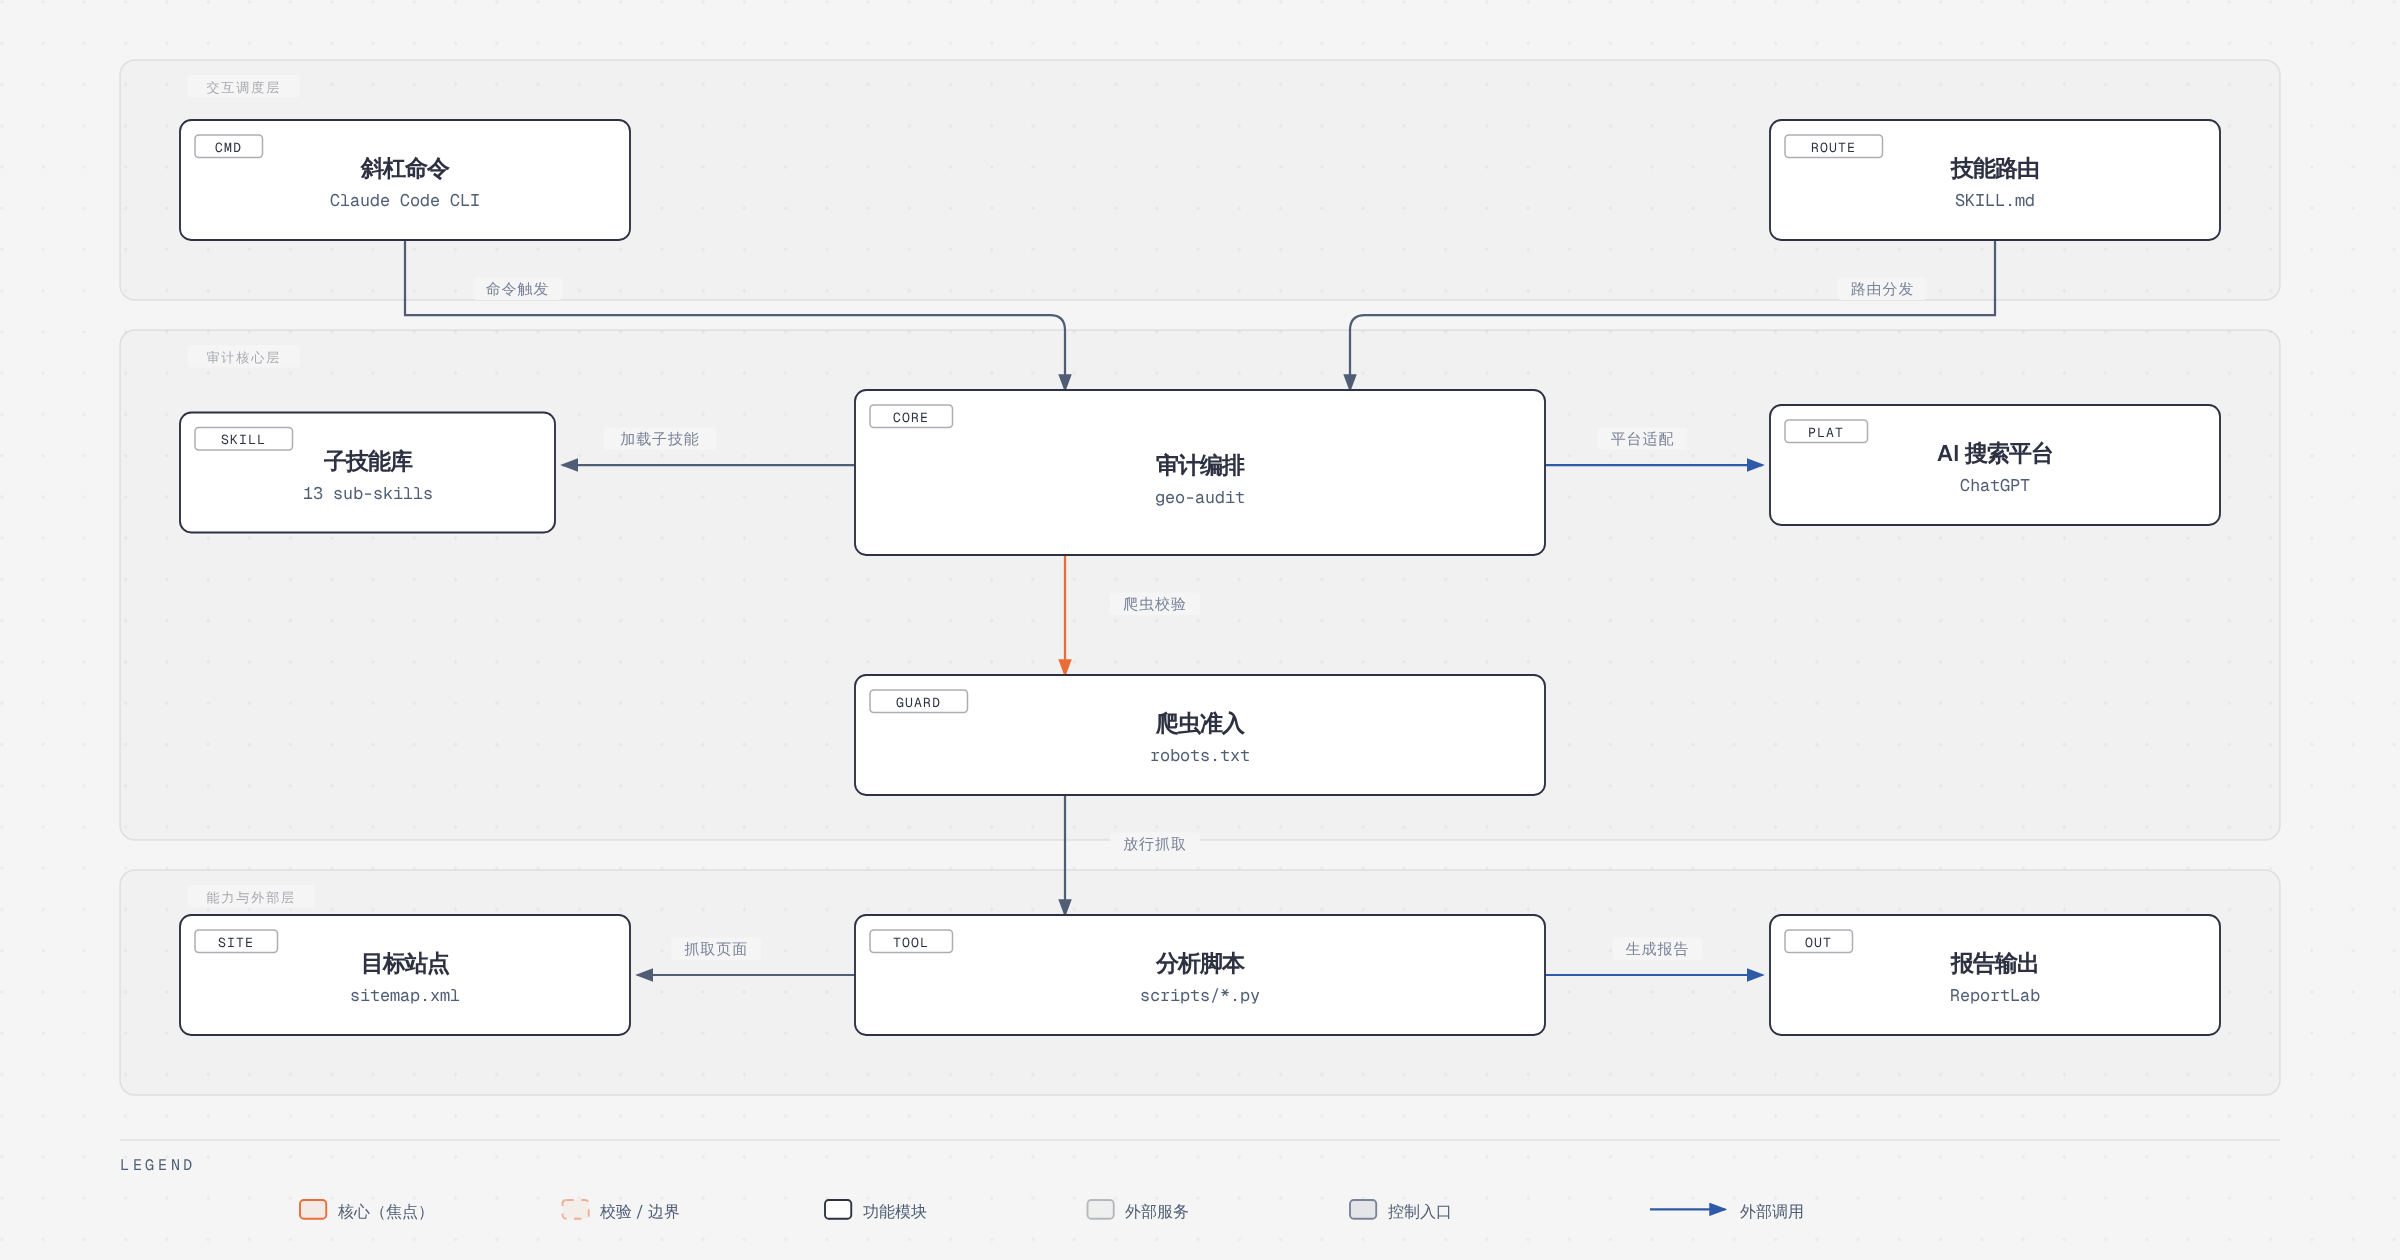
整个系统可以按三层来读。
交互调度层由两个节点构成:入口是 Claude Code CLI 中的斜杠命令(entry,CMD),下游是 geo/SKILL.md 承担的技能路由(api,ROUTE)。SKILL.md 本质是一份声明式的命令表加路由规则——它不写业务逻辑,只负责把 /geo audit、/geo citability、/geo report-pdf 这类指令映射到对应的子技能,并把参数(目标 URL)透传下去。这种“路由与实现分离”的设计让新增命令的成本极低:加一个 geo/ 下的子技能目录并在 SKILL.md 里登记一行即可。
审计核心层是重心所在。geo-audit(core,CORE)是编排者,它一边向 skills/ 加载子技能(side1,SKILL,13 个专项目录),一边向 agents/ 派生 5 个并行子代理。这里的架构选择很关键:子技能是“知识”,子代理是“执行者”。子技能目录里装的是评分标准、检查清单、输出模板;子代理则是真正跑起来的上下文,各自领取一个维度(AI 可见性、平台分析、技术 SEO、内容与 E-E-A-T、Schema),互不阻塞。审计核心层还向外连接 AI 搜索平台(side2,PLAT),把平台侧的引用偏好作为适配依据回灌到建议生成。
能力与外部层负责实际动作。爬虫准入(guard,GUARD)是横切关卡——先校验 robots.txt 是否放行目标爬虫,通过后才进入分析脚本(tools,TOOL,即 scripts/*.py)。脚本层对外抓取目标站点(data,SITE,含 sitemap.xml 遍历),对内产出结构化中间结果,最终交给报告输出(exec,OUT,PDF 由 ReportLab 驱动)。这条 GUARD → TOOL → SITE → OUT 的链路很务实:它把“能不能抓”放在“抓到什么”之前,避免了在合规性存疑的站点上白跑一遍全量分析。
一个容易被忽略但很聪明的细节是:schema/ 与 templates/、white-label/ 把“可变部分”外置了。JSON-LD 模板(Organization、LocalBusiness、Article+Person、SoftwareApplication、Product、WebSite+SearchAction)是纯数据文件,报告样式是 CSS + HTML 模板,品牌信息走 brand.example.json 风格的配置。这意味着代理机构改配色、换 logo、加自己的 schema 类型,都不需要碰 Python 代码。
四、核心流程或主循环
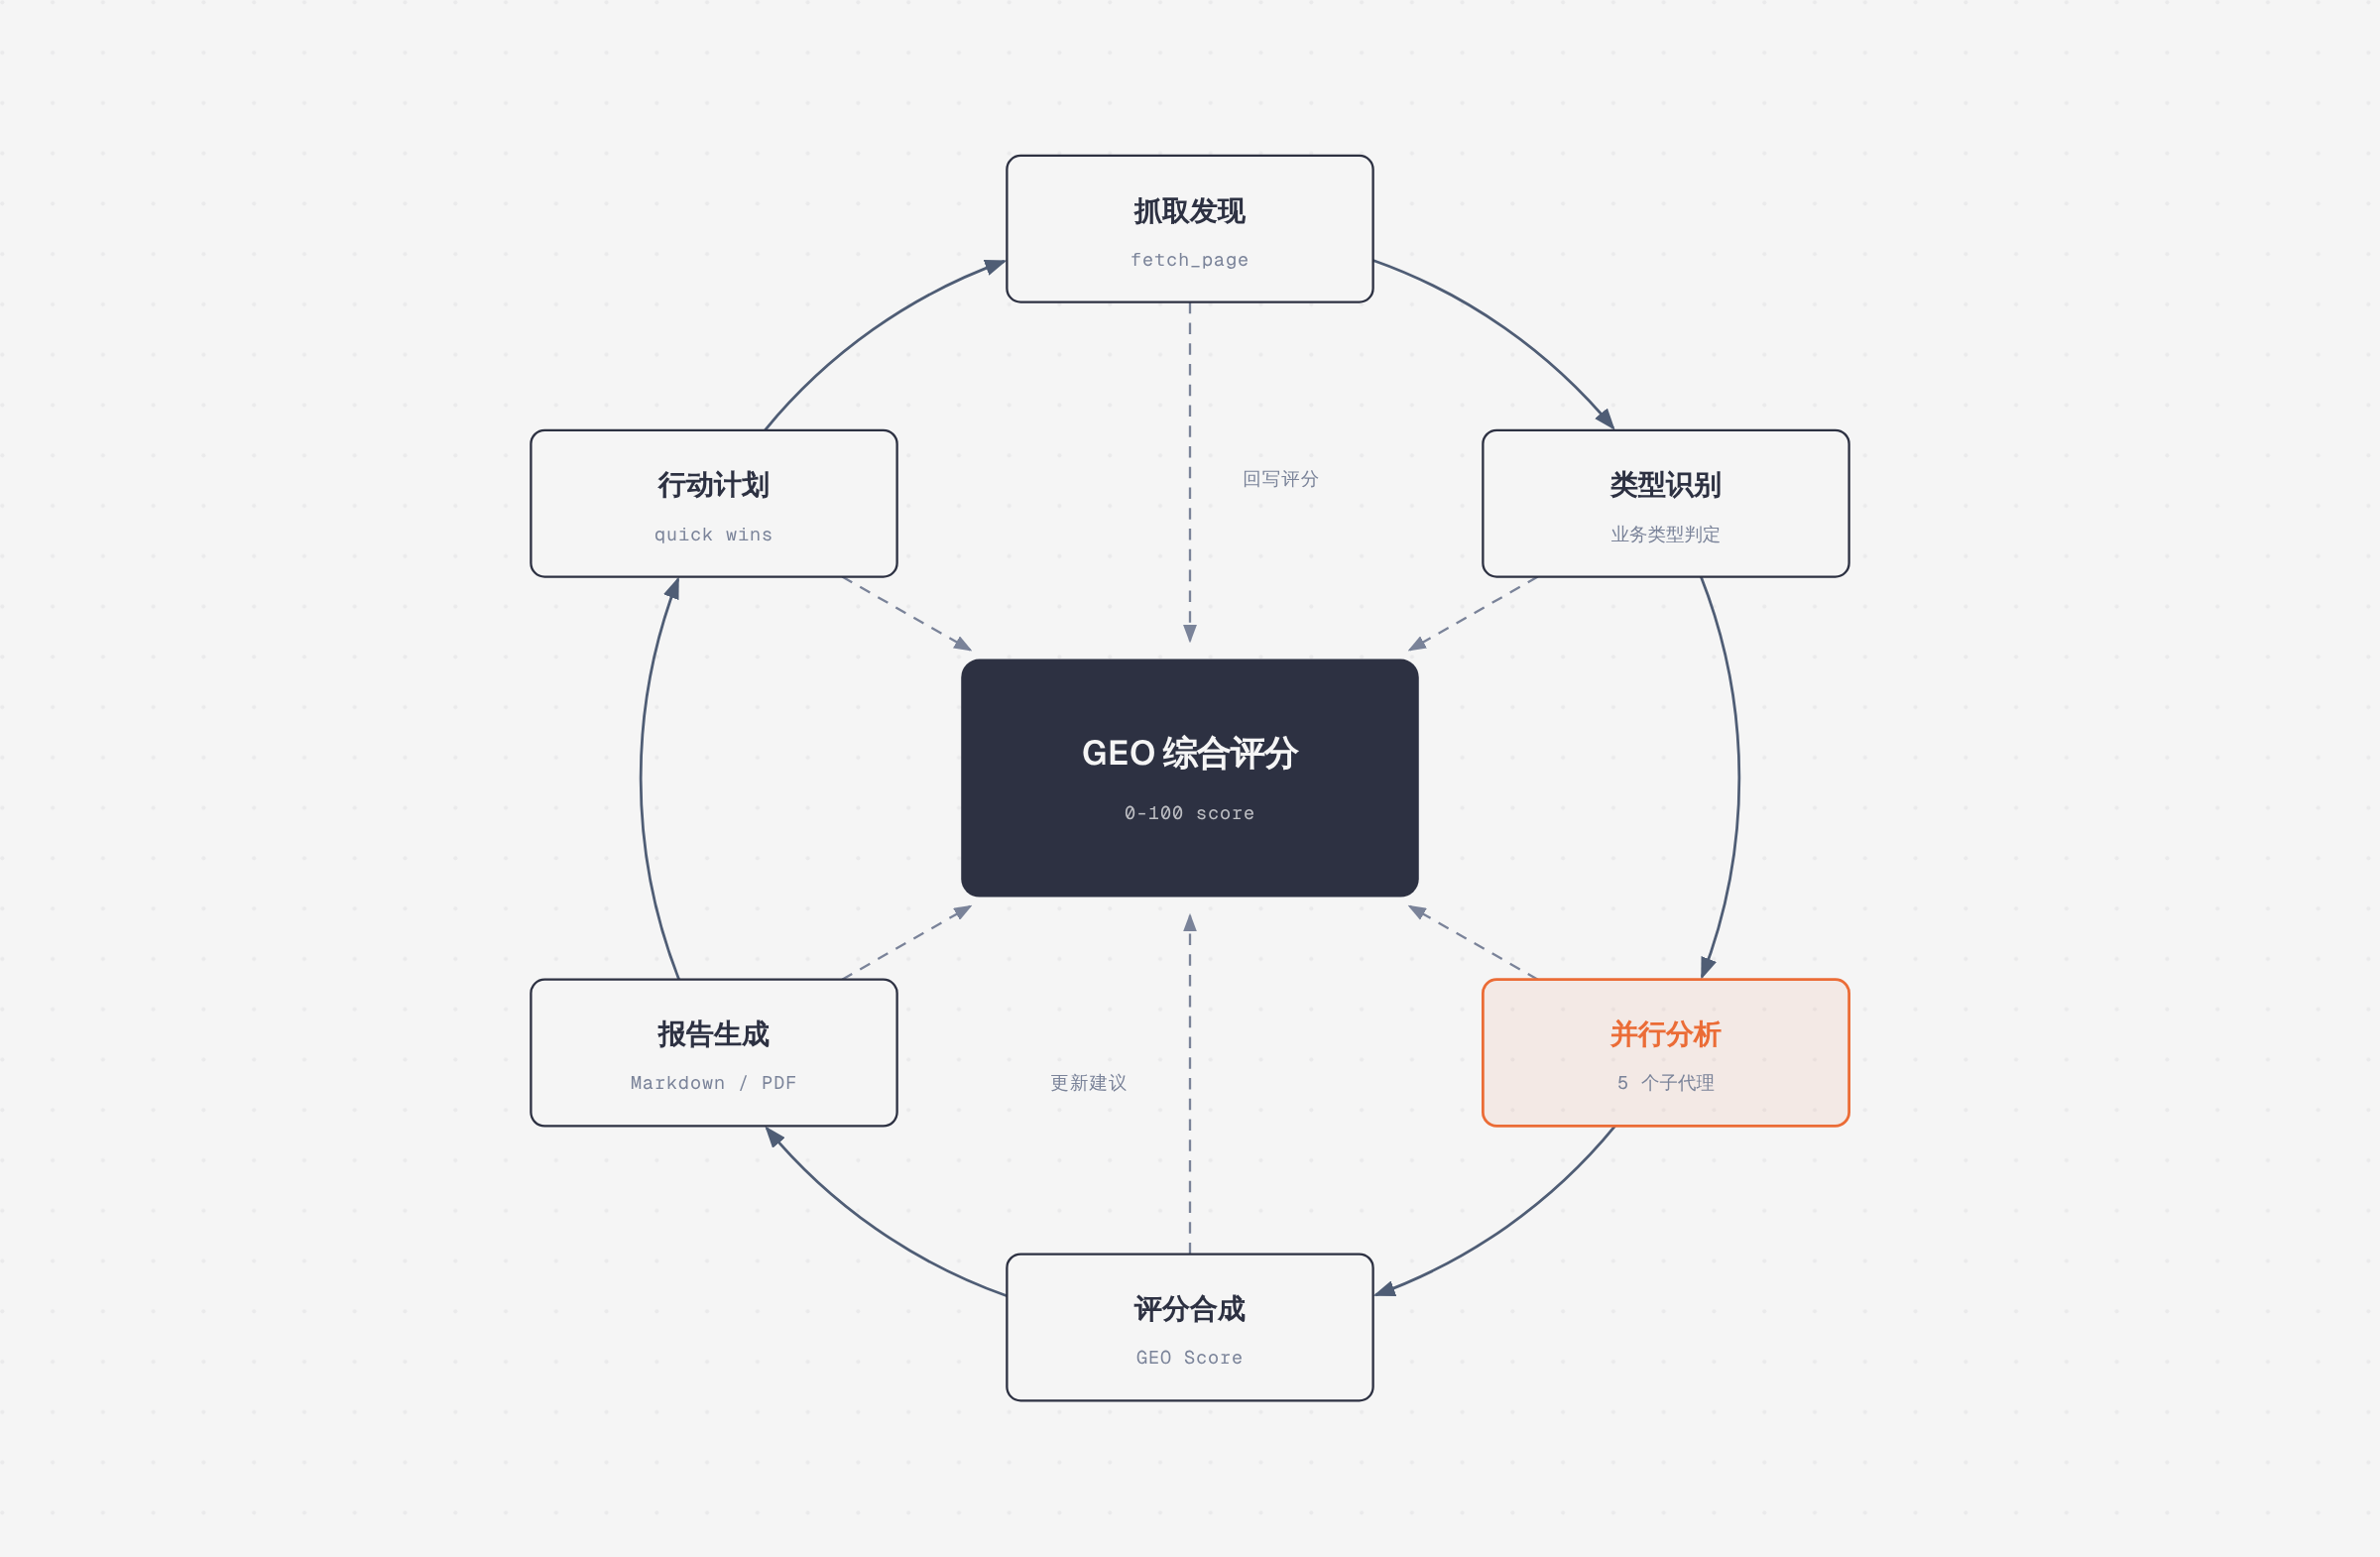
一次完整的 /geo audit 走六个站点,其中并行分析是枢纽。
- 抓取发现(fetch_page):拉取首页 HTML,同时解析 sitemap.xml 建立待分析 URL 集合。这一步决定了后续样本的代表性——只抓首页的审计几乎必然高估站点质量。
- 类型识别(业务类型判定):从页面内容、Schema、导航结构推断站点是本地商户、SaaS、电商还是内容站。类型判定直接决定了后续加载哪套 JSON-LD 模板和哪组评分权重,是整个流程的分叉点。
- 并行分析(5 个子代理):AI 可见性(引用度、爬虫、llms.txt、品牌提及)、平台适配、技术 SEO(Core Web Vitals、SSR、安全、移动端)、内容质量(E-E-A-T、可读性、时效性)、Schema 标记(检测、校验、生成)同时开跑。并行在这里不是性能优化,而是上下文隔离——五个维度各用各的上下文窗口,避免长审计里互相污染。
- 评分合成(GEO Score):把分项得分按权重聚合成 0–100 的综合分。权重为:AI 引用度与可见性 25%、品牌权威信号 20%、内容质量与 E-E-A-T 20%、技术基础 15%、结构化数据 10%、平台优化 10%。注意引用度与品牌合计 45%,这正是“GEO-first”在数值上的体现。
- 报告生成(Markdown / PDF):输出结构化报告,PDF 分支额外渲染图表。
- 行动计划(quick wins):按投入产出比排序,先给能当天改完的项(补 llms.txt、放开 GPTBot、加 Organization schema),再给需要周期的项(内容重构、品牌提及建设)。 回到图中的枢纽:GEO 综合评分并非只在末尾出现,它同时是反馈节点——评分结果会回写到各维度,用于校验分项之间是否自相矛盾(例如技术分很高但引用分为零,通常意味着内容层面存在结构性问题而非可访问性问题),并据此更新行动建议的优先级。这条“写回”路径让流程从线性流水线变成可自洽的闭环。
五、核心模块解析
| 模块 | 职责 |
|---|---|
scripts/fetch_page.py | 页面抓取与 HTML 解析,为所有下游分析提供统一的内容树与元数据 |
scripts/citability_scorer.py | 引用就绪度评分引擎,按段落切分、长度区间判定、自包含性与事实密度打分 |
scripts/brand_scanner.py | 跨平台品牌提及检测,聚合 YouTube / Reddit / Wikipedia / LinkedIn 等站点的实体出现 |
scripts/llmstxt_generator.py | llms.txt 的校验与生成,输出符合新兴标准的站点结构说明文件 |
scripts/crm_dashboard.py + scripts/webapp/ | 线索看板与轻量 Web 界面,把 ~/.geo-prospects/ 里的数据可视化 |
scripts/generate_pdf_report.py | 基于 ReportLab 的 PDF 渲染,图表、仪表盘与配色表格 |
agents/geo-*.md | 5 个并行子代理的提示词与执行契约,定义各自输入、检查项与输出格式 |
skills/geo-*/ | 13 个专项子技能的知识库:评分标准、检查清单、报告片段模板 |
schema/*.json | JSON-LD 模板库,按业务类型分发 |
需要说明的是,仓库文件树与 README 的模块清单存在轻微漂移:README 描述的是 generate_pdf_report.py,而实际树中还能看到 crm_dashboard.py 与 webapp/ 目录。这在快速迭代的项目里很常见,但对使用者意味着以仓库实际文件为准,尤其是涉及数据目录与端口的部分。子技能目录数量同样如此(README 写 13 个,树中可见 geo-update 等额外目录)——多出来的 geo-update 看起来是负责规则库自更新的,说明评分标准本身也在被当作可迭代资产维护。
六、特色能力
六维加权评分是这套工具最像“产品”的部分。 大多数免费 SEO 检查器给的是一个模糊的清单勾选,而这里给出的是带权重的合成分数,且权重公开可审计。这让审计结果可以被横向比较——同一客户隔月两次审计的分数变化,能拆解到具体维度,而不是只看总分涨跌。
平台差异化建议则建立在一条很尖锐的数据上:只有 11% 的域名能在 ChatGPT 和 Google AI Overviews 对同一查询时同时被引用。这意味着“优化 AI 搜索”不是一件事,而是几件相关性不高的事。Perplexity 偏好带明确来源的短结论,Google AIO 更依赖既有搜索排名与结构化数据,ChatGPT 对实体识别与品牌提及更敏感。工具为每个平台单独出建议,而不是给一份通用清单。
报告能力被当作一等公民对待。 Markdown 报告面向内部迭代,PDF 报告面向客户交付——含分数仪表盘、柱状图、平台就绪度可视化、配色表格与优先级行动表。加上 white-label/ 的品牌配置,这条链路明显是为代理机构设计的:审计完直接能发出去,不需要再手工排版。
**prospect**** / **proposal** / **compare** 三件套把工具从“审计器”推向了“业务系统”。** 数据落在 ~/.geo-prospects/,包含线索管道 JSON、生成的提案文档与月度增量报告。这一步的野心很清楚:不只帮你发现问题,还帮你把问题卖出去。
七、工具链或生态
依赖面刻意保持得很窄:Claude Code CLI、Git、Python 3.10+(Debian/Ubuntu 还需 python3-venv)。可选依赖只有两个——uv 用于加速依赖安装,Playwright 用于页面截图。PDF 生成走 ReportLab,是纯 Python 方案,不依赖无头浏览器,这让安装体积和失败率都可控。
生态位上有两个值得说的点。其一是标准跟随:llms.txt 目前仍是社区提案而非正式标准,项目选择第一时间支持并在报告中单列一项,属于典型的“押注新兴标准以获取先发解释权”。其二是社区绑定:README 明确把工具与 AI Workshop 社区分开——工具免费,变现方法付费(GEO 代理报价普遍在每月 2K–12K 区间)。这是一个开源引流加社群变现的经典结构,对使用者而言意味着文档质量有商业动机支撑,但也意味着部分深度内容被留在了付费墙后。
八、部署与安全
安装是一行命令的设计:
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/zubair-trabzada/geo-seo-claude/main/install.sh | bash

# Windows 需在 Git Bash 中执行(非 PowerShell / CMD)
curl -fsSL https://raw.githubusercontent.com/zubair-trabzada/geo-seo-claude/main/install-win.sh | bash

# 装好后在 Claude Code 里使用
/geo audit https://example.com
/geo citability https://example.com
/geo report-pdf
安全与卫生方面有三条值得肯定的工程决策。依赖隔离:所有 Python 包装进 ~/.claude/skills/geo/.venv/,系统 Python 完全不被触碰,且技能文件直接引用该 venv 的绝对路径,因此无论 PATH 里的 python3 指向哪个版本都不影响运行——这消除了虚拟环境类工具最常见的“装完跑不起来”故障。卸载对称:uninstall.sh 清理技能与代理文件,但有意保留 ~/.geo-prospects/,因为那里是用户的客户数据;需要手动删除。把“代码”与“数据”的生命周期分开,是对的做法。合规前置:robots.txt 校验被提升为架构中的横切关卡(即前文的 GUARD 节点),抓取前先确认准入,同时把“该不该放行 AI 爬虫”反过来作为给站长的建议输出。
需要提醒的是 curl | bash 这种安装方式本身的信任成本:脚本会写入 ~/.claude/ 目录,建议先下载审阅再执行,尤其是在企业环境中。
九、适用场景
GEO 代理机构是首要受众。批量审计 + 白标 PDF + 提案生成 + 月度对比,这条链路的完整度足以支撑一个小型交付团队的工作流,把单客户的审计工时从一天压到一小时量级。
营销团队用它做基线监控:季度跑一次 /geo audit,把综合分与六个分项存档,观察 AI 引用度的变化趋势。compare 命令就是为此设计的。
内容创作者的用法更聚焦:只跑 /geo citability,把长文按 134–167 词的段落切分建议重写,提升被 AI 摘要取用的概率。这是投入产出比最高的一条路径,不需要碰技术栈。
本地商户、SaaS 与电商则分别对应 LocalBusiness、SoftwareApplication、Product 三套 Schema 模板与实体识别优化——对本地商家而言,“被 AI 助手推荐”正在变成和“进地图包”同等重要的曝光位。
十、总结评价
真正的价值在于把 GEO 从概念变成了可并行的工程流程。 AI 搜索优化目前充斥着观点与玄学,这个项目做的最有价值的事是:定义六个可测量的维度、给出公开权重、把每个维度交给一个独立的子代理去跑、最后合成一个能跨时间比较的分数。评分是否精准可以争论,但“有争议的量化”远胜于“无争议的模糊”。
架构上的聪明之处是寄生而非重建。 它没有自己去实现爬虫调度、LLM 调用、报告渲染的全部基础设施,而是把这些交给 Claude Code 与几个成熟的 Python 库,自己只负责方法论、路由与交付物。这让整个项目保持在一个小团队甚至个人可维护的体量,同时获得了 Agent 并行执行的天然能力。
局限同样明显。 其一,所有判断最终都落在模型输出上,citability 评分、E-E-A-T 评估、品牌提及的语义判定都存在波动,同一站点两次审计的分数可能有差异,不适合作为合同里的硬性 KPI 依据。其二,它测的是代理指标:段落长度、schema 完整性、robots 放行,这些都是“可能被引用”的相关因素,而不是真实引用数据。真正该做的是把审计结论与 Search Console、各平台的实际引荐流量做对照复核。其三,形态决定了它的天花板——绑定 Claude Code、绑定单机 venv,要改成团队共享服务需要额外工程。其四,README 与仓库结构的轻微漂移、以及部分深度内容外链到付费社区,对纯自学者不算友好。
适合谁:正在接 GEO 业务、需要快速产出交付物的代理机构与自由职业者;想系统性建立 AI 可见性基线的营销团队;以及把它当方法论教材读、准备自己搭一套的工程师。不适合谁:期待开箱即用的 SaaS 看板的人,以及需要把评分写进 SLA 的企业采购。