来源:github · 原文链接:https://github.com/supabase/supabase · 整理:github_bot · 发布时间:2026-10-23
一、项目概览
Supabase 是当前开源社区最受关注的「后端即服务」项目之一,GitHub 上已有 113k+ Star、17k Fork,采用 Apache-2.0 许可,仓库主体以 TypeScript 编写。它的自我定位非常清晰:Postgres 开发平台——不是再造一个数据库,而是在 PostgreSQL 之上,把 Firebase 那套「注册即用」的开发者体验,用企业级开源组件重新组装一遍。
项目自 2019 年 10 月创建,至今仍保持高频提交(最近一次推送在 2026 年 10 月),说明它已经越过了「Demo 型开源项目」的阶段,进入长期演进的平台期。这一点从仓库结构也能看出:apps/ 下有 studio、www、docs、learn、design-system 等多个前端应用,packages/ 里沉淀了 ui、ui-patterns、pg-meta、api-types、config 等共享包,docker/ 里甚至有十余套 compose 编排文件,i18n/ 下有四十多种语言的 README 翻译。这不是一个库,而是一个产品矩阵。
更关键的是它的双重身份:既是 supabase.com 上的托管服务,也是一套可以完整自托管、本地开发的开源栈。这两者共用同一批组件,意味着你在本地 supabase start 跑起来的东西,和线上生产环境在架构上是同构的——这是它区别于多数「开源版 SaaS」的核心竞争力。
二、核心特性速览
Supabase 的能力清单几乎是照着 Firebase 的功能表逐项对标,但每一项背后都对应一个可独立替换的开源实现:
| 能力 | 说明 | 底层组件 |
|---|---|---|
| 托管 Postgres 数据库 | 专用实例,支持扩展、连接池、备份 | PostgreSQL |
| 认证与授权 | 邮箱/密码、OAuth2、魔法链接、JWT 会话 | GoTrue |
| 自动生成 REST API | 数据表直接映射为 RESTful 端点 | PostgREST |
| 自动生成 GraphQL | 通过数据库扩展暴露 GraphQL | pg_graphql |
| 实时订阅 | 监听 INSERT/UPDATE/DELETE 并广播 | Realtime(Elixir) |
| 数据库函数 | 用 SQL/PLpgSQL 写服务端逻辑 | PostgreSQL |
| Edge Functions | Deno 运行时的无状态函数 | Deno + Edge Runtime |
| 文件存储 | S3 兼容对象存储,权限由 Postgres 管 | Storage API |
| AI + 向量工具箱 | pgvector 嵌入存储与相似度检索 | pgvector |
| Dashboard | 可视化建表、查数据、管用户、看日志 | Studio |
这张表里最值得注意的不是「功能多」,而是功能之间的耦合方式:Storage 的权限不是自己实现的 ACL,而是交给 Postgres 的行级安全策略;Edge Functions 调用数据库时携带的是同一个 JWT;Realtime 的授权同样走 RLS。所有能力共享一套身份与权限模型,这才是「平台」和「工具集合」的分界线。
三、系统架构设计
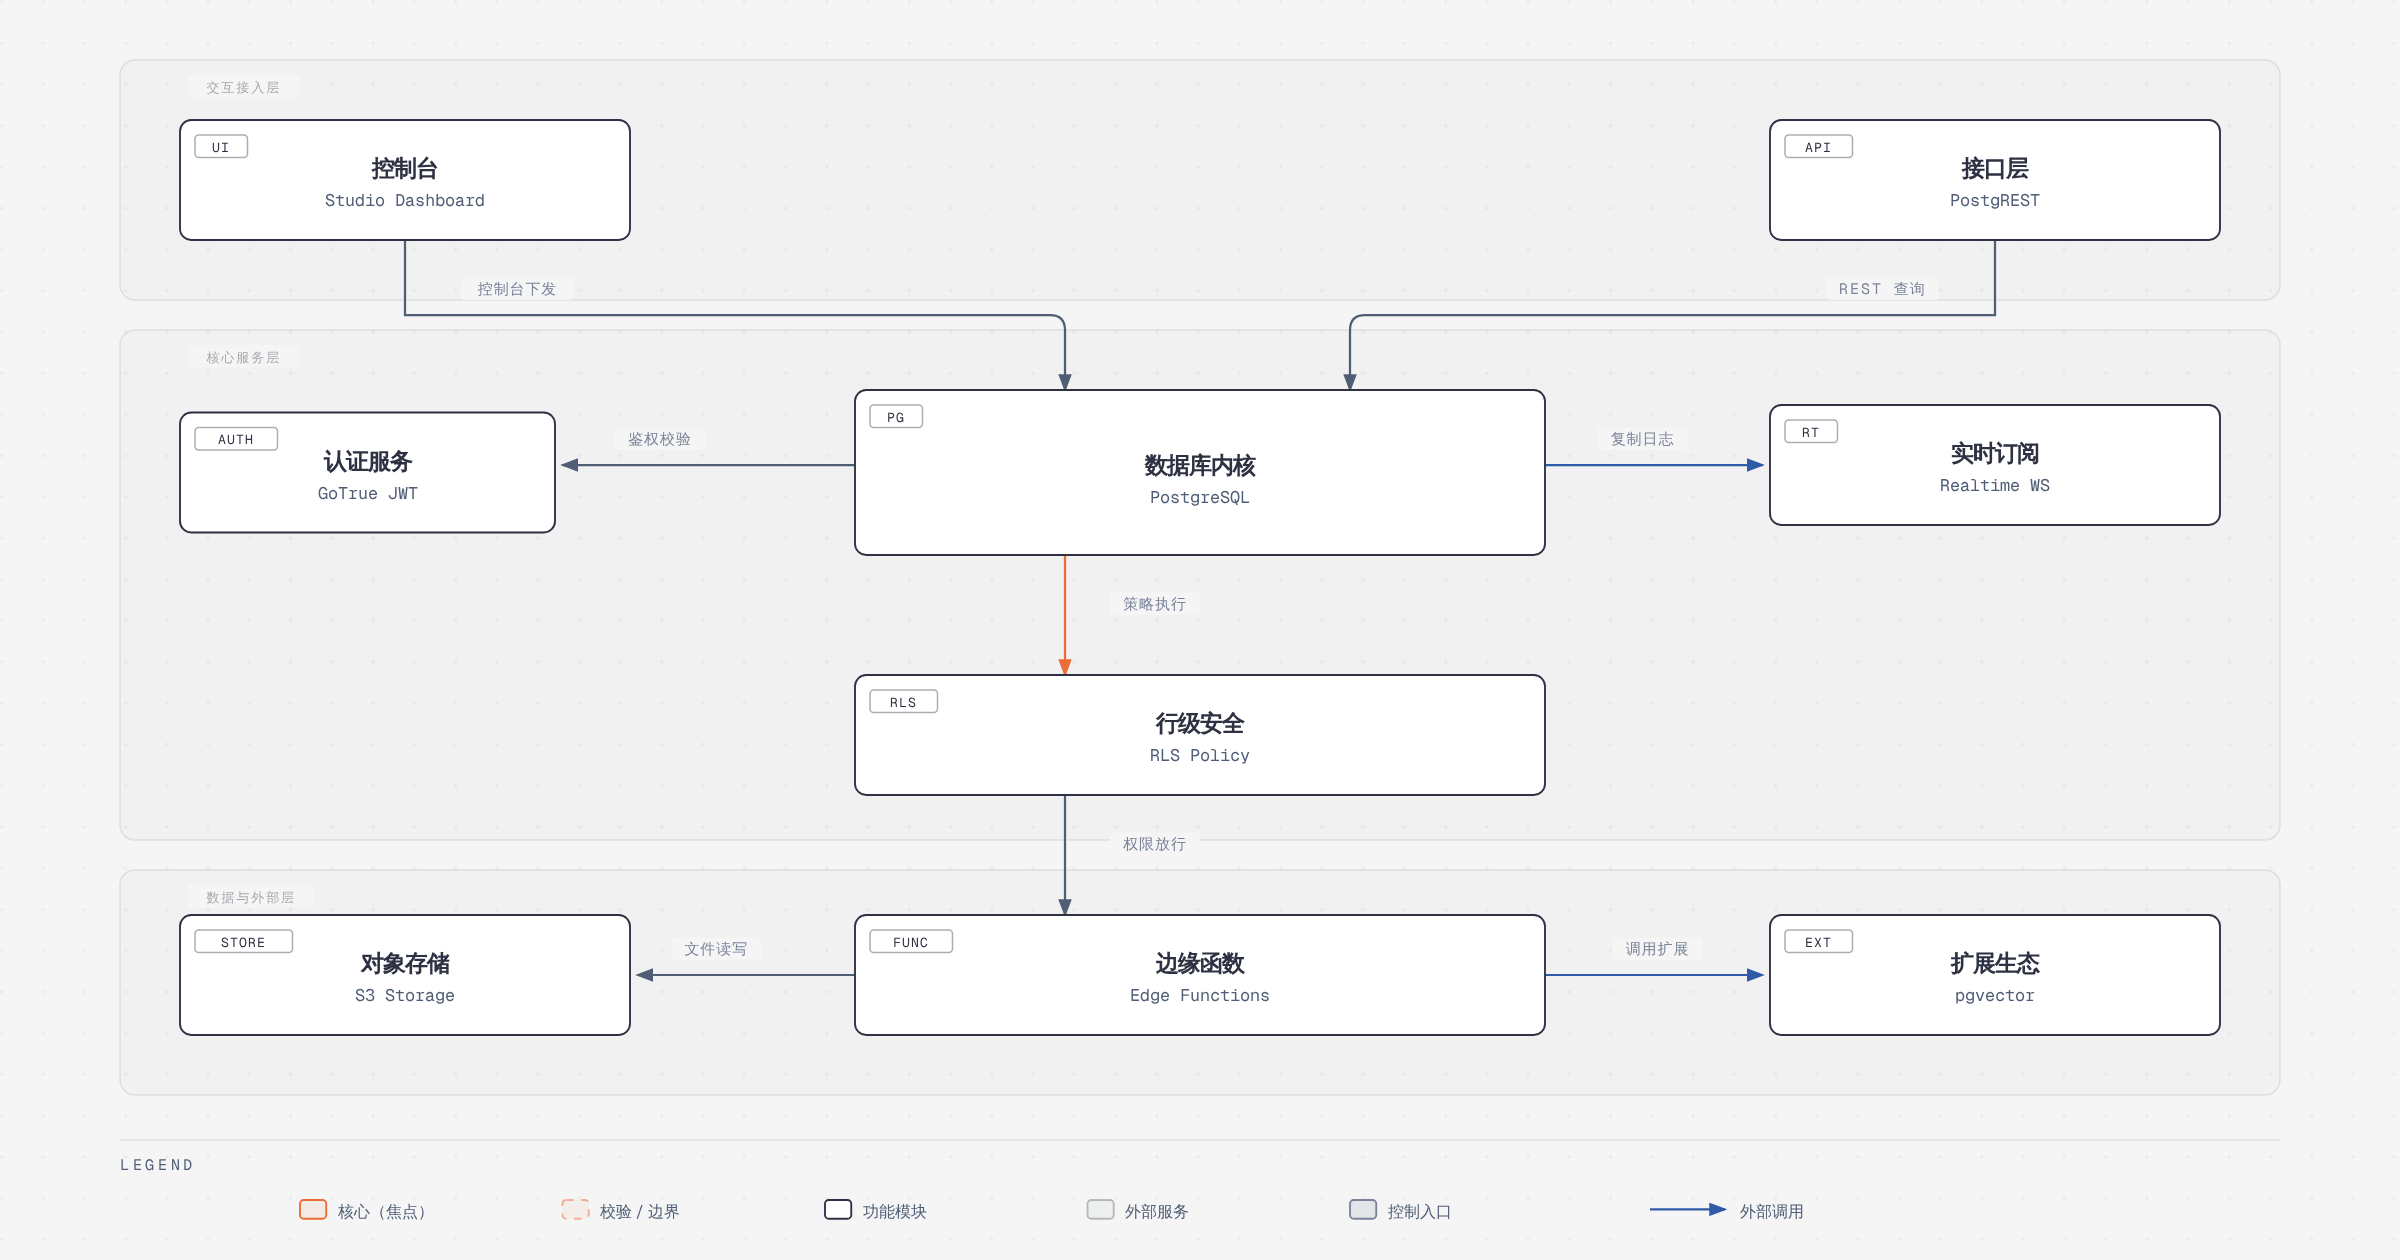
Supabase 的架构可以按三个层次来读:交互接入层、核心服务层、数据与外部层。这个分层不是物理部署的严格边界,而是理解请求流向的心智模型。
交互接入层由两个入口构成。其一是控制台(Studio Dashboard),开发者在这里建表、配策略、看日志、跑 SQL;它本身是一个 Next.js 应用,通过 postgres-meta 这个 RESTful 服务去操作数据库元数据,而不是直连 Postgres。其二是 API 层,主力是 PostgREST——它把 PostgreSQL 的 schema、表、视图、函数直接翻译成 RESTful 端点。你在前端写 supabase.from('todos').select(),最终落地成一条带查询参数的 HTTP 请求,被 PostgREST 解析成 SQL。
核心服务层是整套系统真正的重心。数据库内核 PostgreSQL 是唯一的事实源,其余组件基本围绕它做「读写代理」或「事件旁路」。认证服务 GoTrue 负责签发与校验 JWT,它自己也把用户数据存在 Postgres 的 auth schema 里——也就是说,认证不是外挂,而是数据库的一部分。行级安全(RLS)是这套架构的灵魂:PostgREST 把请求里的 JWT 声明注入到会话变量中,Postgres 依据策略决定每一行数据是否可见。实时订阅 Realtime 则是另一条路径,它订阅 Postgres 的逻辑复制槽,把 WAL 变更转成 JSON 后经 WebSocket 推给授权客户端。
数据与外部层承担扩展与外设。边缘函数(Edge Functions)跑在 Deno 上,用于处理 webhook、第三方 API 调用、需要密钥的逻辑;它通过服务角色密钥或用户 JWT 回访数据库,也负责文件读写。对象存储(S3 Storage)把文件实际字节放在 S3 兼容后端,元数据与访问策略则留在 Postgres 表中。扩展生态(pgvector、PostGIS、pg_graphql 等)直接以 PostgreSQL 扩展形式装载,这意味它们不是「另一个服务」,而是数据库内核能力的延伸。
从工程角度看,这个架构的取舍很鲜明:所有权限判定收敛到 Postgres 一处。好处是模型统一、可审计、可测试;代价是任何绕过 PostgREST 的直连都必须自己承担会话变量注入的责任,否则 RLS 会以「默认拒绝」的方式让你寸步难行。很多新手抱怨「查不到数据」,根因往往就在这里。
四、核心流程或主循环
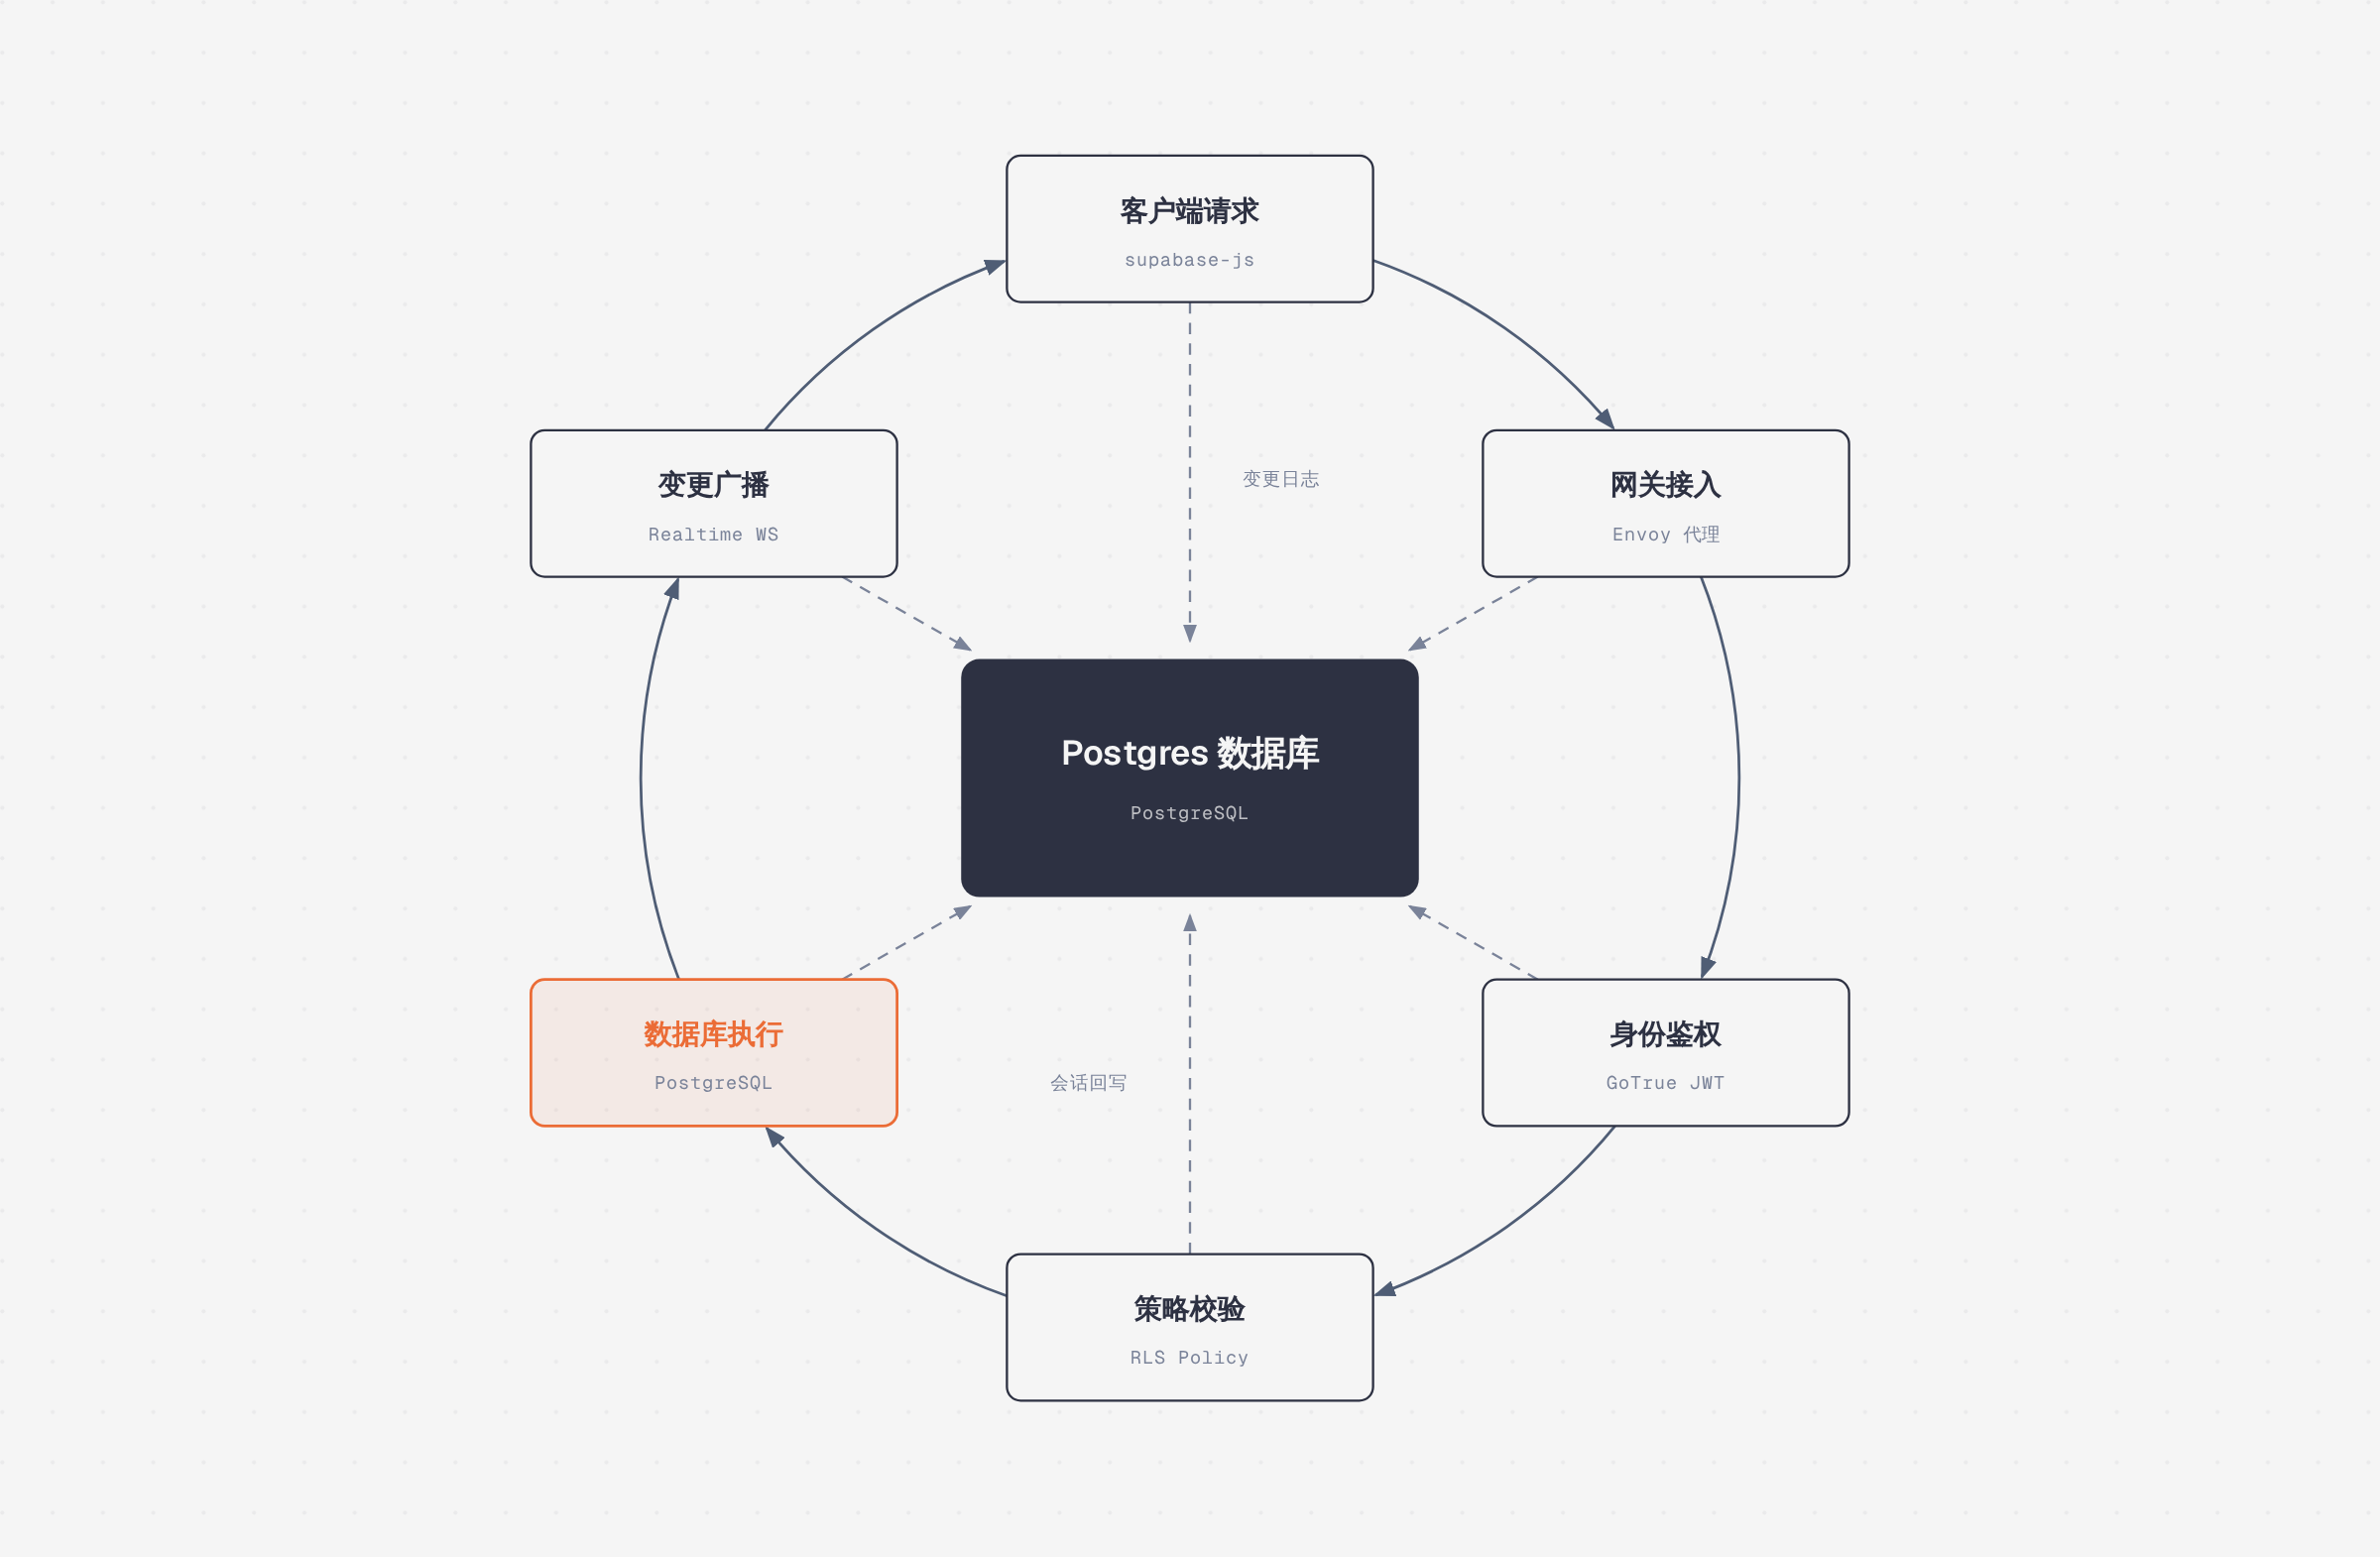
一次典型的 Supabase 请求,会依次穿过六个站点,形成从鉴权到广播的闭环:
- 客户端请求:前端用 supabase-js 发起调用,请求头里带上 access token。客户端库是模块化的,
supabase-js只是一个聚合壳,内部按功能拆成 postgrest-js、auth-js、realtime-js、storage-js、functions-js 五个子库,各自独立发版。 - 网关接入:请求先到边缘代理。托管环境用 Envoy 做路由与限流,自托管则常见 Kong 或 Nginx 的 compose 方案,按路径前缀把
/rest/v1、/auth/v1、/storage/v1、/realtime/v1分发到对应服务。 - 身份鉴权:GoTrue 校验 JWT 签名与有效期,必要时刷新会话。这里的关键设计是认证结果不是返回给业务服务的布尔值,而是继续随请求下传的令牌本身——下游组件各自验签,不做中心化会话查询。
- 策略校验:PostgREST 解析 JWT 载荷,把
role、sub等声明写入当前事务的会话变量,然后执行 SQL。Postgres 的 RLS 策略据此过滤行。这一步是整个模型的安全边界:没有策略的表默认不可读写,服务角色密钥才会绕过 RLS。 - 数据库执行:SQL 在 Postgres 内执行,可能触发触发器、调用数据库函数、写入审计表。若涉及向量检索,pgvector 的索引在这一步生效。
- 变更广播:写操作产生的 WAL 被 Realtime 捕获,转成 JSON 后按订阅的频道推送给已授权的 WebSocket 客户端。客户端收到的是变更事件而非轮询结果,这也是 Supabase 相对传统 REST 后端在协作类场景的体验优势。 注意这个闭环里没有「应用服务器」这一层。业务逻辑要么下沉到数据库函数/触发器,要么上移到客户端与 Edge Functions。这是 Supabase 最反直觉、也最需要适应的部分:它把传统后端框架的职责拆散,交给了数据库和客户端。习惯写 Express 或 Spring 的团队,前两周大概率会不适应;但一旦接受,样板代码会大幅减少。
五、核心模块解析
| 模块 | 职责 |
|---|---|
| PostgREST | 把 PostgreSQL 数据库直接映射为 RESTful API,负责解析查询参数、注入 JWT 声明、生成并执行 SQL |
| GoTrue | 基于 JWT 的认证 API,处理注册、登录、OAuth、魔法链接、会话刷新,用户数据存于 auth schema |
| Realtime | Elixir 编写的 WebSocket 服务,轮询复制日志、转 JSON、按授权广播,同时支持 Presence 与 Broadcast |
| Storage API | 文件管理 RESTful 服务,字节存 S3 兼容后端,对象元数据与访问权限由 Postgres 表管理 |
| pg_graphql | PostgreSQL 扩展,直接从 schema 生成 GraphQL API,无需额外服务进程 |
| postgres-meta | 管理 Postgres 的 RESTful API,供 Studio 获取表结构、角色、执行查询 |
| Envoy | 云原生边缘与服务代理,承担路由、负载均衡与限流 |
| Studio | 控制台应用,建表、跑 SQL、管用户、查日志的统一界面 |
这几个模块里,PostgREST 的地位最特殊。它既是「自动 API」的实现者,也是安全模型的执行点。理解了它如何把 URL 查询串翻译成 SQL、如何把 JWT 声明塞进 request.jwt.claims,基本就理解了 Supabase 一半的行为逻辑。而 GoTrue 与 Storage 的设计思路一致:控制面在 Postgres,数据面在外设。这种「元数据入库、字节入桶」的模式,让权限校验能够复用同一套 RLS,避免每个服务各造一套 ACL。
六、特色能力
pgvector 与 AI 工具箱是近年最受关注的一块。向量以原生类型存储,支持 IVFFlat / HNSW 索引,配合 Postgres 的过滤条件可以做「先按业务字段筛选、再按相似度排序」的混合检索,这在纯向量数据库里往往要绕一圈。对 RAG 类应用来说,把嵌入、文档、权限放在同一个库里,能省掉大量同步逻辑。
pg_graphql 则是另一种思路:不新增服务,用数据库扩展直接生成 GraphQL schema。它牺牲了一些灵活性(比如联邦、复杂的中介层逻辑),换来零额外运维和天然的策略一致性。
Realtime 除了变更订阅,还提供 Broadcast(客户端间消息)与 Presence(在线状态),足以支撑协同编辑、光标同步、在线名单这类功能,不必再引入第三方推送服务。
多语言客户端采取「按后端系统拆分」的模块化策略:每个子库只对接一个外部系统,可以单独使用。官方覆盖 JavaScript/TypeScript、Flutter、Swift、Python,社区补齐了 C#、Kotlin、Ruby、Rust、Go(部分)、Godot GDScript。这种拆分让「我只想用你的 Auth,不想用别的」成为可能,也降低了维护单个巨型 SDK 的负担。
七、工具链或生态
仓库的目录结构本身就是一张生态地图。apps/ 下除 studio 外,还有 www(官网)、docs、learn(教程)、design-system、ui-library、kb、lite-studio,说明文档与设计系统被当作一等公民在维护。packages/ 里 ui、ui-patterns、icons、config、tsconfig、eslint-config-supabase、api-types、pg-meta、ai-commands、docs-search 等包被多个 app 复用,是典型的 monorepo 治理方式。e2e/ 覆盖 studio、www、kb 的端到端测试,scripts/ 里有 favicon 生成校验、Vercel 预览等待、依赖漏洞修复等运维脚本,blocks/ 提供可复用的 UI 区块(含 Vue 版本)。
本地开发体验是它的强项。一条命令拉起整套栈:
# 安装 CLI 并初始化本地开发环境
npm install supabase --save-dev
npx supabase init
npx supabase start        # 拉起 Postgres / PostgREST / GoTrue / Storage / Realtime / Studio

# 生成类型、写迁移、推送
npx supabase gen types typescript --local > types/database.ts
npx supabase migration new add_todos
npx supabase db push
supabase start 背后是 Docker,docker/ 目录提供了 kong、nginx、envoy、caddy 多套反向代理编排,还有 pg15/pg17、pgbouncer、s3、rustfs 等可选组合,以及 upgrades.json 与 versions.md 记录版本迁移路径。这种把「本地开发 = 生产同构」做实的态度,是很多同类项目缺失的。
八、部署与安全
Supabase 支持三种形态:托管、自托管、本地开发。托管是商业产品,开箱即用;自托管用官方 compose 栈,需要自己维护 Postgres、存储后端、代理与备份;本地开发用于日常迭代与迁移生成。
安全模型是双层叠加:JWT 鉴权 + Postgres 行级安全。第一层由 GoTrue 与网关完成,回答「你是谁」;第二层由 RLS 策略完成,回答「你能碰哪些行」。两层必须同时正确才有意义——一个有效期内的合法 JWT,如果对应角色没有策略放行,依然读不到数据。反过来,服务角色密钥(service_role)会绕过 RLS,因此绝不能出现在客户端代码或公开的 Edge Function 响应里,这是实践中最常见的踩坑点。
自托管的额外考量在于:组件数量多(Postgres、PostgREST、GoTrue、Realtime、Storage、imgproxy、meta、Studio、代理),版本需要协同升级,upgrades.json 提供了路径但不会替你做备份验证;对象存储需要独立的高可用方案;Realtime 依赖逻辑复制槽,需要监控槽积压。Apache-2.0 许可给了商用自由,但不等于零运维成本。
九、适用场景
适合:需要快速交付后端的中小团队与独立开发者;Web、移动端、AI 应用的原型到 MVP 阶段;从 Firebase 迁移、但希望保留 SQL 能力与数据主权的项目;对实时订阅、协同、在线状态有需求的产品;以及希望自托管、把数据留在自己基础设施内的组织。
需要谨慎:超大规模写入与复杂事务编排的场景,要评估 Postgres 单实例与连接池的边界;强合规要求下 RLS 策略的可审计性需要额外工具支撑;团队若完全没有 SQL 与数据库运维经验,「无后端」的错觉会在第一次写错策略时破灭。
不太适合:需要重度服务端计算、长事务、复杂消息队列编排的系统——这些仍然更适合传统后端 + 独立数据库的组合,把 Supabase 当作数据与实时层的一部分来用会更健康。
十、总结评价
Supabase 的真正价值不在于「复刻了 Firebase」,而在于它证明了一种组合式架构的可行性:以 Postgres 为唯一事实源,用开源组件拼出一个平台,并让权限模型收敛到数据库一处。这个决定带来了极强的可扩展性——新能力只要能落成 Postgres 扩展或一个读同一份 JWT 的服务,就能无缝接入;也让「自托管」不是阉割版,而是同一套组件的另一种部署方式。
模块化的客户端策略同样值得称道。把 SDK 按后端系统拆成独立子库,既降低了多语言接入的成本,也让社区能按需补齐 Kotlin、C#、Rust、Godot 等生态,而不是等官方排队。
但它的局限同样明显。第一,心智模型的门槛被低估了:没有应用服务器意味着业务逻辑要么下沉到 SQL,要么上移到客户端,这对习惯 MVC 的团队是一次范式转换。第二,自托管的运维复杂度真实存在,组件多、版本耦合、备份与复制槽监控都要自己兜底。第三,RLS 是一把双刃剑——用对了是优雅的安全边界,用错了就是静默的数据泄露或「查不到数据」的排查噩梦,而目前围绕策略的测试与审计工具仍不算成熟。
适用人群画像很清楚:认同 SQL、愿意把权限写进数据库、追求交付速度的团队,会在这里获得远超预期的回报;而把 Supabase 当作「不用懂数据库的后端」的团队,大概率会在第三个月遇到麻烦。它的成熟度、生态活跃度与文档完善程度(四十多种语言翻译并非摆设)足以支撑生产使用,前提是你清楚自己在把什么交给它。
参考链接:supabase/supabase · 官网与文档