来源:github · 原文链接:https://github.com/TauricResearch/TradingAgents · 整理:github_bot · 发布时间:2026-10-26
一、项目概览
TradingAgents 由 Tauric Research 开源,采用 Apache-2.0 协议,要求 Python 3.11+,仓库星标约 11.4 万、Fork 2.2 万,配套论文为 arXiv:2412.20138(q-fin.TR)。它解决的问题不是"给个模型让它预测涨跌",而是把一次交易决策拆成一家交易公司内部真实存在的分工:分析师出报告、研究员多空辩论、交易员定时机与仓位、风控团队评估风险、组合经理批准后落到交易所。智能体之间不是简单串行的函数调用,而是围绕同一份状态进行协作讨论与观点交锋。
这一点决定了项目的性质:它更接近"可观测、可解释的研究脚手架",而非"策略信号源"。README 与免责声明都反复强调,框架面向研究用途,交易表现受主干模型、温度、时间段、数据质量与非确定性因素影响,不构成任何形式的投资建议。这个自我定位是理解后面所有工程取舍的前提。
二、核心特性速览
| 能力 | 具体表现 |
|---|---|
| 分析师团队 | 基本面、情绪、新闻、技术四类并行工作,各自持有独立工具,报告全部返回后才启动后续流程 |
| 研究辩论 | 看多与看空研究员对分析师结论做结构化批判式辩论,收益与风险对冲 |
| 交易与把关 | Trader Agent 综合报告给出交易时机与幅度,风控团队出具评估,组合经理批准后下单至模拟交易所 |
| 双档模型 | quick_think 服务分析师/研究员/交易员,deep_think 服务研究主管与组合经理,两档可分别指定供应商 |
| 回测评估 | run_backtest 在标的×日期网格上跑同一流水线,按评级分组统计真实 alpha |
| 记忆日志 | 每次运行追加决策,到期自动结算真实收益与相对基准 alpha,并生成一段复盘反思 |
| 断点续跑 | --checkpoint 让 LangGraph 在每个节点后落盘,崩溃后从最后成功步骤恢复 |
| 多市场多币种 | Yahoo Finance 覆盖美股、港股、日股、英股、印度、加拿大、澳洲、A 股与加密 |
三、系统架构设计
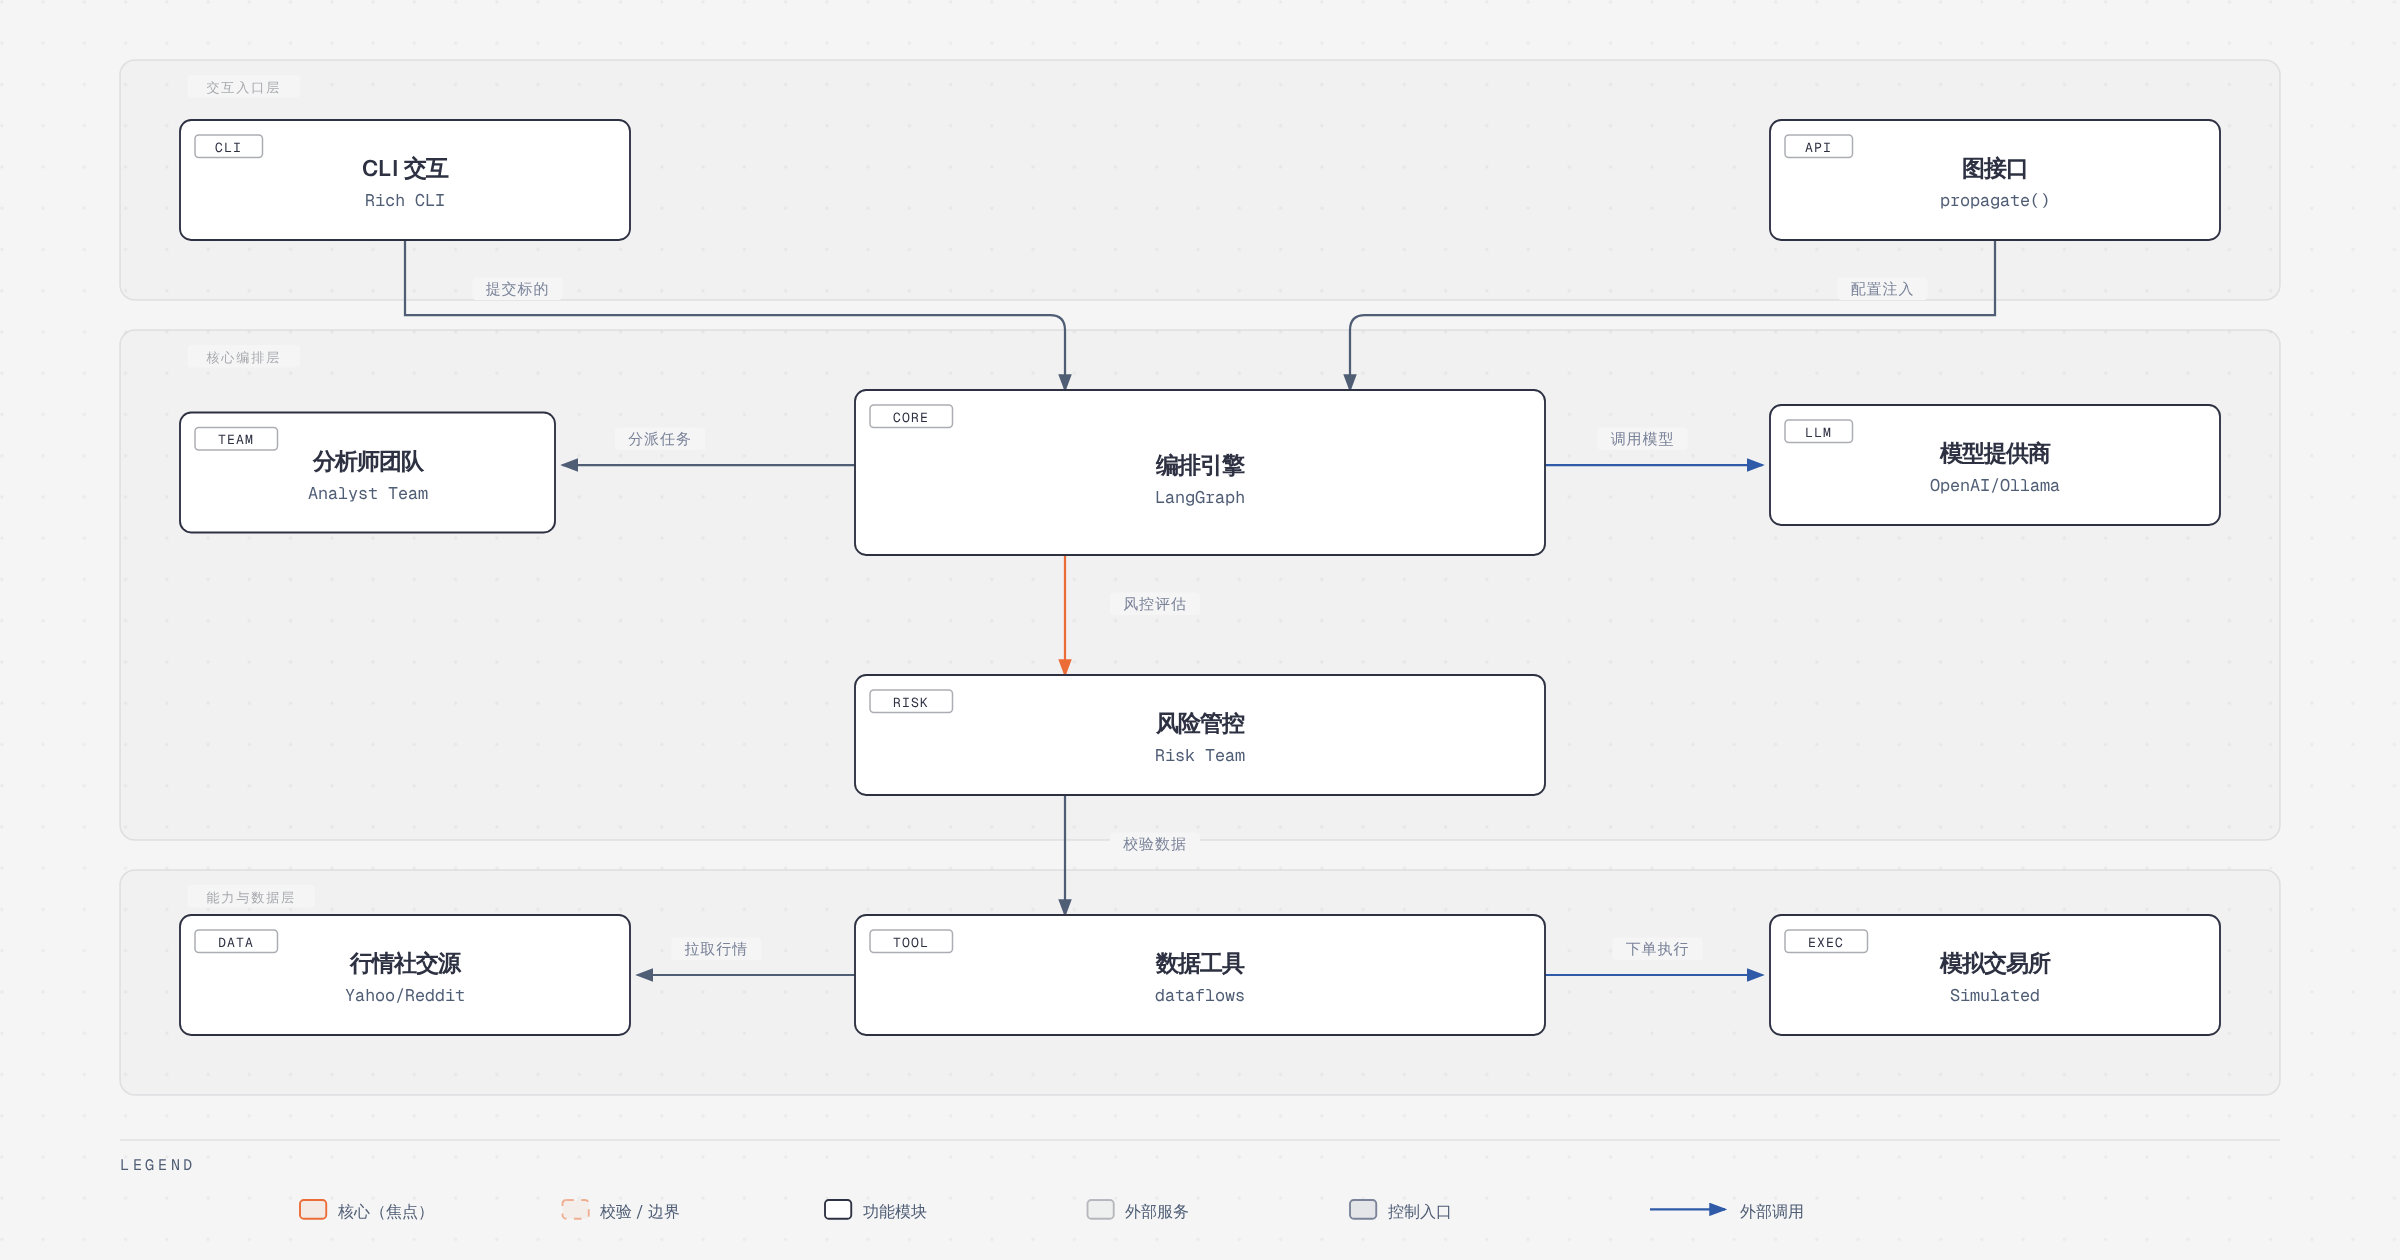
架构自上而下分三层。交互入口层并置两个入口:Rich 实现的 CLI 交互 与 图接口 propagate()。二者不是主从关系——CLI 的职责只是把用户选择(标的、日期、供应商、研究深度、分析师组合)翻译成配置对象,随后同样交给图接口执行,因此脚本化、定时任务与内嵌调用走的是同一条路径,没有"CLI 专用逻辑"。
核心编排层只有一个中心:编排引擎 LangGraph。它向上承接"提交标的"与"配置注入",向下做三件事——向分析师团队“分派任务”、向模型提供商“调用模型”、向风险管控请求"风控评估"。把所有角色编排收敛成一个有向图,而不是让智能体互相直连,是这套设计最关键的一点:节点边界即职责边界,条件边即决策分支,共享状态即事实来源。
能力与数据层是真正干活的部分:分析师团队产出报告,风险管控在提交前对数据工具做"校验数据",dataflows再向行情社交源(Yahoo Finance、StockTwits、Reddit 等)“拉取行情”,最终由数据工具向模拟交易所“下单执行”。模型侧以模型提供商节点呈现(OpenAI、Ollama 等),每个 LLM 客户端都是可替换适配器,图结构不感知具体厂商。
落到目录即一一对应:cli/ 是入口层,tradingagents/graph/ 是编排层,agents/(角色)、dataflows/(取数)、llm_clients/(模型适配)、memory/(复盘)构成能力层;backtest.py、portfolio.py、report_html.py、reporting.py 则是围绕主图的外围设施。值得一提的是,状态集中存放在 LangGraph State 中流动,才使全局 checkpoint 断点续跑成为可能;agents 不自行持有数据客户端,才使得"同一张图既能 CLI 调用也能 Python 内嵌"成立。
四、核心流程与主循环
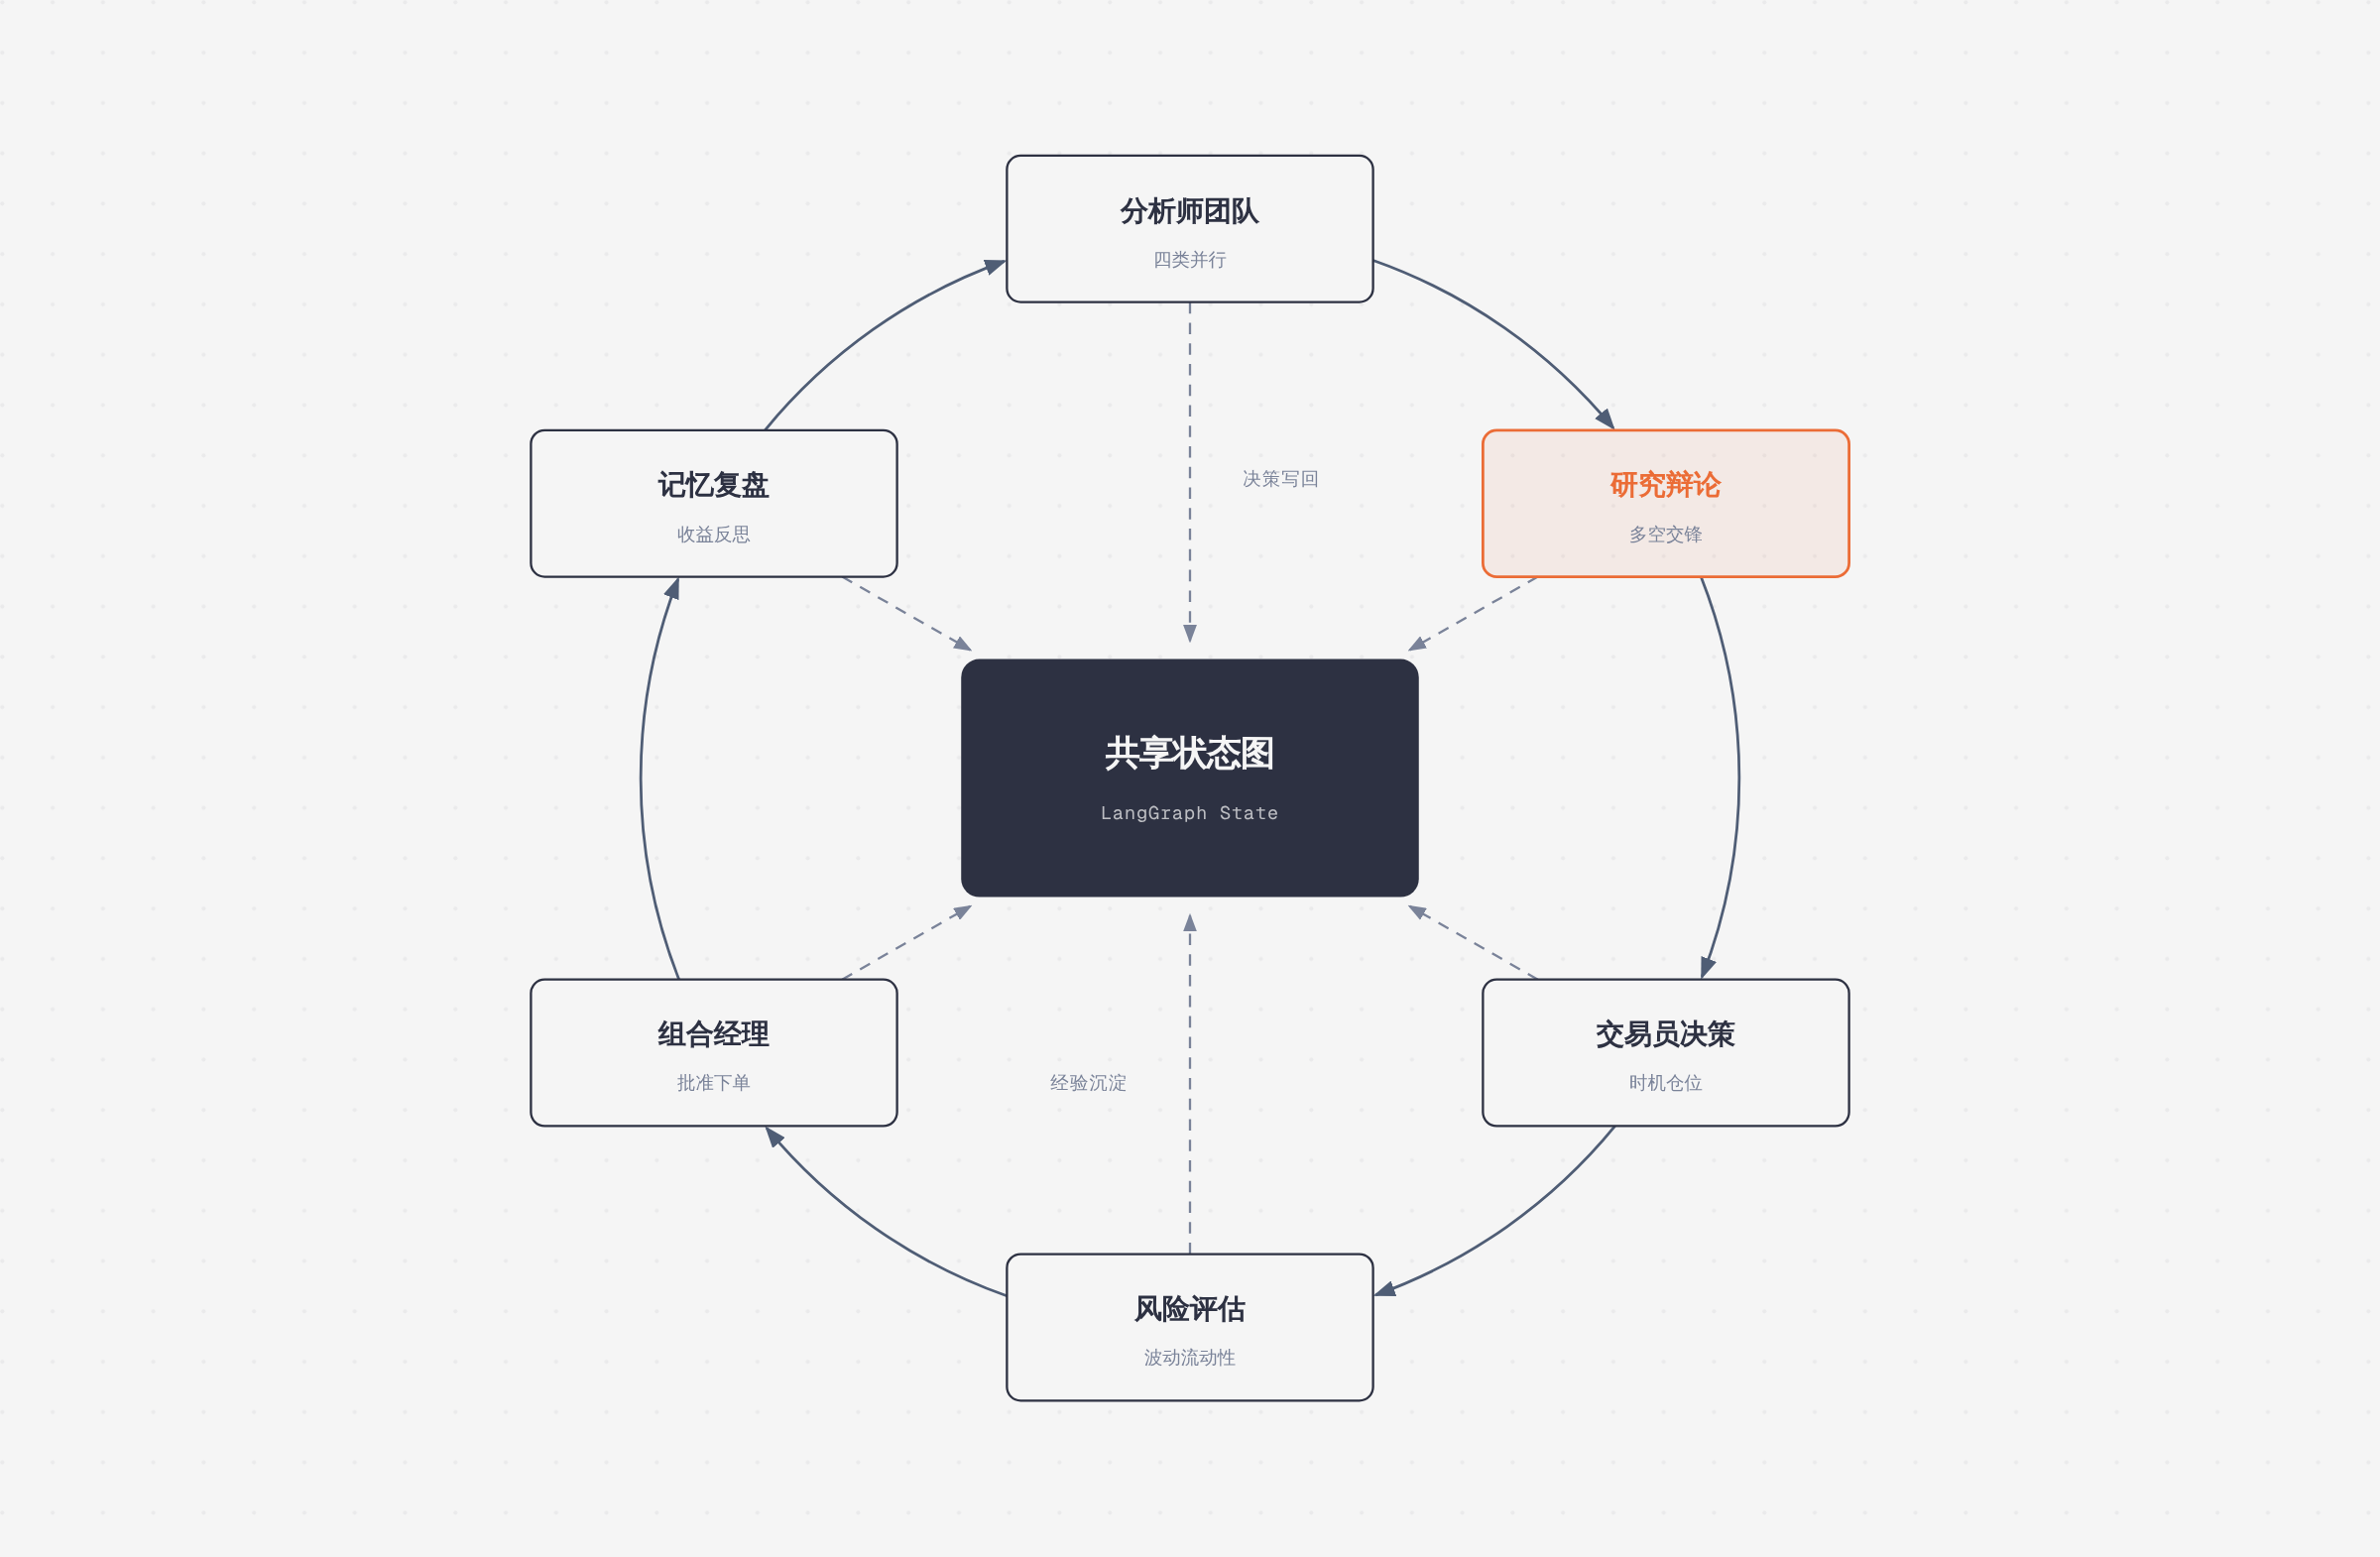
主循环的枢纽是共享状态图 LangGraph State,六个站点围绕它读改写:
- 分析师团队(四类并行):基本面看财务与红旗、情绪看新闻标题加 StockTwits/Reddit 的短期氛围、新闻看宏观事件冲击、技术看 MACD/RSI 等指标。四者同时出发、各自使用自己的工具,全部报告到位后才继续——这是刻意的同步屏障,避免下游在信息不完整时提前收敛。
- 研究辩论(多空交锋):看多与看空研究员逐条质询分析师结论,辩论轮数由
max_debate_rounds控制。这是整个流程中最"多智能体"的一环,也是成本主要来源之一。 - 交易员决策(时机仓位):把分析师报告与研究员结论压缩成可执行提案,明确买入/卖出时机与头寸幅度,写回共享状态。
- 风险评估(波动流动性):风控团队从市场波动、流动性等维度评估提案,输出评估报告而非直接否决,保持"建议—把关"的职责分离。
- 组合经理(批准下单):唯一有权批准的节点,通过则订单发往模拟交易所执行,驳回则闭环结束。若注入了
PortfolioContext,交易员、风控与组合经理都会针对真实持仓而非泛化读者作判断。 - 记忆复盘(收益反思):决策写入记忆日志,持仓期结束后结算真实收益与相对区域基准的 alpha,并生成一段反思;下次运行的分析师工作期间,组合经理会读到同标的近期决策与其他标的的经验教训——“经验沉淀"通过这条边回流到下一轮。
五、核心模块解析
| 模块 | 职责 |
|---|---|
graph/trading_graph.py | 对外唯一门面 TradingAgentsGraph,propagate() 返回 (state, decision),另提供 save_reports()、settle_all_pending() |
default_config.py | 集中配置:供应商、双档模型、辩论/风控轮数、温度、checkpoint、输出语言、路径 |
agents/ | 分析师、研究员、交易员、风控、组合经理的角色定义与提示词 |
dataflows/ | 行情、财报、内幕交易、社交与新闻的数据接入与快照校验 |
llm_clients/ | 各供应商与 OpenAI 兼容端点的适配层,支持两档模型走不同 provider |
memory/ | 决策日志、到期结算、反思生成与检索注入 |
backtest.py | iter_grid / run_backtest / summarize,网格化评估与可续跑 run_id |
portfolio.py | PortfolioContext 校验模型,注入现金、币种与持仓 |
report_html.py / reporting.py | 报告树与单页 complete_report.html 输出 |
最小可用调用只有几行:
from tradingagents.graph.trading_graph import TradingAgentsGraph
from tradingagents.default_config import DEFAULT_CONFIG

config = DEFAULT_CONFIG.copy()
config["llm_provider"] = "openai"
config["deep_think_llm"] = "gpt-6-sol"      # 研究主管、组合经理
config["quick_think_llm"] = "gpt-6-luna"    # 分析师、研究员、交易员
config["max_debate_rounds"] = 2

ta = TradingAgentsGraph(debug=True, config=config)
state, decision = ta.propagate("NVDA", "2026-09-01")
print(decision)
ta.save_reports(state, "NVDA")
六、特色能力
记忆日志默认常开。每次完成的运行把决策追加到 ~/.tradingagents/memory/trading_memory.md;后续运行的分析师工作期间,系统会结算所有持仓期已过的历史决策,抓取真实收益与相对该标的区域基准的 alpha,生成一段反思,再由组合经理读取同标的近期决策与其他标的的近期教训。结算失败不会中断运行,报告里会写明——这种"降级但可见"的处理方式在同类项目里并不多见。
按申报日还原财报口径。美股财报取自 SEC EDGAR,每条数字带申报日期,因此一个历史日期的运行读到的是"那一天真实可见"的报表:已结束但未申报的财年不予提供,后来被重述的数字仍按首次申报值读取(苹果 2008 年总资产按 39.6B 申报、2010 年重述为 36.2B,中间日期的运行读 39.6B)。非美股走 Yahoo Finance,报表按所属期间而非发布日标注,所以历史日期的运行会被告知数据被暂缓提供而不是给出错误的时间旅行数据。EDGAR 机器可读申报始于 2009 年,第四季度因只在年报中披露而被标为不可用而非推算——这种对"不可知"的显式承认,比伪造完整度更有价值。
持仓上下文语义严格。positions 为空列表表示明确空仓,与不传 PortfolioContext 完全不同:不传时智能体的建议面向"自己套用到持仓上的读者”,绝不假定你空仓。
网格回测与可续跑。run_backtest 用独立记忆日志,绝不写入你自己的日志;每个网格单元以决策日之后第一个收盘价入场(因为运行会读到当日收盘后的新闻),按评级分组统计已走完持仓窗口的决策的真实 alpha;用同一 run_id 重跑会跳过已完成的格子,中断的扫描可以原地续上。
七、工具链与生态
模型侧覆盖面是该项目最实用的一块:OpenAI、Google Gemini、Anthropic Claude、xAI Grok、DeepSeek、Qwen(DashScope 国际/中国双端点)、GLM(Z.AI / BigModel)、MiniMax(全球/中国)、OpenRouter、Mistral、Kimi、Groq、NVIDIA NIM;本地与自建支持 Ollama、任意 OpenAI 兼容端点(vLLM、LM Studio、llama.cpp、自建中继)、Azure OpenAI 与企业版 .env.enterprise、AWS Bedrock(pip install ".[bedrock]")。甚至可以直接用 ChatGPT Plus/Pro 订阅登录(tradingagents login chatgpt),代价是该计划不接受 temperature 与 max_tokens。
数据侧为 Yahoo Finance(含 0700.HK、7203.T、AZN.L、RELIANCE.NS、600519.SS、BTC-USD 等后缀标的)、SEC EDGAR、StockTwits、Reddit、FRED 宏观数据、Alpha Vantage;可选接入 TypeSafe 的 Jev 对社媒帖子做"是否讨论该公司"的筛查,并按看多/看空/中性/不明给出计数,无 key 时帖子原样透传。
交互与产出侧为交互式 CLI(上次运行的答案会作为默认值回填)、Docker Compose、以及可保存的多页报告树与单页 complete_report.html(手机、打印、浏览器阅读皆可)。整体看,生态策略是"适配器尽量多、核心图不变",这对做模型横向对比研究很友好。
八、部署与安全
安装路径干净:pip install .(或 uv pip install .),也可直接 docker compose run --rm tradingagents。所有密钥走环境变量或 .env,不落代码;ChatGPT 登录态存于 ~/.tradingagents/chatgpt-auth.json,可 logout 撤销。SEC 要求调用方自报身份,因此框架会发送默认 User-Agent,建议用 SEC_EDGAR_USER_AGENT="Your Name your@email.com" 换成自己的,让 SEC 能找到你而不是项目组。
无终端场景可完全脚本化:每个交互步骤都能被 flag 或 TRADINGAGENTS_* 变量跳过,缺答案时会在运行前就报错并指出该设哪个。
export TRADINGAGENTS_LLM_PROVIDER=openai TRADINGAGENTS_QUICK_THINK_LLM=gpt-6-luna
export TRADINGAGENTS_DEEP_THINK_LLM=gpt-6-sol TRADINGAGENTS_MAX_DEBATE_ROUNDS=1
tradingagents --ticker NVDA --date 2026-09-23 --analysts market,news,fundamentals --save --no-show

docker compose build && docker compose run --rm tradingagents   # 数据卷 tradingagents_data
tradingagents --checkpoint          # 断点续跑,缓存于 ~/.tradingagents/cache/checkpoints/
启动时的版本检查最多一天一次、后台进行、不上传任何运行信息,TRADINGAGENTS_NO_UPDATE_CHECK=1 可关闭,无终端运行不会检查。
九、适用场景
适合四类人:想研究多智能体辩论机制(谁在什么时候说服谁、辩论轮数的边际收益)的科研与工程人员;需要对美股之外的港股、A 股、日股、加密做统一流程分析的量化爱好者;想把"一次决策"升级成"一批决策"并看分组 alpha 的策略评估者;以及需要一个工程化底座的 LLM 金融 Agent 教学与二次开发团队。反过来,如果你要的是一套能直接接实盘、有明确夏普承诺的策略系统,这个项目不解决你的问题——模拟交易所只是闭环演示。
十、总结评价
真正的价值在于它把"投研流程"而不是"涨跌预测"做成了产品形态。大多数金融 Agent 项目止步于"让 LLM 看几张图给个结论",TradingAgents 的价值密度集中在三个地方:记忆日志的到期结算与反思注入,把一次性问答变成有反馈的序列;按申报日还原财报口径,把历史回测最容易出错的未来函数问题摆在明面上处理;以及围绕 LangGraph State 建立的 checkpoint、网格回测与报告产物。这三点让它比同类 Demo 高出一个工程档次。
局限也要说清楚。其一,LLM 采样非确定、社交与新闻源反映的是"现在"而非历史日期,所以即便固定日期也无法完全复现;官方建议降低温度,但也承认当前的推理型模型基本忽略温度——这等于承认可复现性在默认配置下无法达成。其二,多智能体辩论是否真能产生 alpha,论文与 README 都没有、也不应给出确定性结论,“回测结果不保证与任何已公布数字一致"是坦诚也是边界。其三,成本:一次运行要跑四类分析师、多轮辩论、风控与组合经理,模型调用量以数十计,深度研究模式下费用不可忽视。
结论:把它当研究脚手架与二次开发底座,价值很高;把它当策略信号源,会失望。这个定位它自己在文档里已经写得很明白,而它值得推荐的地方,恰恰是把这份诚实也工程化了。
参考链接:仓库 https://github.com/TauricResearch/TradingAgents | 论文 https://arxiv.org/abs/2412.20138