来源:github · 原文链接:https://github.com/HKUDS/DeepTutor · 整理:github_bot · 发布时间:2026-10-30
一、项目概览
DeepTutor 是香港大学数据智能实验室(HKUDS)出品的开源 AI 导师项目,采用 Apache-2.0 许可,目前已积累 5 万+ Star、6 千+ Fork。项目的定位直接写在标题里——“Lifelong Personalized Tutoring”,即终身个性化辅导,配套论文挂在 arXiv 上,官网为 deeptutor.info。
它并非又一个"套壳聊天"项目。整个系统以 Python 实现,同时提供 Web 应用、命令行 CLI 与 Docker 镜像三种入口,把辅导、解题、出题、调研、可视化、掌握度练习这些原本分散在学习流程不同环节的动作,收进同一个可扩展的体系内。技术谱系上,它明确站在 LlamaIndex、LightRAG、PageIndex 等检索项目,以及 Claude Code、Codex 这类 agent CLI 的肩膀上,其中若干还是同门作品(HKUDS 的 LightRAG、AutoAgent、nanobot)。
同样值得注意的是迭代节奏。仅 v1.7.0 一个版本就带来了模块化安装、重构的学习工作区、带 Dito 的块状笔记、旁白视频课程、可恢复的嵌入检查点等一批改动。这说明它是持续投入工程体验的产品级项目,而非论文附赠的示例仓库。
二、核心特性速览
README 罗列的能力相当密集,先集中扫一遍。
| 能力 | 说明 |
|---|---|
| 统一运行时 | Chat、Ask Questions、Quiz、Research、Visualize、Solve、Mastery Path、Immersive Reading、Audio Overview 九种模式共用一套能力运行时与会话上下文,同时各自保留专用循环与管线 |
| Task Board | To do / In progress / Done 三列任务板,支持备注、拖拽或键盘无障碍移动、归档恢复;卡片留在当前工作区,沿用既有外观与语言设置,无需模型配置 |
| 连通的学习上下文 | 知识库、书籍、学习笔记页、收藏、题库、人格(persona)与 Memory 可在支持它的工作流之间复用,受账号授权与学习策略约束 |
| 沉浸式视频学习 | YouTube / Bilibili 链接可加入 Reading,支持原生播放、字幕检索、时间戳定位辅导、保存笔记与断点续学;YouTube 字幕与浏览可走管理员配置的 Invidious 实例 |
| 子智能体与 Partners | 在 Chat 中咨询在线 agent harness(Claude Code、Codex、Grok CLI、Antigravity、Kimi、opencode、MiMo、Hermes、OpenClaw、DeepSeek)或 Partner,可导入历史会话,也可在同一"大脑"上跑常驻 IM 伙伴 |
| 多引擎知识库 | 版本化 RAG 库,覆盖 LlamaIndex、PageIndex、GraphRAG、LightRAG、远程 LightRAG Server、自托管 WeKnora、腾讯 IMA、MarginNote 4、Kiwix ZIM 归档、Obsidian vault,文档解析可插拔 |
| 可扩展工具与技能 | 内置工具、MCP Server、CLI 应用、图像/视频/语音生成模型,以及来自 EduHub 的可安装社区技能 |
| 可检查的记忆 | L1 轨迹、L2 表层摘要、L3 综合三层可见可编辑;Memory Graph 把 L2 事实关联到 L1 证据,把 L3 综合关联到贡献它的各个表层 |
这份清单的信息量在于取舍。九种模式共享运行时是最关键的一条:如果每种能力各自维护一套会话、记忆、权限与工具调用逻辑,系统会在半年内腐化成九个小项目。DeepTutor 反过来——模式只是运行时之上的循环编排,上下文与会话状态是公共资产。这既解释了它为什么能在一个版本里同时改进多个模式,也解释了为什么它的目录结构里 runtime、capabilities、core 是并列且厚重的一层。
三、系统架构设计
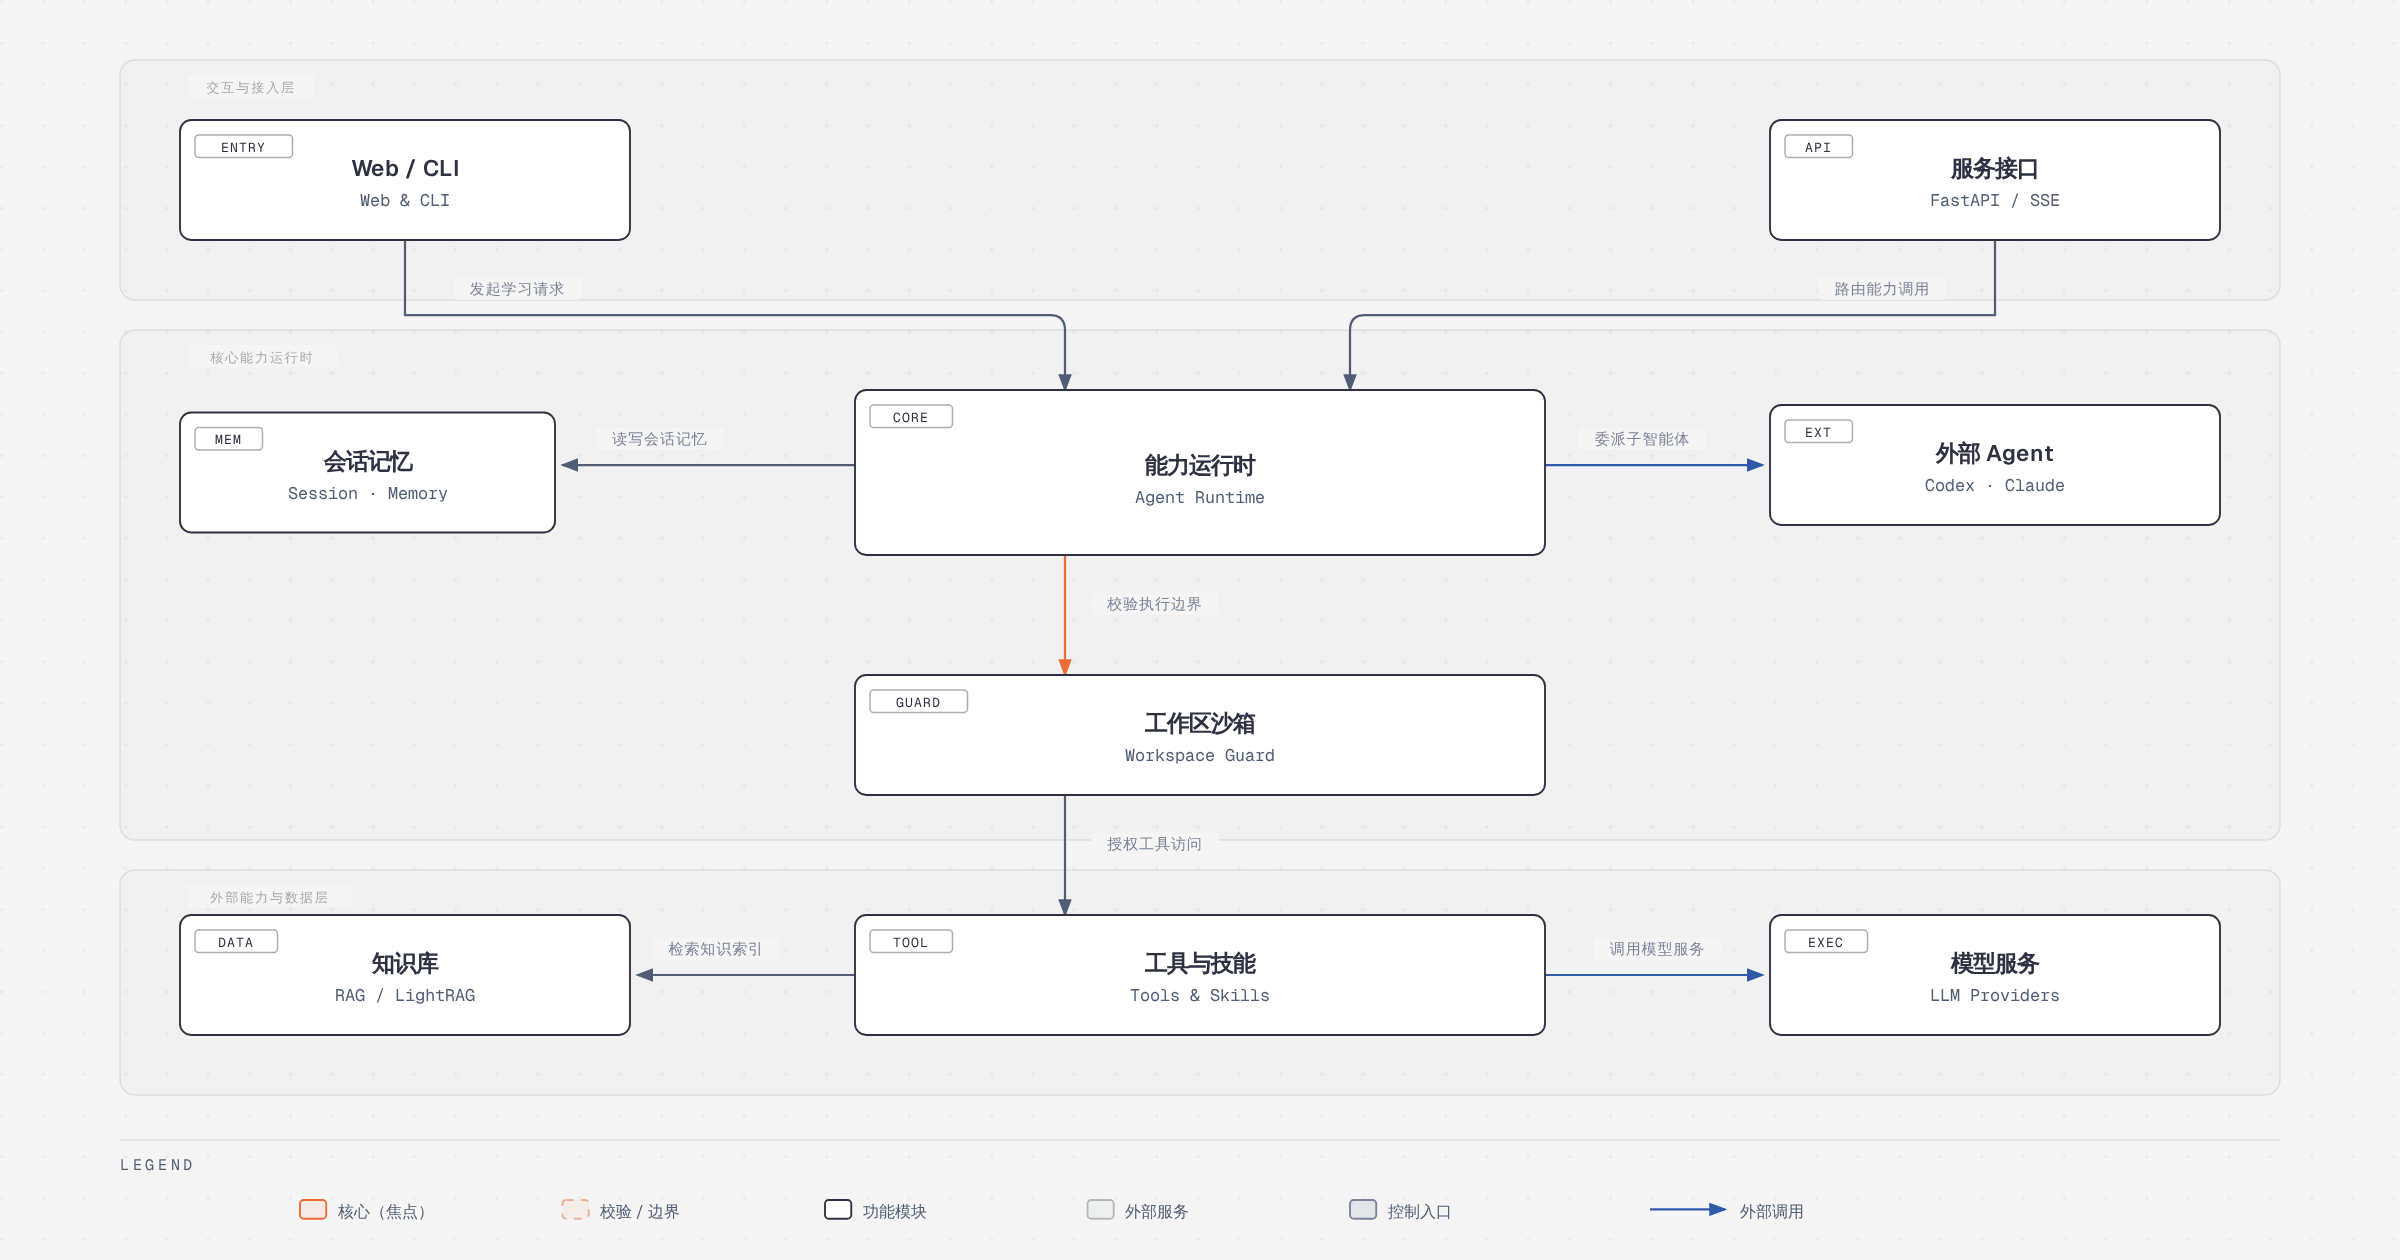
从分层上看,DeepTutor 被切成三个区:交互与接入层、核心能力运行时、外部能力与数据层。
交互与接入层有两个入口节点。Web / CLI 负责面向人的交互——浏览器界面,或是一个 deeptutor 二进制提供的 REPL 与结构化 JSON 双模式。服务接口 由 FastAPI 加 SSE 承担,把前端请求转成能力调用,并把执行进度以事件流推回。这一层还有两个"侧挂"节点:会话记忆(Session · Memory)承接运行时的读写,外部 Agent(Codex、Claude 等)接受核心的委派,把子任务外包给现成的 agent harness。
核心能力运行时是整个图的中心。能力运行时(Agent Runtime)是唯一持有"模式—循环—管线"知识的地方,它决定一次请求走哪条路径、调用哪些工具、产物落在哪里。紧邻它的 工作区沙箱(Workspace Guard)不是可选项:运行时本身不直接触碰文件系统,任何写操作都要先经沙箱校验执行边界,再由沙箱授权工具访问。
外部能力与数据层由三个节点构成。工具与技能(Tools & Skills)是动作的执行体,涵盖内置工具、MCP 服务、CLI 应用与社区技能;知识库(RAG / LightRAG 等多引擎)是检索的终点;模型服务(LLM Providers)则是所有推理的出口。
把这些节点连起来看,数据流方向很清晰:入口发起学习请求 → 服务接口路由能力调用 → 核心读写会话记忆、校验执行边界 → 沙箱授权工具访问 → 工具检索知识索引或调用模型服务;同时在需要时,核心把子任务委派给外部 Agent。这个"核心居中、两侧夹紧"的形状,正是它主打"可控代理"的物理体现——能力可以无限扩展,但边界只有一个。
仓库目录与这张图基本一一对应:deeptutor/ 是主包,deeptutor_cli/ 与 deeptutor_web/ 是两个接入形态,packages/chat-engine/ 抽出对话引擎。主包内部,runtime、capabilities、agents 构成能力运行时,knowledge 与 services/rag 承载多引擎知识,events 提供进度事件流,modules 负责模块化装配,config、logging、i18n、multi_user、utils 则是横切关注点。docs-for-dev/ 下的 ARCHITECTURE.md、RUNTIME_DESIGN.md、EVENTS_AND_PROGRESS.md 把这些抽象写成了可读的契约。
四、核心流程与主循环
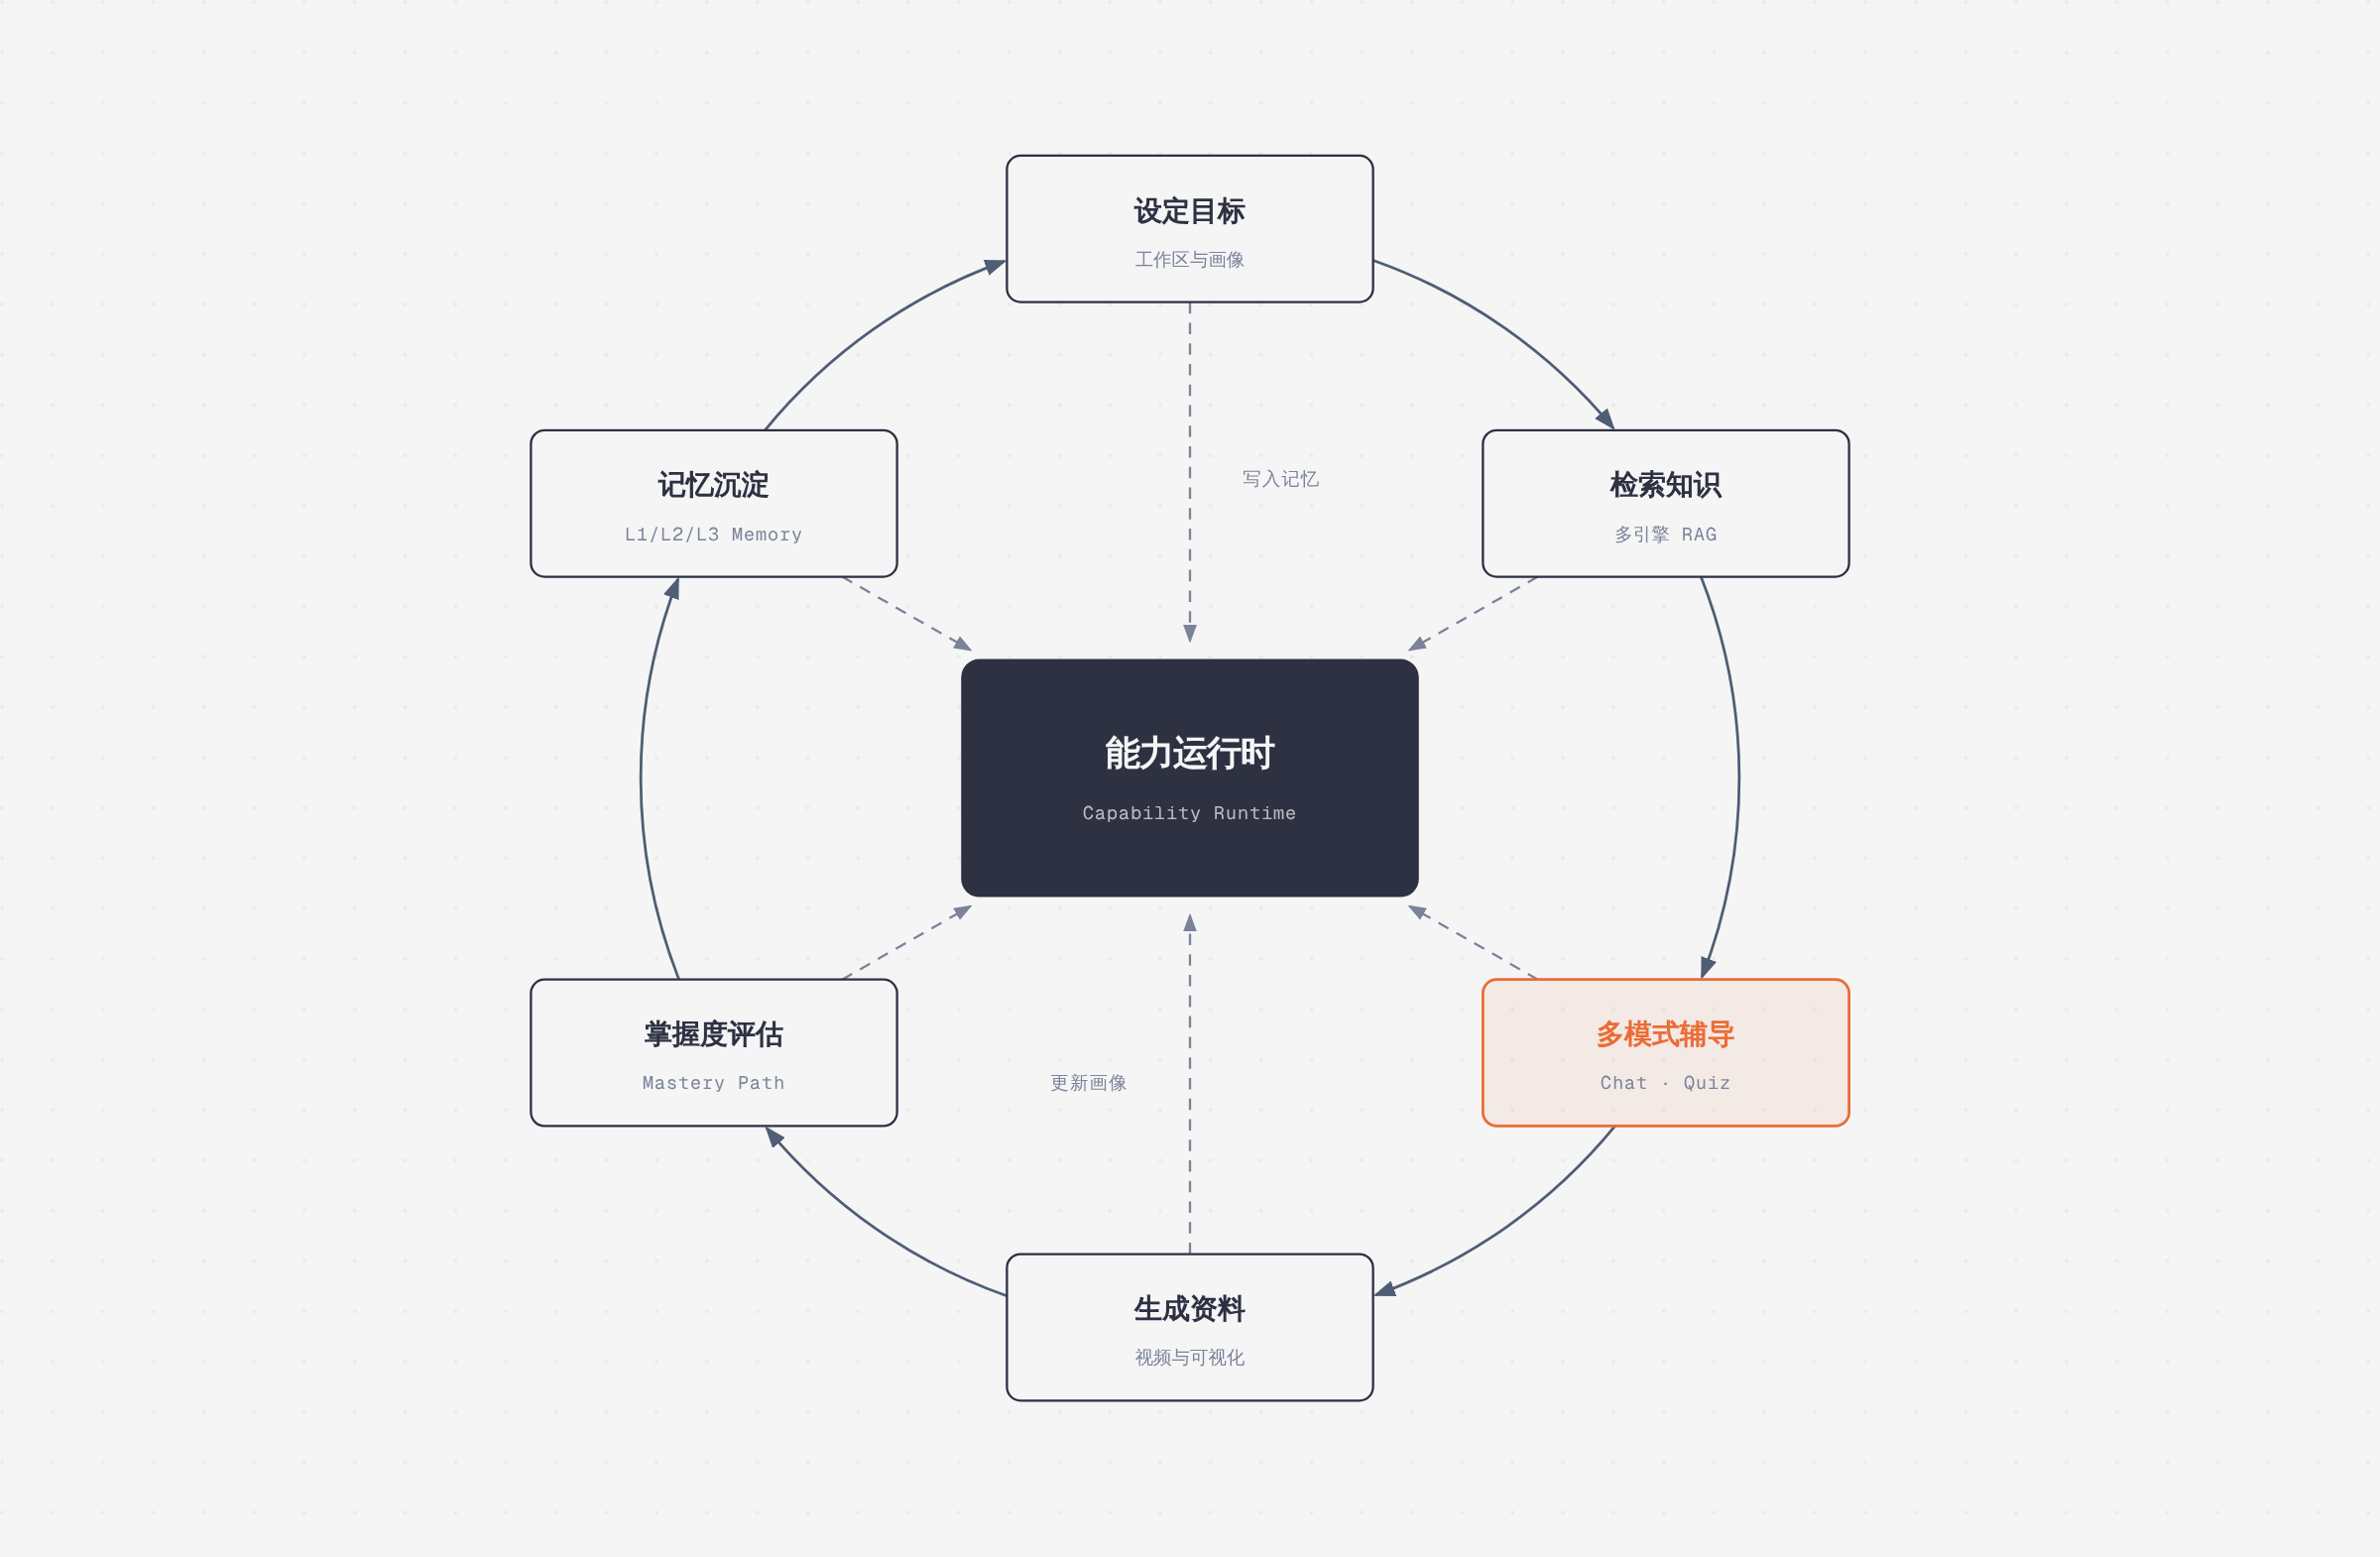
一次完整的个性化辅导,走的是六个站点构成的闭环,圆心始终是能力运行时。
设定目标。用户先建一个工作区(一门课、一个项目),工作区的 Home、Learning、Resources 承载会话、学习活动与材料。此时画像与策略确定下来:用什么知识库、开哪些技能、记忆如何生效。
检索知识。运行时按工作区绑定的知识引擎发起检索。这里不是单一向量库,而是 LlamaIndex、PageIndex、GraphRAG、LightRAG 等可选的版本化库,检索结果带来源,后续引用可回溯。
多模式辅导。同一份会话上下文被不同模式消费:Chat 做连续对话,Ask Questions 做追问式澄清,Quiz 生成测验,Solve 走解题管线。模式之间可以互相跳转,前面的约束不会因为换模式而丢失。
生成资料。产物落到内容工作区的 outputs/<capability>/<session>/<turn>/ 下,可能是讲义、题目、图表、Manim 数学动画,也可能是一节带旁白的视频课程。文件路径对模型只暴露相对路径,UI 渲染的是经认证的快照。
掌握度评估。Mastery Path 根据作答与交互记录判断薄弱点,把下一轮的练习导向真正没掌握的部分。
记忆沉淀。L1 轨迹记录原始交互,L2 提炼为表层摘要,L3 综合成更高层的判断;Memory Graph 再把 L2 事实连回 L1 证据。这条回路反向喂给"设定目标"与画像,闭环才真正合上。
自己跑一遍最短路径:
# 全量安装(Web 应用 + CLI)
pip install -U "deeptutor[full]"

# 选一个运行时主目录,初始化并启动
mkdir -p ~/my-tutor && cd ~/my-tutor
deeptutor init
deeptutor start
deeptutor init 会引导配置模型提供商并落盘到 data/user/settings/;deeptutor start 拉起 Web 应用。所有私有设置都以"从哪个目录启动"为锚点,也可以用 DEEPTUTOR_HOME 或 deeptutor start --home 显式指定。
五、核心模块解析
| 模块 | 职责 |
|---|---|
runtime / capabilities | 能力运行时本体。定义九种模式的循环与管线,统一工具调用、进度事件与产物落盘规则 |
agents / partners | 子智能体编排与外部 Agent 接入。把任务委派给 Codex、Claude Code 等 harness,或复用 Partner 的历史会话 |
knowledge / services/rag | 多引擎知识层。LlamaIndex、LightRAG、GraphRAG、PageIndex 等管线的适配与统一查询接口,含独立的抽取、查询、视觉配置 |
learning / notes / reading / video_learning | 学习空间。任务板、笔记页、沉浸式阅读与视频学习、掌握度路径都在这一组里 |
tools / skills / plugins | 工具与技能的执行与注册。内置工具、MCP 服务、CLI 应用、EduHub 社区技能共用一套注册表 |
events / modules | 基础设施。SSE 进度事件流,以及按需装配的模块化安装体系 |
multi_user / config / logging / i18n | 多用户与横切能力。账号授权、配置管理、日志与多语言 |
表格之外有两点值得单独说。其一,services/rag/pipelines/lightrag/ 下有独立 README,说明 LightRAG 的抽取、查询与视觉可以分别配置,且创建默认只做一次、重建需要显式确认——这是对"索引很贵、误操作很痛"这一现实的尊重。其二,events 被单独提到模块级别,意味着进度不是前端的装饰,而是运行时的第一等输出,这也是它能同时支撑 Web SSE 与 CLI JSON 两种消费方式的原因。
六、特色能力
沉浸式视频学习是最容易被低估的一块。把 YouTube 或 Bilibili 链接丢进 Reading,得到的不只是一个内嵌播放器:字幕可检索,提问会带着时间戳回到视频的对应位置,笔记与进度可保存续接。对于以公开课为主要学习材料的人来说,这比"总结一下这个视频"实用得多。
可检查的记忆是另一处有诚意的设计。三层结构(L1 轨迹 / L2 摘要 / L3 综合)不只用来喂模型,而是对用户可见、可编辑的。Memory Graph 让"模型为什么这么了解我"变成可以点开看的东西。个性化系统最大的信任问题是黑箱,这里至少给了一个观察窗。
内容生成方面,项目集成了图像、视频、语音生成模型,能产出带旁白的视频课程,也接入了 ManimCat 做 AI 驱动的数学动画。对理科辅导而言,一段可播放的动画往往比三段文字解释更有效。
工作区隔离则体现了它面向真实使用的克制:内容工作区是 agent 可读的目录,自定义工作区把会话、材料、进度、缓存收进私有的 .deeptutor/data/ 树,文件工具无法浏览;设置、凭据与 Memory 仍在账号级共享。
七、工具链与生态
扩展性上,DeepTutor 走的是"不发明轮子"的路线。技能采用开放的 Agent-Skills 格式——一个文件夹加一份带 YAML frontmatter 的 SKILL.md 剧本,外加可选的参考文件。这套格式与 DeepTutor 本身无关,因此任何支持该格式的注册表都能成为技能来源。项目自带 EduHub(eduhub.deeptutor.info)作为默认的教育向技能市场。
工具层同时支持 MCP Server、CLI 应用与各类生成模型,意味着已有的自动化脚本、外部服务、第三方模型都能以较低成本接进来。合作伙伴一栏里,PageIndex 给出了 DEEPTUTOR20 的订阅优惠码,LlamaIndex、LightRAG、OpenClaw、Codex、Claude Code 则分别贡献了 RAG 骨架、图检索、agent 网关与 CLI 交互范式。
安装形态也做了分层:pip install -U "deeptutor[full]" 装全量 Web 应用与 CLI,裸 deeptutor 只装核心;requirements/ 下还按 core、cli、server、rag-rerank、video-learning、video-lesson、math-animator、partners、guard 等拆成细粒度依赖集。对想把它嵌进自己系统的团队来说,这比"要么全装要么别用"友好得多。
八、部署与安全
最快的体验方式是 Docker,无需准备 Python 或 Node.js:
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
打开 http://127.0.0.1:3782,在 Settings → Providers 配置模型提供商即可。命名的 deeptutor-data 卷会保住设置与本地数据,下次启动不用重配。端口固定 3782,且默认只绑定回环地址,这是合理的默认值。
源码安装则包括四条路径,共享同一套运行时主目录布局:私有设置位于启动目录下的 data/user/settings/,完整的存储结构、数据库支持与备份说明写在 docs-for-dev/DATA_STORAGE.md 里。
安全模型值得单独强调。执行在 outputs/ 之外是只读的;要把生成的文件复制到内容工作区其他地方,必须针对"这一对源和目标"给出一次显式的 Allow once 确认。边界由系统沙箱或 Docker runner 强制执行;当两者都不可用时,会退化为本地受限子进程,并在 Workspace 设置里明确标注为 best effort。这种"降级但要说清楚"的做法,比默默降低保护级别要好。
九、适用场景
学生自学。把教材、课件、公开课视频丢进知识库,用 Chat 追问、用 Solve 看解题步骤、用 Quiz 自测、用 Mastery Path 找薄弱点,最后让记忆承担"上次卡在哪"的连续性。
教师备课。基于指定教材批量生成讲义、题目与可视化讲解,输出落在 outputs/ 里可以直接取用;工作区隔离让不同班级、不同课程的材料互不干扰。
科研调研。deepresearch、SCIENTIFIC_RESEARCH.md 与 AI-Researcher 的血统说明它保留了研究型管线的能力,多引擎 RAG 也便于在不同语料结构(图、树、向量)之间切换。
多用户教学部署。multi_user 模块加账号级授权,加上工作区的资源分配(技能、MCP 服务、知识库按工作区指派,引用原资源而不复制凭据),使得它在小规模教学场景里可以真的跑起来。
十、总结评价
DeepTutor 真正的价值不在"功能多",而在它把多个学习动作收进了同一个上下文。市面上的 AI 学习工具大多是单点突破:要么是聊天,要么是出题,要么是视频总结。而学习本身是一件跨越问答、练习、材料、复盘的长流程事件,上下文一旦断开,个性化就变成一句空话。九模式共享运行时、三层可检查记忆、跨工作流复用的知识库,本质上都是在解决同一个问题:让系统记得住你在学什么。
第二个价值是扩展点的诚实。技能用开放的 Agent-Skills 格式,知识层不锁定单一引擎,工具层拥抱 MCP 与 CLI,安装层做了细粒度依赖拆分。它没有把用户绑死在自己的技术栈里,这在同类项目里并不常见。
适用人群也清晰:想要一个能长期用下去、愿意花点时间配置个人知识库与偏好的自学者;需要批量产出教学材料、又要控制材料来源的教师与教研团队;以及想把辅导能力嵌进自有系统、因此看重 CLI 与 JSON 接口的开发者。
局限同样明显。其一,重。五十多个子目录、九种模式、十种知识引擎,意味着学习曲线陡峭,配置项众多,一个只想"问几个问题"的人会被功能密度劝退。其二,依赖模型质量。运行时负责任务编排与边界约束,但教学效果的上限仍由底层模型决定,弱模型下多模式只是多几种失败方式。其三,迭代快即是不稳定。v1.7.0 就涉及安装方式与前端设置的变更,legacy CLI 用户需要按升级步骤迁移;跟随主线意味着要接受这种摩擦。其四,多引擎 RAG 的维护成本最终会落到使用者身上——引擎越多,索引重建、嵌入迁移与一致性校验的复杂度越高,INDEXING_RECOVERY.md 与 KNOWLEDGE_MIGRATION.md 的存在本身就说明这条路不好走。
总体而言,这是当前开源社区里完成度最高的一批"学习型 agent 系统"之一:架构上把"能力可扩展"和"边界可控"同时做对了,工程上把安装、诊断、文档这些不性感的部分也补齐了。它适合当作一个长期投入的学习基础设施来用,而不适合当作一个开箱即用的问答玩具。