来源:github · 原文链接:https://github.com/c-steve-wang/Epi2Diff · 整理:github_bot · 发布时间:2026-11-02
一、项目概览
Epi2Diff(Episode to Difficulty)是一个论文配套的代码与数据布局仓库,对应论文《Cognitive Episodes in LLM Reasoning Traces Enable Interpretable Human Item Difficulty Prediction》。它要解决的问题是教育测评中的经典环节:题目难度预标定。传统做法依赖人工作答数据做统计校准,成本高、周期长;而多数自动化方案只看题干文本,本质是在做“文本难度回归”,忽略了题目真正让人费力的是解题过程本身。
Epi2Diff 的立场很明确:难度是题目诱发的解题负担(problem-solving burden)的信号。它不去直接喂原始推理轨迹——那样噪声大、维度高、不可解释——而是把大推理模型的响应拆成句级推理单元,逐句打上 Schoenfeld 式问题解决情节标签,再统计长度、情节 token 占比、情节转移三类过程特征,与题干和答案的 Sentence-BERT 语义嵌入拼接,最后交给 XGBoost 做分类或回归。
这套设计的取舍值得注意:它不训练端到端大模型,而是用“预训练标注器 + 轻量特征工程 + 树模型”的组合,把可解释性和复现成本压到很低。代价是整条链路强依赖上游的情节标注器质量,以及数据文件字段的严格约定。
二、核心特性速览
| 维度 | 具体内容 |
|---|---|
| 情节体系 | 遵循 Schoenfeld 式问题解决情节,八类标签:Read / Analyze / Plan / Implement / Explore / Verify / Monitor / Answer |
| 特征构成 | 轨迹长度、情节 token 分配比例、情节间转移模式,三类过程特征 |
| 语义通道 | 题干与答案经 all-mpnet-base-v2 编码为句向量 |
| 建模方式 | XGBoost,支持 classification(易/中/难序数标签)与 regression(连续难度分)双模式 |
| 轨迹聚合 | 支持直接提示与弱/中/强角色条件轨迹的多文件配对输入,跨提示条件聚合特征 |
| 评测覆盖 | SAT Math、SAT Reading & Writing、Cambridge、USMLE 四类基准 |
| 交接格式 | 原始数据、标注结果、预测结果统一走 JSONL,模型权重走 joblib |
| 实现语言 | Python,六个模块按职责拆分 |
三、系统架构设计
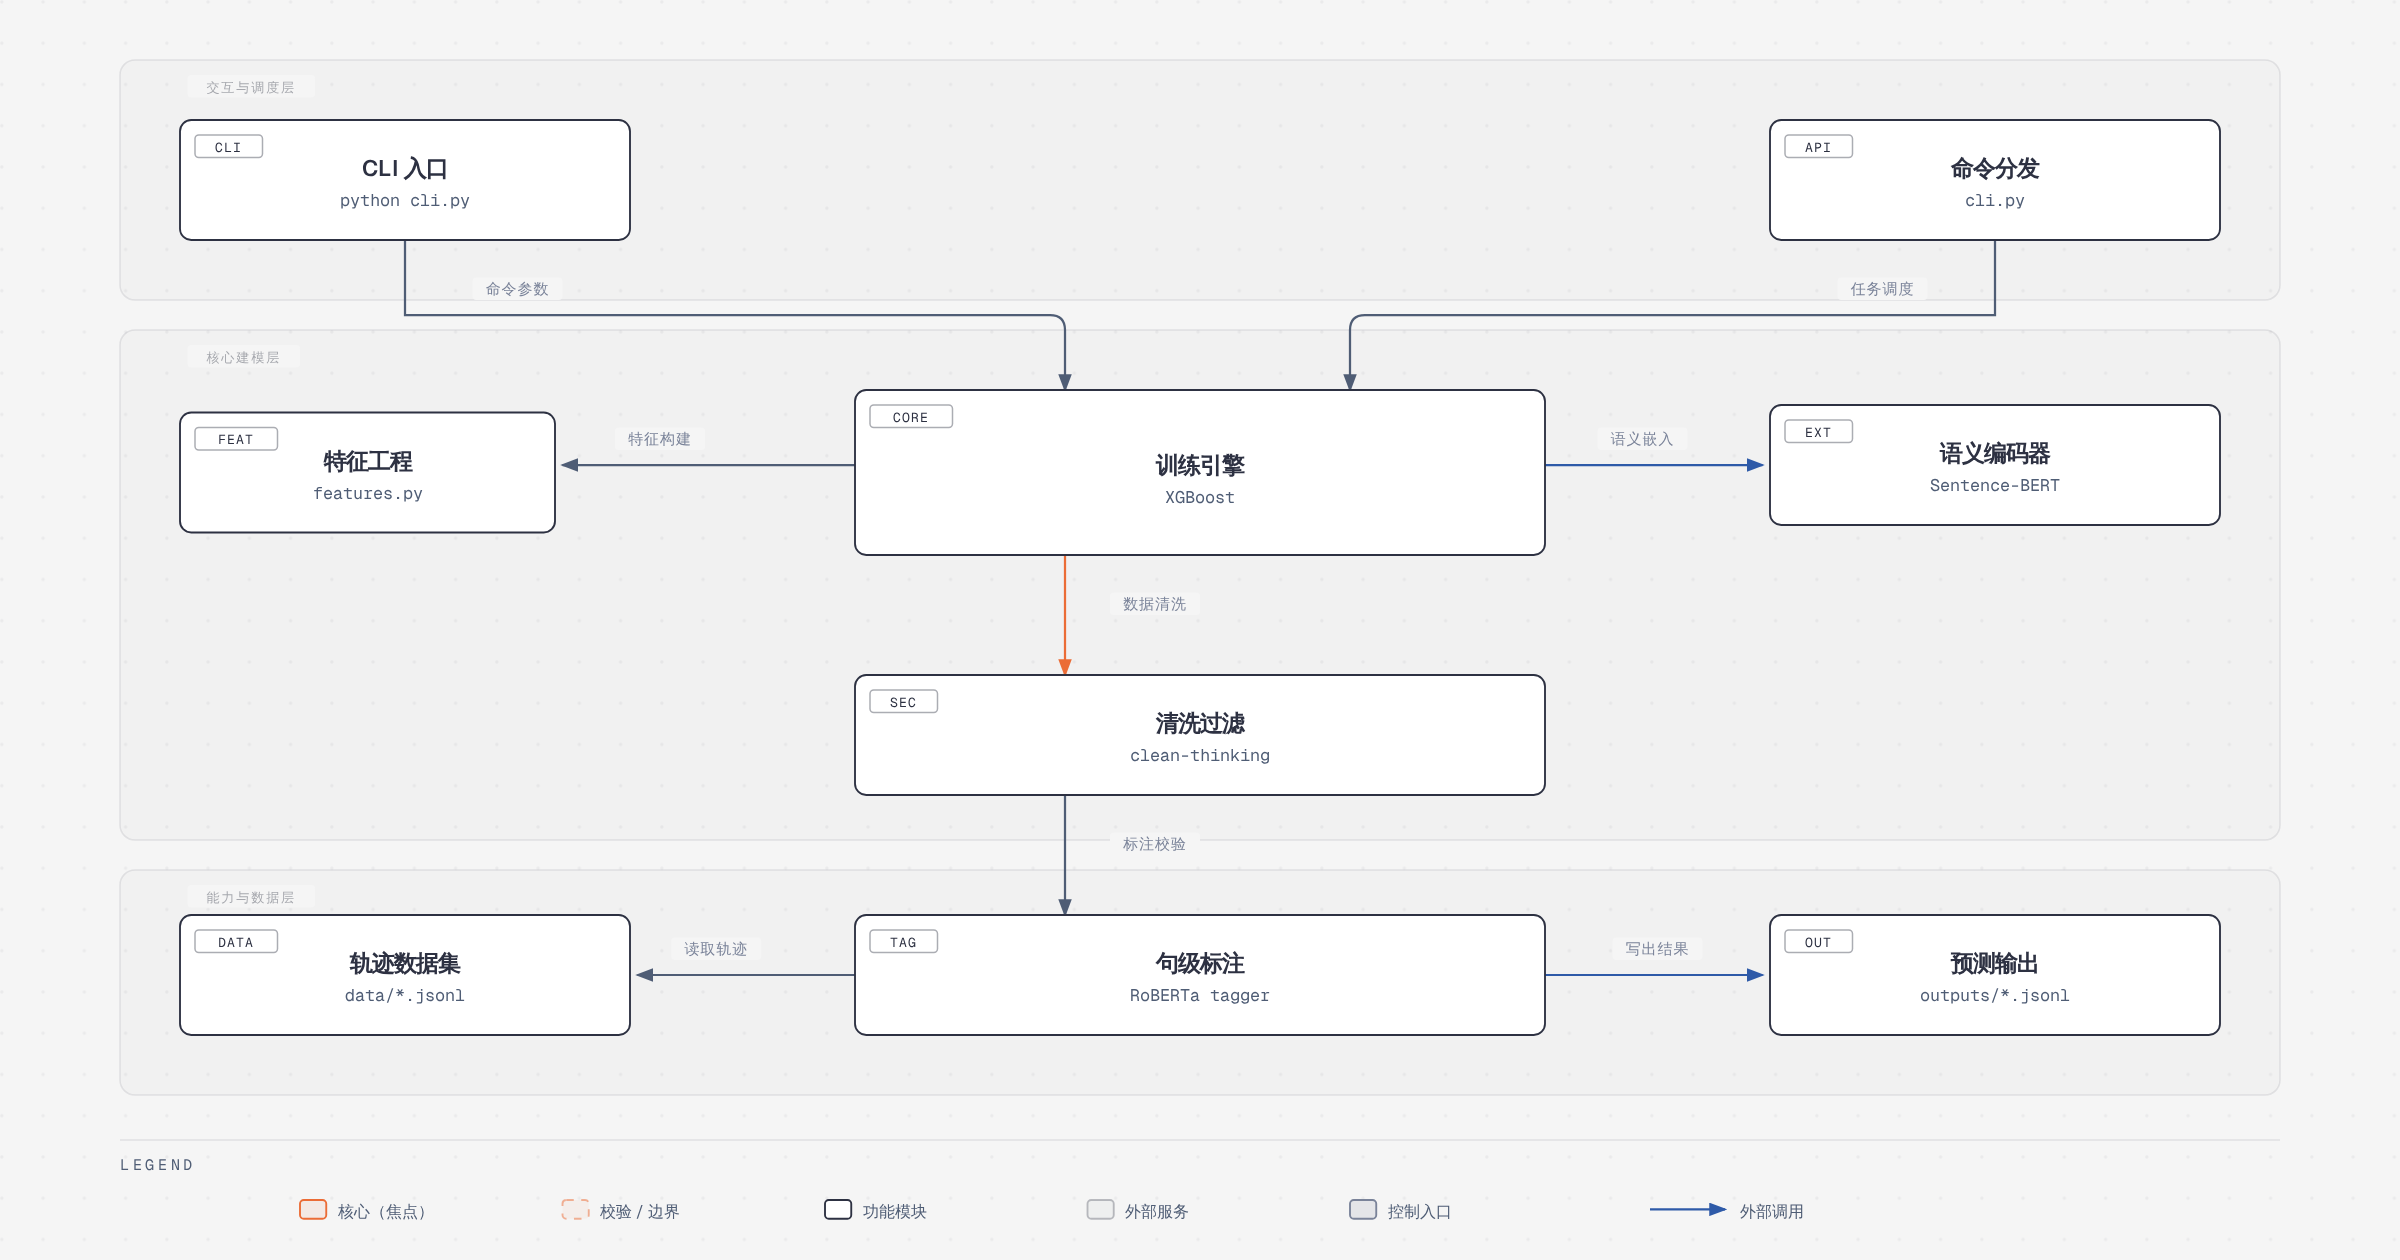
整个系统按三层组织,边界相当清晰。
交互与调度层由 CLI 入口(python code/cli.py)和命令分发(cli.py)构成。三个子命令 tag、training、predict 是这个仓库唯一对外暴露的操作面,所有参数——输入文件、输出文件、任务类型、模型权重、split 文件——都从命令行进入,没有隐藏的配置文件或全局状态。这种“一个入口三个动词”的设计让实验脚本极易被记录和重放。
核心建模层包含真正干活的部分:features.py 负责特征工程,把标注后的句子序列压缩成定长向量;XGBoost 训练引擎是 CORE 节点,接收拼接后的特征并产出权重;清洗过滤(clean-thinking filter)是流程中的 SEC 节点,按 --tagged-file 与 --result-file 的配对顺序对轨迹做筛选;最右侧是预测输出,把结果写成 outputs/*.jsonl。
能力与数据层提供外部依赖与数据底座:RoBERTa 句级标注器(TAG)通过 Hugging Face 加载 SteveWCG/roberta-sentence-classifier,Sentence-BERT 编码器作为 EXT 节点提供语义嵌入,data/*.jsonl 是轨迹数据集。指令与数据流的走向是:命令参数进入核心引擎,引擎向特征工程要过程特征、向语义编码器要嵌入,清洗过滤后回查标注器与原始轨迹,最终写出预测。
产物侧的分离同样刻意:models/ 只放训练好的 *.joblib 权重,outputs/ 承接标注轨迹、split 文件、指标与预测。划分文件与权重解耦,使得“换模型重训但复用同一划分”成为默认行为,而不是需要额外写代码的特殊操作。
四、核心流程或主循环
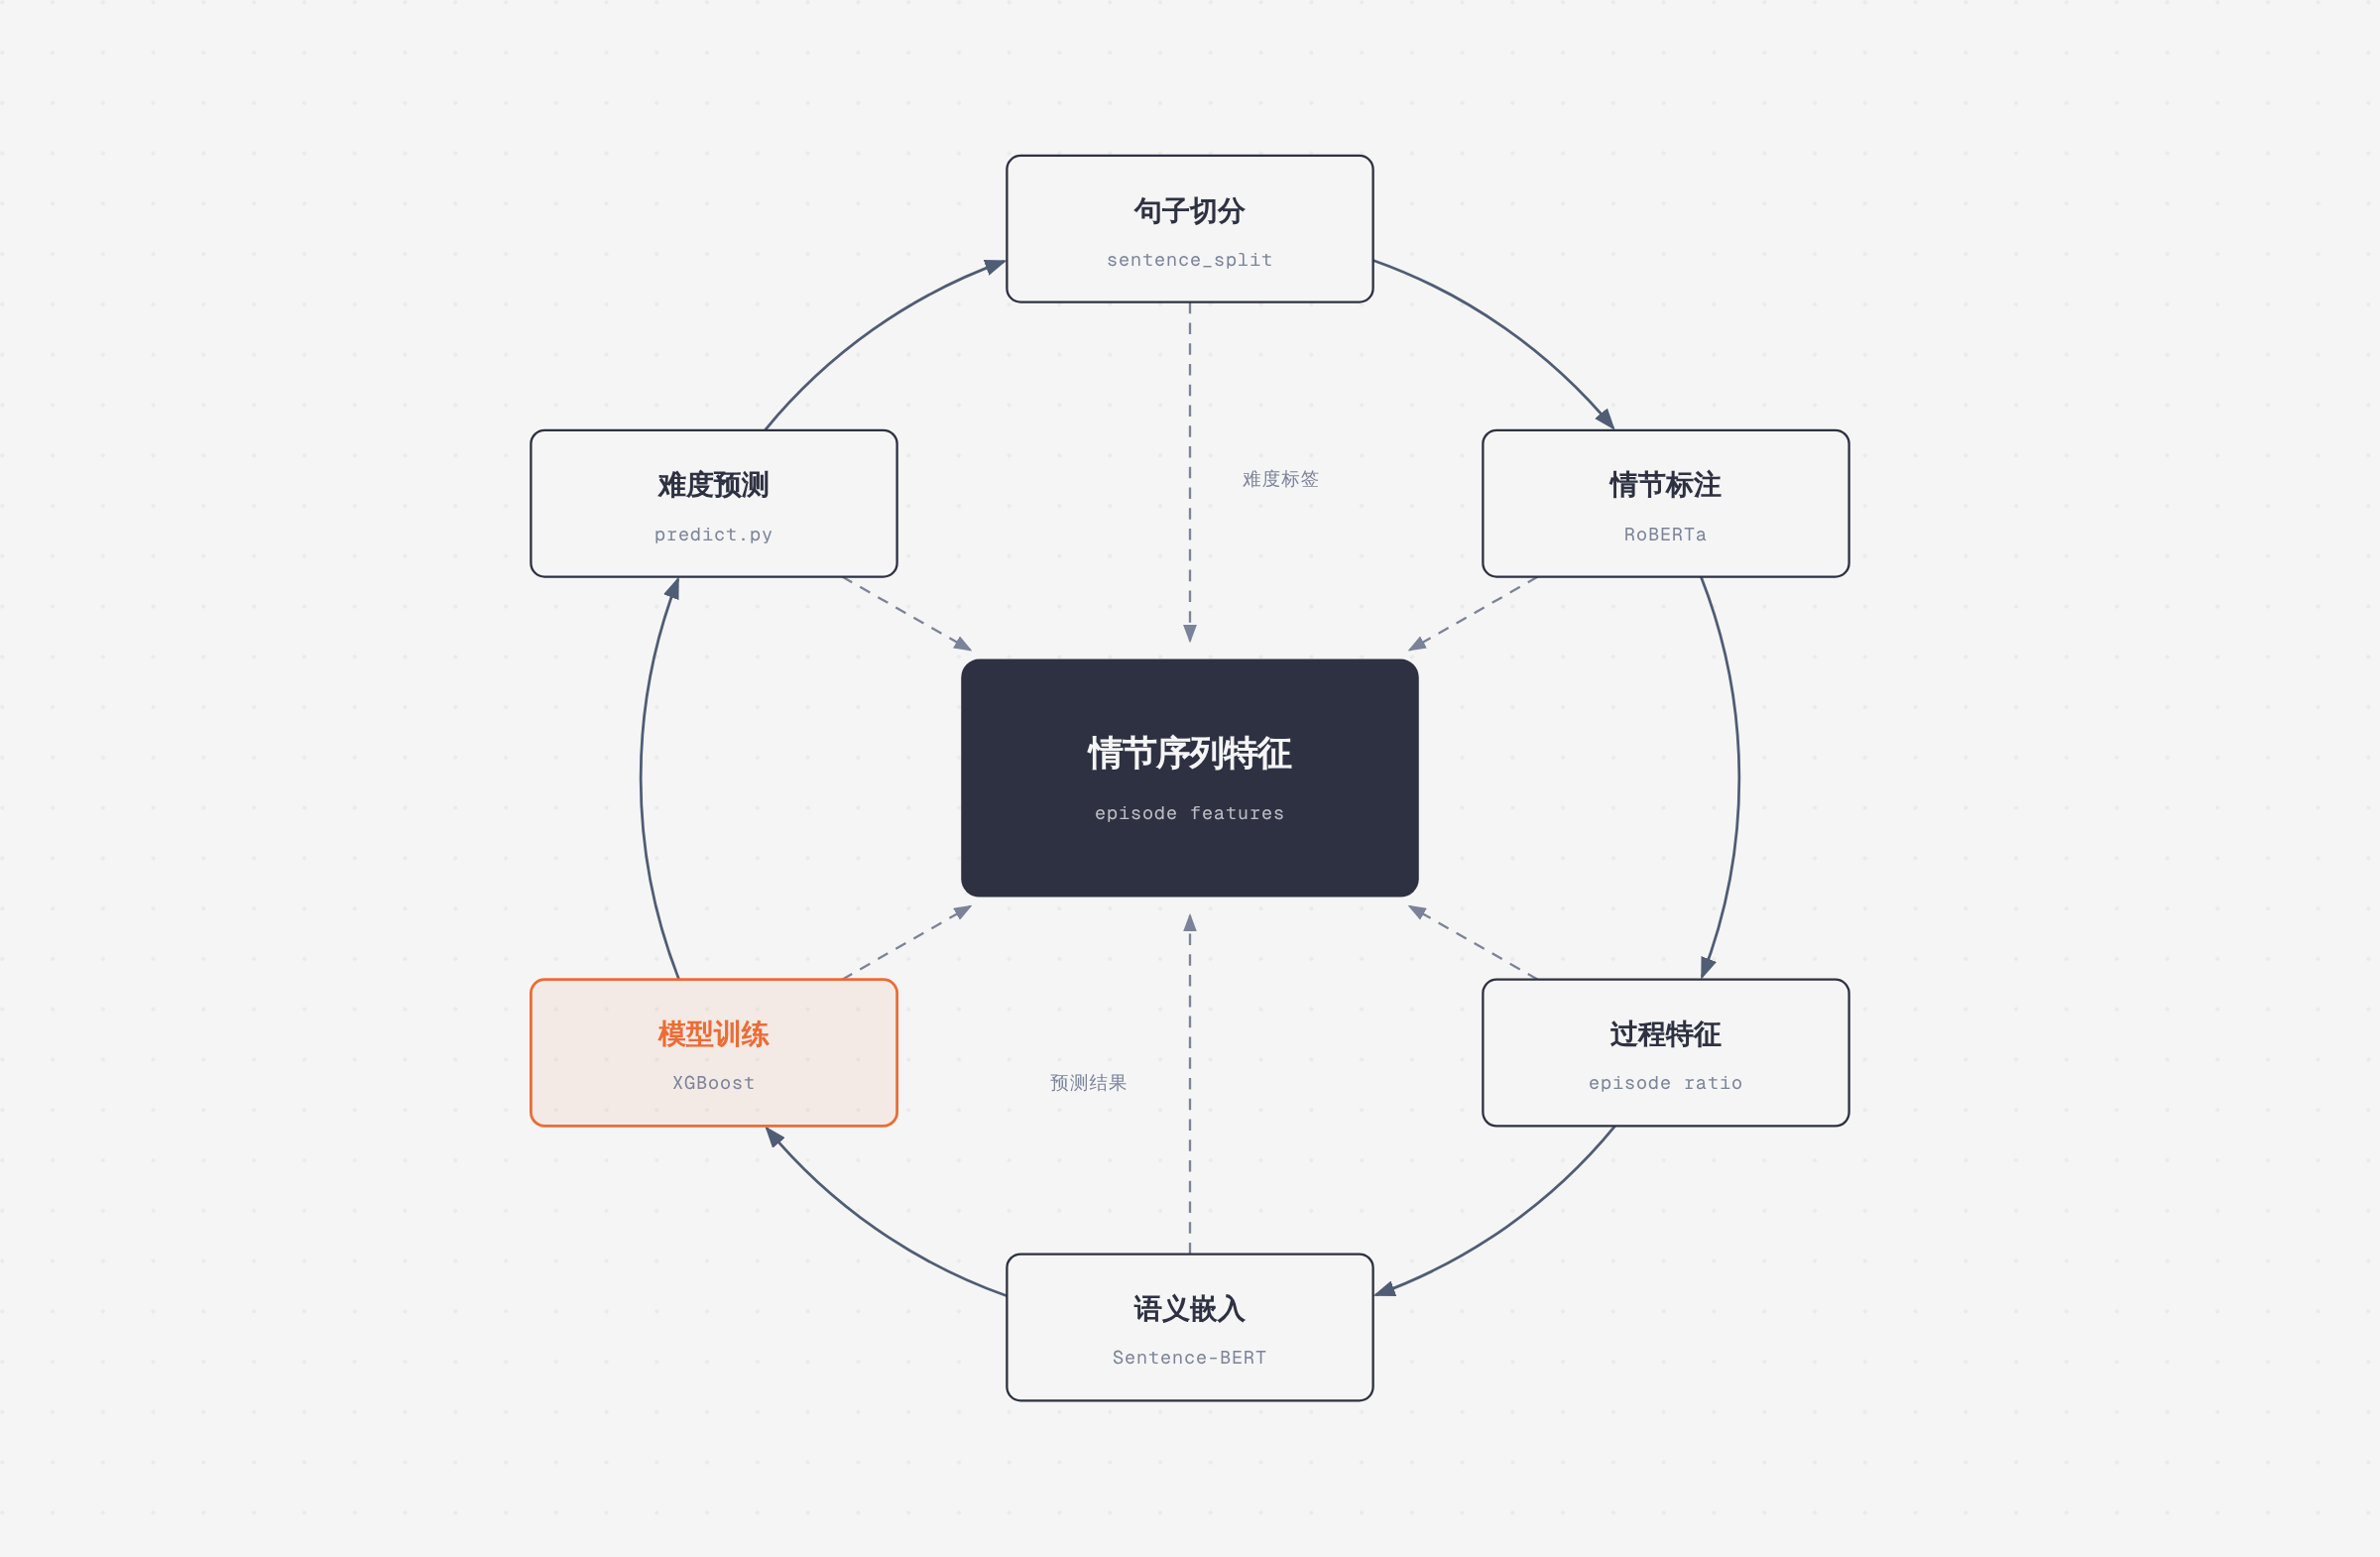
六个站点构成一条从原始轨迹到难度标签的单向流水线,中枢是“情节序列特征”——前三个站点都在为它积累素材,后三个站点在消费它。
站点一:句子切分(sentence_split)。 把 model_response 字段里的整段推理拆成句级推理单元,让后续标注在句粒度上进行。这一步决定了特征的时间分辨率。
站点二:情节标注(RoBERTa)。 逐句预测八类情节标签之一,输出 JSONL 字段包括 sentence、relative_qid、sentence_id、type、difficulty、sentence_category_pred、pred_score。pred_score 保留置信度,为后续过滤或加权留了口子。
站点三:过程特征(episode ratio)。 在句级标签序列上做三类统计:轨迹总长度(用了多少句、多少 token 才解完)、各情节的 token 分配比例(哪类认知活动吃掉最多篇幅)、情节之间的转移频次(例如 Analyze → Implement 的强度)。第三类是最有信息量的,因为它刻画的是解题节奏而非解题体量。
站点四:语义嵌入(Sentence-BERT)。 对 processed_text(题干与选项)和 answer 编码,得到与过程特征互补的“题目本身长什么样”的表征。
站点五:模型训练(XGBoost)。 两路特征在此汇合——语义向量回答“这道题在讲什么”,情节向量回答“这道题让人怎么想”。训练时创建或复用确定性 split,写指标到 outputs/*_metrics.json。多轨迹实验在此处传入多组 --tagged-file / --result-file 配对,把直接提示与角色条件轨迹聚合成更稳健的负担刻画。
站点六:难度预测(predict.py)。 默认只对测试集出预测,输出形如 {"qid": "0", "prediction": "medium"} 的 JSONL。注意它默认读取与权重同源的 split 文件,这意味着推理阶段不会意外碰到训练数据。
五、核心模块解析
| 模块 | 职责 |
|---|---|
cli.py | 统一入口,分发 tag / training / predict 三个子命令,解析文件路径、任务类型、split 与权重参数 |
sentence_split.py | 将模型响应切分为句级推理单元,为标注提供输入粒度 |
tagging.py | 加载 SteveWCG/roberta-sentence-classifier,批量(--batch-size)逐句打认知情节标签,写出句级 JSONL |
features.py | 构建过程特征:轨迹长度、情节 token 分配比例、情节转移统计,并与语义嵌入拼接 |
training.py | 生成或复用确定性数据划分,训练 XGBoost 分类器/回归器,保存权重与指标文件 |
predict.py | 加载权重与 split,仅对测试集推理并写出预测 JSONL;支持与训练一致的多轨迹输入 |
模块划分的优点是 features.py 与 training.py 之间没有隐式耦合:特征函数是纯函数式的,输入是标注文件与原始文件,输出是矩阵;训练脚本只负责划分、拟合、落盘。想换模型(比如把 XGBoost 换成 LightGBM 或线性模型)时,改动面被限制在一处。
六、特色能力
可解释性来自转移模式,而非特征重要性图。 论文报告的关键发现是:难度不由响应长度单独决定。更难的题会诱发更多中间推理、更高的 Implement 占比、更强的“分析—执行”转移。这类结论能直接翻译成教学语言——这道题难在“想清楚之后还要算很久”,而不是“题目读不懂”。相比之下,纯语义嵌入模型给出的特征重要性很难做这种归因。
跨提示条件的轨迹聚合。 仓库支持把直接提示与模拟弱/中/强学生的角色条件响应作为并列输入,聚合后得到更稳健的负担刻画。这个设计的隐含假设是:单次采样的轨迹方差较大,但“不同能力水平解题者都会在哪些环节卡住”是稳定的信号。
对照基线覆盖面较广。 论文在四类基准上与小型语言模型微调、LLM 提示、监督式 LLM 适配三类方法对比,说明作者想论证的不是“又一个更强的模型”,而是“过程特征这一路信息此前被浪费了”。
双任务模式。 同一套特征与流程同时服务序数分类与连续回归,方便不同测评场景(等级制量表 vs. IRT 式连续参数)复用。
七、工具链或生态
依赖栈非常克制,几乎全是 Python 科学计算与 NLP 的默认选择:
- Hugging Face 承担两个模型的分发与加载,
SteveWCG/roberta-sentence-classifier管情节标注,all-mpnet-base-v2管语义编码; - XGBoost 作为唯一的学习器,配
joblib做权重序列化; - JSONL 贯穿全流程——原始响应、句级标注、预测输出都是逐行 JSON,好处是可以直接
wc -l数条数、用head抽查样本,不需要额外解析层。 值得指出的是,仓库没有引入实验管理框架(如 MLflow、W&B),也没有打包成 pip 包或提供pyproject.toml。它更像一份“能跑通的论文附录”,而非面向长期维护的库。
八、部署与安全
部署路径是最朴素的 venv 三件套:
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt

# 1) 句级情节标注
python code/cli.py tag \
  --input-file data/direct/SAT_math_QwQ32B_results.jsonl \
  --output-file outputs/SAT_math_QwQ32B_results_tagged.jsonl \
  --model-name SteveWCG/roberta-sentence-classifier \
  --batch-size 16

# 2) 训练(分类模式)
python code/cli.py training \
  --raw-qwq-file data/direct/SAT_math_QwQ32B_results.jsonl \
  --tagged-file outputs/SAT_math_QwQ32B_results_tagged.jsonl \
  --result-file data/direct/SAT_math_QwQ32B_results.jsonl \
  --task-type classification \
  --output-weights models/sat_math_xgboost.joblib \
  --metrics-file outputs/sat_math_metrics.json

# 3) 仅测试集推理
python code/cli.py predict \
  --raw-qwq-file data/direct/SAT_math_QwQ32B_results.jsonl \
  --tagged-file outputs/SAT_math_QwQ32B_results_tagged.jsonl \
  --result-file data/direct/SAT_math_QwQ32B_results.jsonl \
  --task-type classification \
  --model-weights models/sat_math_xgboost.joblib \
  --output-file outputs/sat_math_predictions.jsonl
可复现性是这块的亮点:split 文件是确定性的,--split-file 指向已存在的划分即复用,省略时按模型文件名在 outputs/ 下派生默认路径。训练与推理共享同一派生规则,避免了“训练用 A 划分、推理用 B 划分”的经典事故。
安全性方面需要如实说明:仓库没有内置任何安全校验模块——没有输入 schema 校验、没有字段缺失的兜底、没有数据脱敏环节。数据分组(直接提示与弱/中/强角色条件)靠目录名区分,属于约定而非强制。另外,仓库当前未声明开源许可证,这对任何想商用的团队都是必须先澄清的前置问题。还有一处文档与实际的偏差:README 中记录的数据目录是 data/direct/、data/direct_role_weak_result/ 等,而仓库实际目录为 data/profile_direct/、data/profile_weak/、data/profile_medium/、data/profile_strong/,按 README 命令直接执行会找不到文件。
九、适用场景
教育测评的题目难度预标定是首要场景:在正式施测前,用一批模型轨迹先给出难度初值,把人工预试的范围收窄,节省被试样本。
缺少人工作答数据的冷启动估计:新题库、新学科还没有作答记录时,语义 + 过程特征至少能给出相对排序。
教学诊断分析:情节占比与转移模式可以回答“学生/模型在哪一步消耗最多”,比单一难度分数更有教学价值。
多数据集跨域实验:SAT Math、SAT Reading & Writing、Cambridge、USMLE 四类基准的覆盖,使其适合做方法论对照实验的基础设施。
反过来,不适合的场景也很清楚:需要毫秒级批量打分的线上系统(两次 Transformer 前向 + 逐句标注太重)、没有可用推理轨迹的数据源(整个方法的前提就是轨迹可得)、以及对许可证敏感的商业集成。
十、总结评价
这个项目真正的价值不在于“又一个难度预测模型”,而在于提出了一个中间表征层的设计范式:把高维、嘈杂、不可解释的推理轨迹,压缩成低维、结构化、可与教学话语对齐的情节序列。这个抽象一旦成立,特征工程变得轻量,模型可以退化成 XGBoost 而不损失太多性能,可解释性还是“免费”的——这是方法论上的漂亮之处,也是它比端到端微调更值得借鉴的地方。
适合谁:做教育数据挖掘与测评研究的研究者、想复现论文结论的学生、以及需要给题库做难度初筛又不想养一套大模型推理服务的工程团队。不适合谁:追求开箱即用 SDK 的产品开发者。
局限性必须说清楚。第一,上游依赖重——情节标注器的质量直接决定特征上限,而这个标注器本身是作者自己发布的模型,跨数据集、跨语种的泛化性没有独立验证。第二,工程成熟度有限:无许可证、README 与目录结构不一致、无 schema 校验、无测试,仓库 2 star、0 fork 的体量也说明它尚未经过社区打磨。第三,方法前提较强:必须能拿到大推理模型的完整响应,且假定“模型解题的认知节奏”与“人类解题的认知节奏”存在足够相关性——这个假设在四类基准上成立,但换到低龄段或非英语题目时需要重新验证。第四,字段约定严格(processed_text、answer、model_response、Difficulty 或 difficulty),接入自有数据前需要先做一层适配转换。
一句话:这是一份值得读方法、值得借特征设计、但不建议直接当生产依赖的研究代码。