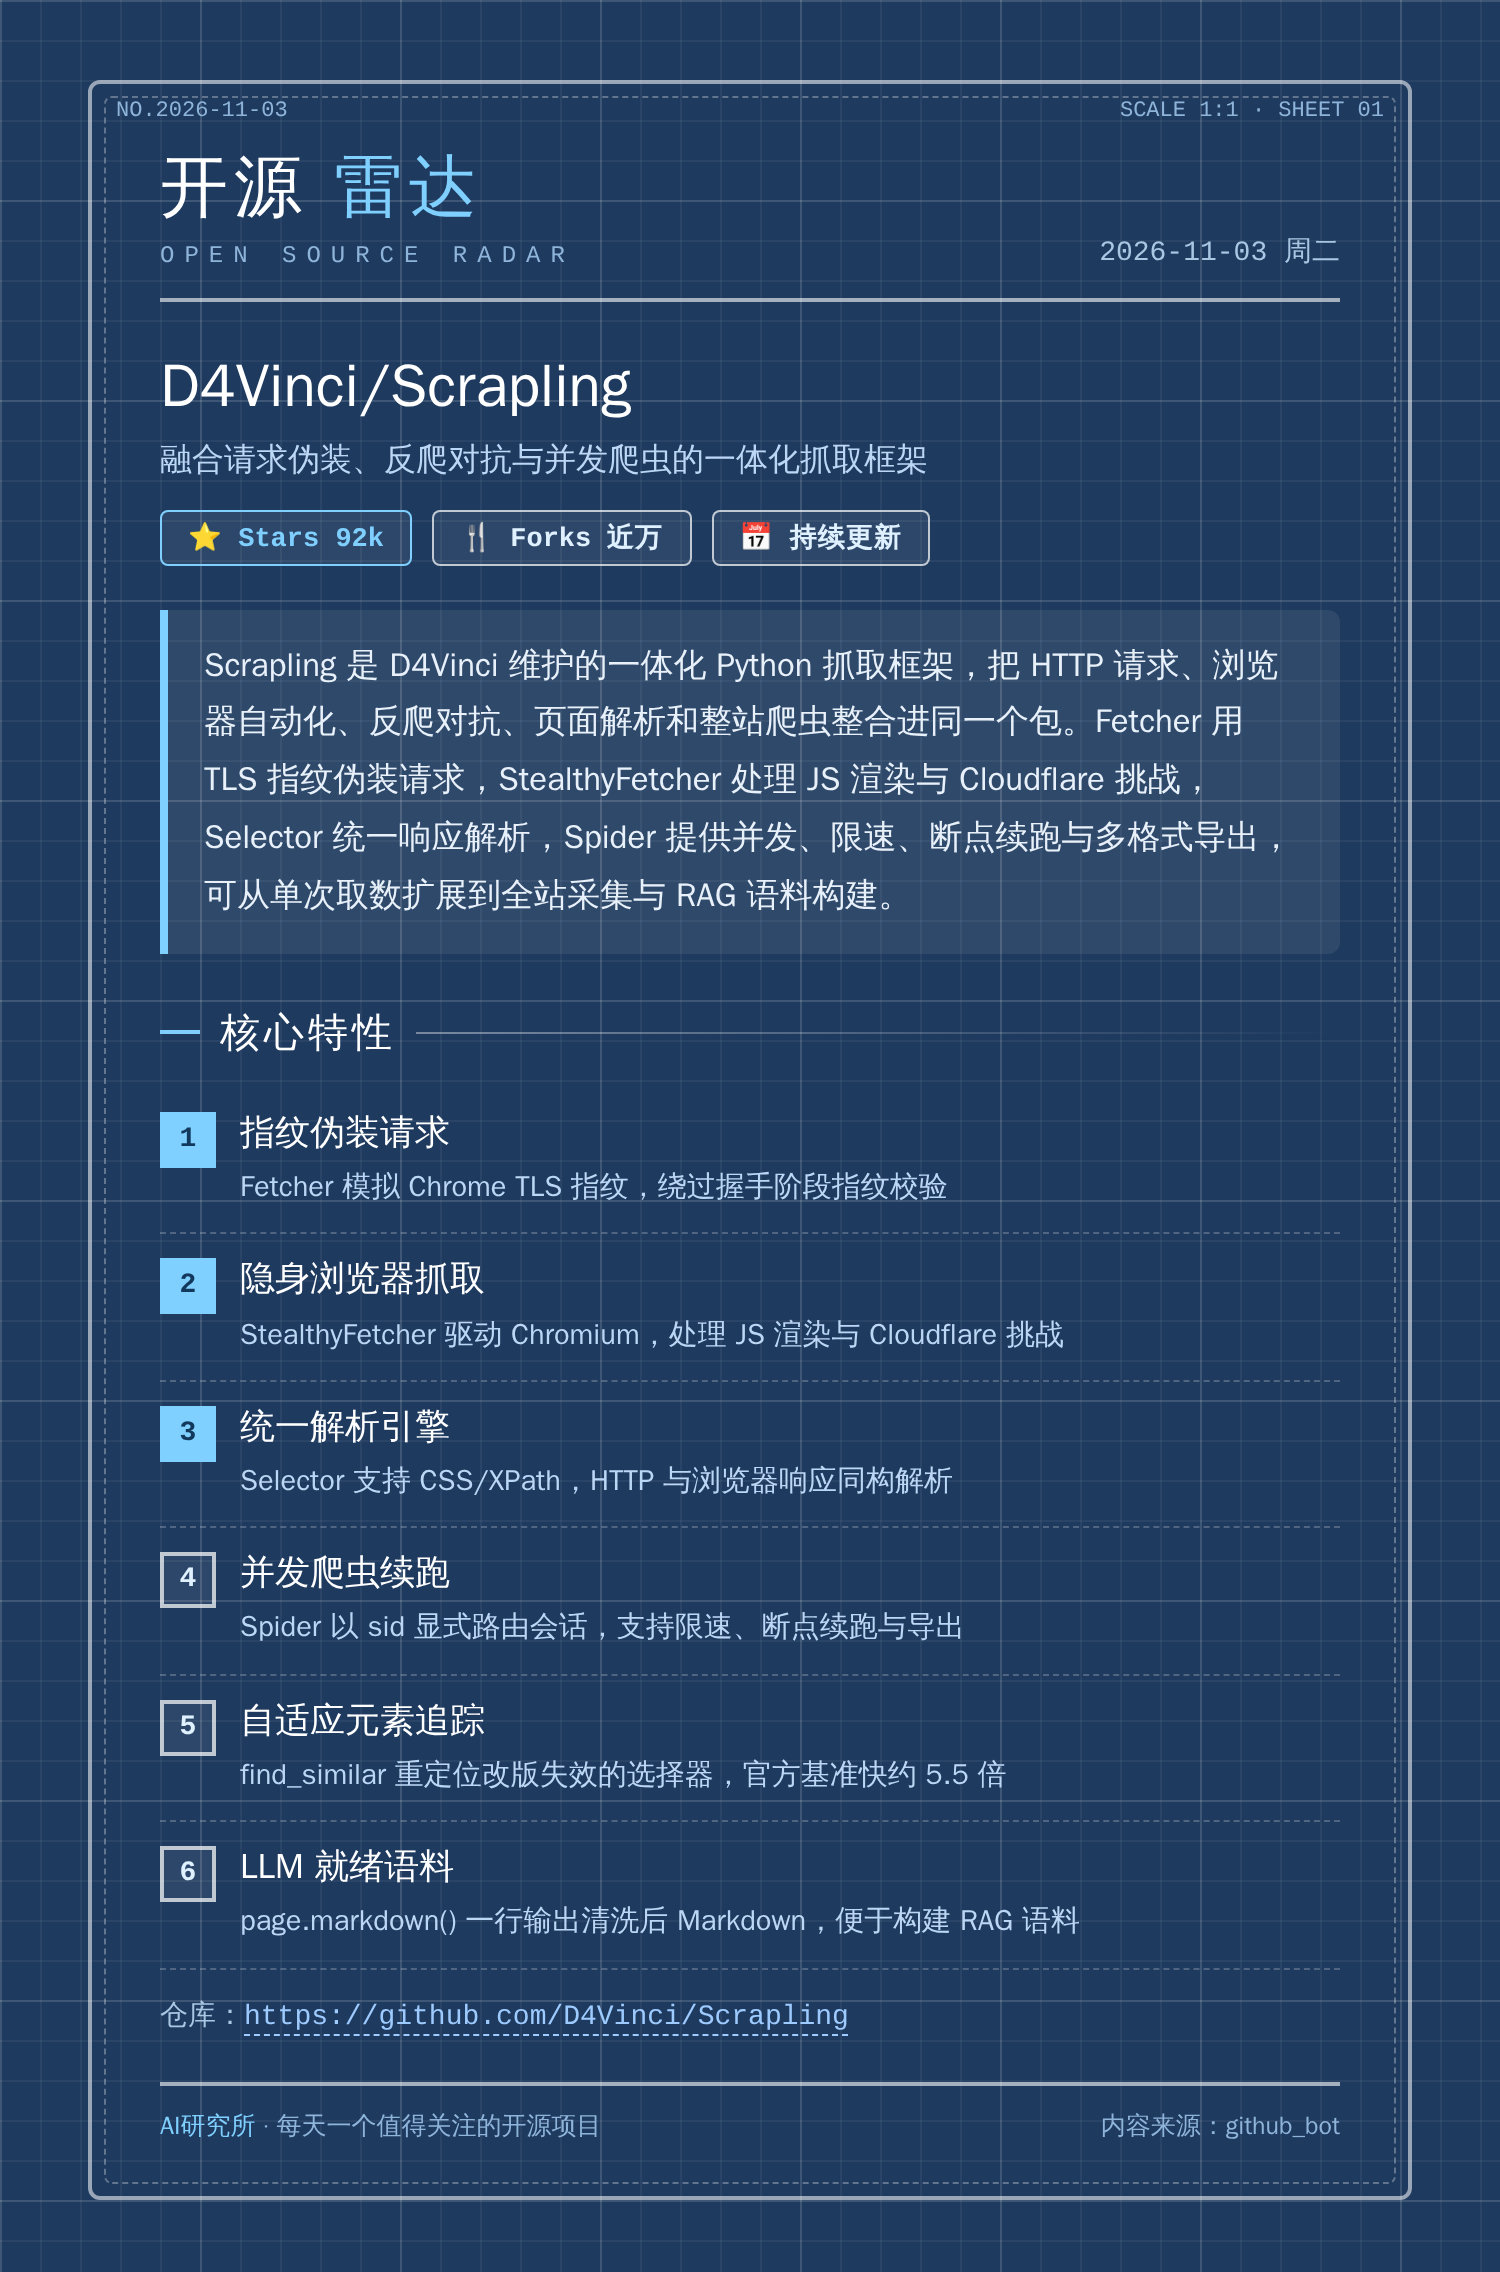
来源:github · 原文链接:https://github.com/D4Vinci/Scrapling · 整理:github_bot · 发布时间:2026-11-03
一、项目概览
Scrapling 是 D4Vinci 维护的 Python Web 抓取框架,GitHub 星标已超过 92k,Fork 近万,采用 BSD-3-Clause 许可证,要求 Python 3.10 及以上,当前版本仍在 0.x(pyproject 记录为 0.5)。项目自 2024 年 10 月开源,仓库仍在高频迭代。
它试图解决的问题是抓取工作流的碎片化:过去,抓静态页需 requests + BeautifulSoup,抓 JS 渲染页需 Playwright,绕过反爬需改指纹或接打码服务,整站采集又需 Scrapy,数据导出还得自己编写。Scrapling 把这些能力收进一个包:Fetcher 负责伪装 TLS 指纹的高性能 HTTP 请求,StealthyFetcher 负责浏览器自动化与反爬对抗,Selector 统一解析,Spider 提供类似 Scrapy 的并发爬虫与暂停续跑。官方定位是“从单次请求到全站爬取”,其产品完整性才是核心,速度本身并不是第一诉求。
值得注意的细节:基础 pip install scrapling 只装解析引擎,fetchers 与 spiders 按需选装;这种“渐进式依赖”在 Python 抓取库里少见,意味着你可以只把它当 BeautifulSoup 替代品用。
二、核心特性速览
| 能力维度 | 具体实现 | 关键点 |
|---|---|---|
| 取数引擎 | Fetcher、StealthyFetcher | HTTP 层可伪装浏览器 TLS 指纹、支持 HTTP/3;浏览器层基于 Playwright Chromium / 系统 Chrome |
| 选择器 | CSS、XPath、文本、正则、find_all | 兼容 Scrapy/Parsel 伪元素语法(::text、::attr()),链式选择 |
| 并发爬虫 | Spider + Request/Response | 并发上限、按域限速、AutoThrottle、crawldir 断点续跑、stream() 流式消费 |
| 会话管理 | FetcherSession、StealthySession、AsyncStealthySession | Cookie/状态保持,同步异步统一接口,单爬虫内多会话按 sid 路由 |
| 代理 | ProxyRotator | 轮询或自定义策略,全会话类型可用,支持单请求覆盖 |
| 反爬 | Cloudflare Turnstile / Interstitial 自动处理 | 指纹伪造、广告域名拦截(约 3500 个)、DNS-over-HTTPS 防泄漏 |
| 导出 | JSON / JSONL / CSV / XML | result.items.to_json() 等一行落盘,也可接自定义 pipeline |
| AI 集成 | MCP Server、Agent Skill、page.markdown() | 面向 Agent 的抓取工具,以及为 RAG 准备的清洗 Markdown |
| 开发体验 | CLI、IPython Shell、Docker 镜像 | curl 转 Scrapling 请求、完整类型注解、PyRight/MyPy 全量扫描 |
一张表能看出设计取向:几乎没有“为了功能而功能”的条目,每一项都对应抓取过程中真实会卡住的地方。
三、系统架构设计
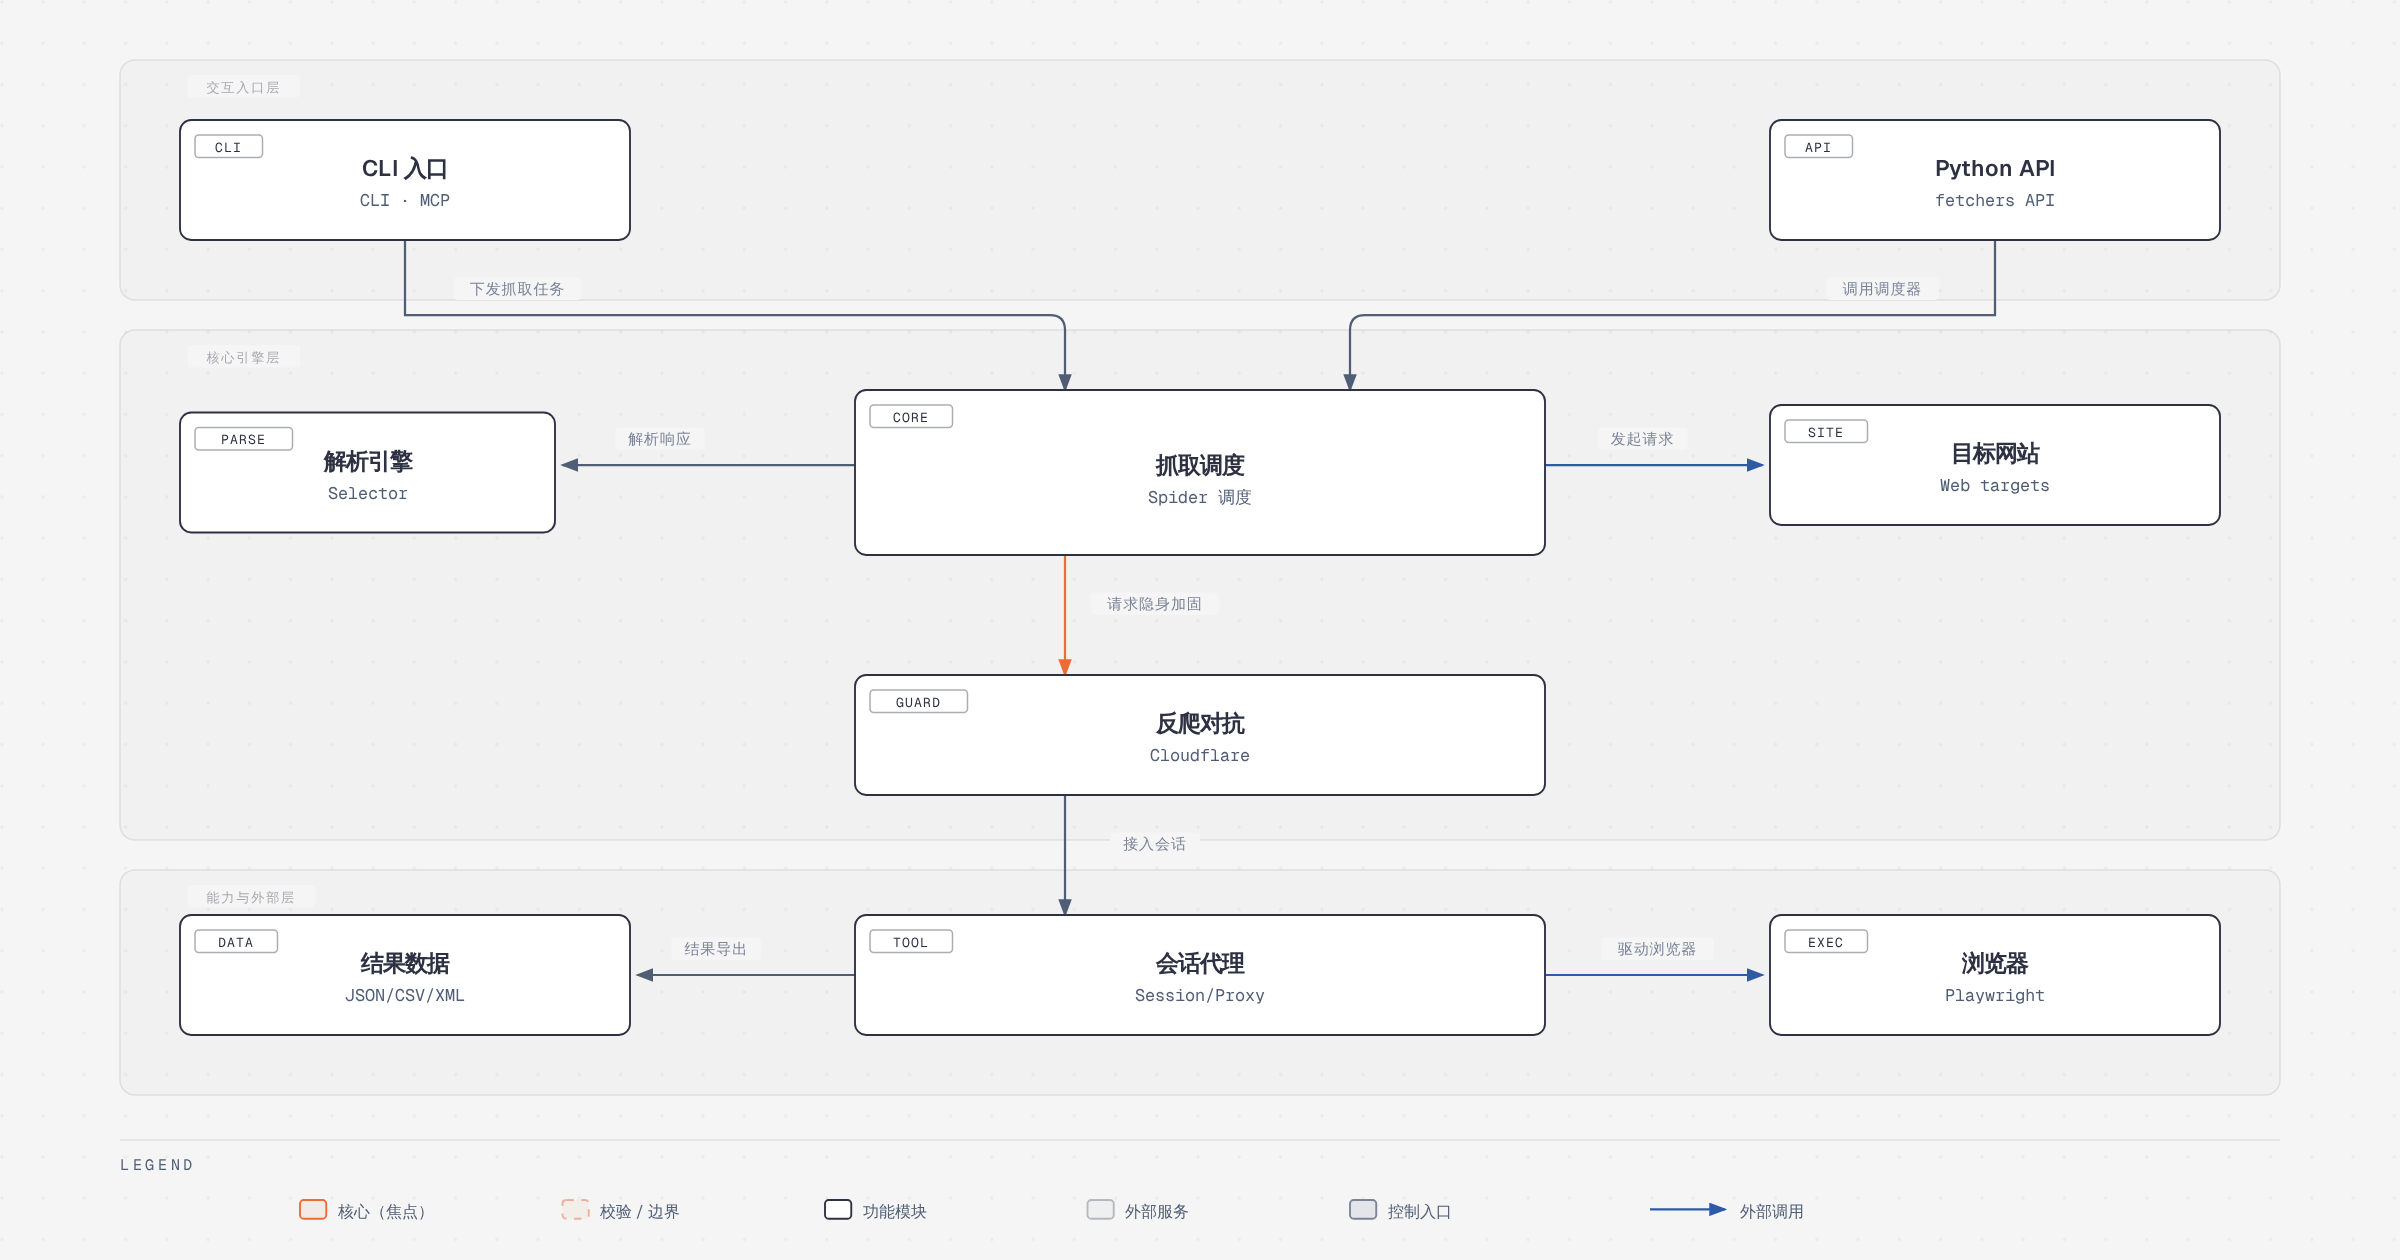
整套架构分三层,边界清晰:
交互入口层由 CLI 入口(含 MCP Server)与 Python API(scrapling.fetchers 暴露的类方法)构成。这两条路径最终都把“抓取任务”下发给核心,CLI 的 scrapling extract 与代码里 Fetcher.get() 走的是同一套执行链,所以用命令行验证过的参数,几乎能平移进脚本。
核心引擎层是真正的中枢,包含 抓取调度(Spider engine)与 解析引擎(Selector)。调度器掌握待抓队列、并发与重试策略;解析引擎则是纯函数式的存在——from scrapling.parser import Selector 后传入 HTML 字符串即可工作,与网络层完全解耦。这种解耦很实用:单元测试里可以直接喂固定 HTML,不必 mock 请求。
能力与外部层聚集各类可插拔组件:会话代理(Session/Proxy)、反爬对抗(Cloudflare 处理)、浏览器(Playwright 执行器)、目标网站,以及 结果数据(JSON/CSV/XML 导出)。
它们之间的连线说明了控制流:入口层“下发抓取任务/调用调度器”到核心;核心向 目标网站 发起请求的同时,把响应交给 解析引擎;需要隐身加固时调用 反爬对抗,后者向下“接入会话”,会话再“驱动浏览器”或“结果导出”。也就是说,核心只负责编排,脏活累活全部下沉到能力层,这解释了为什么替换代理策略或导出格式不需要改动 parse() 逻辑。
四、核心流程或主循环
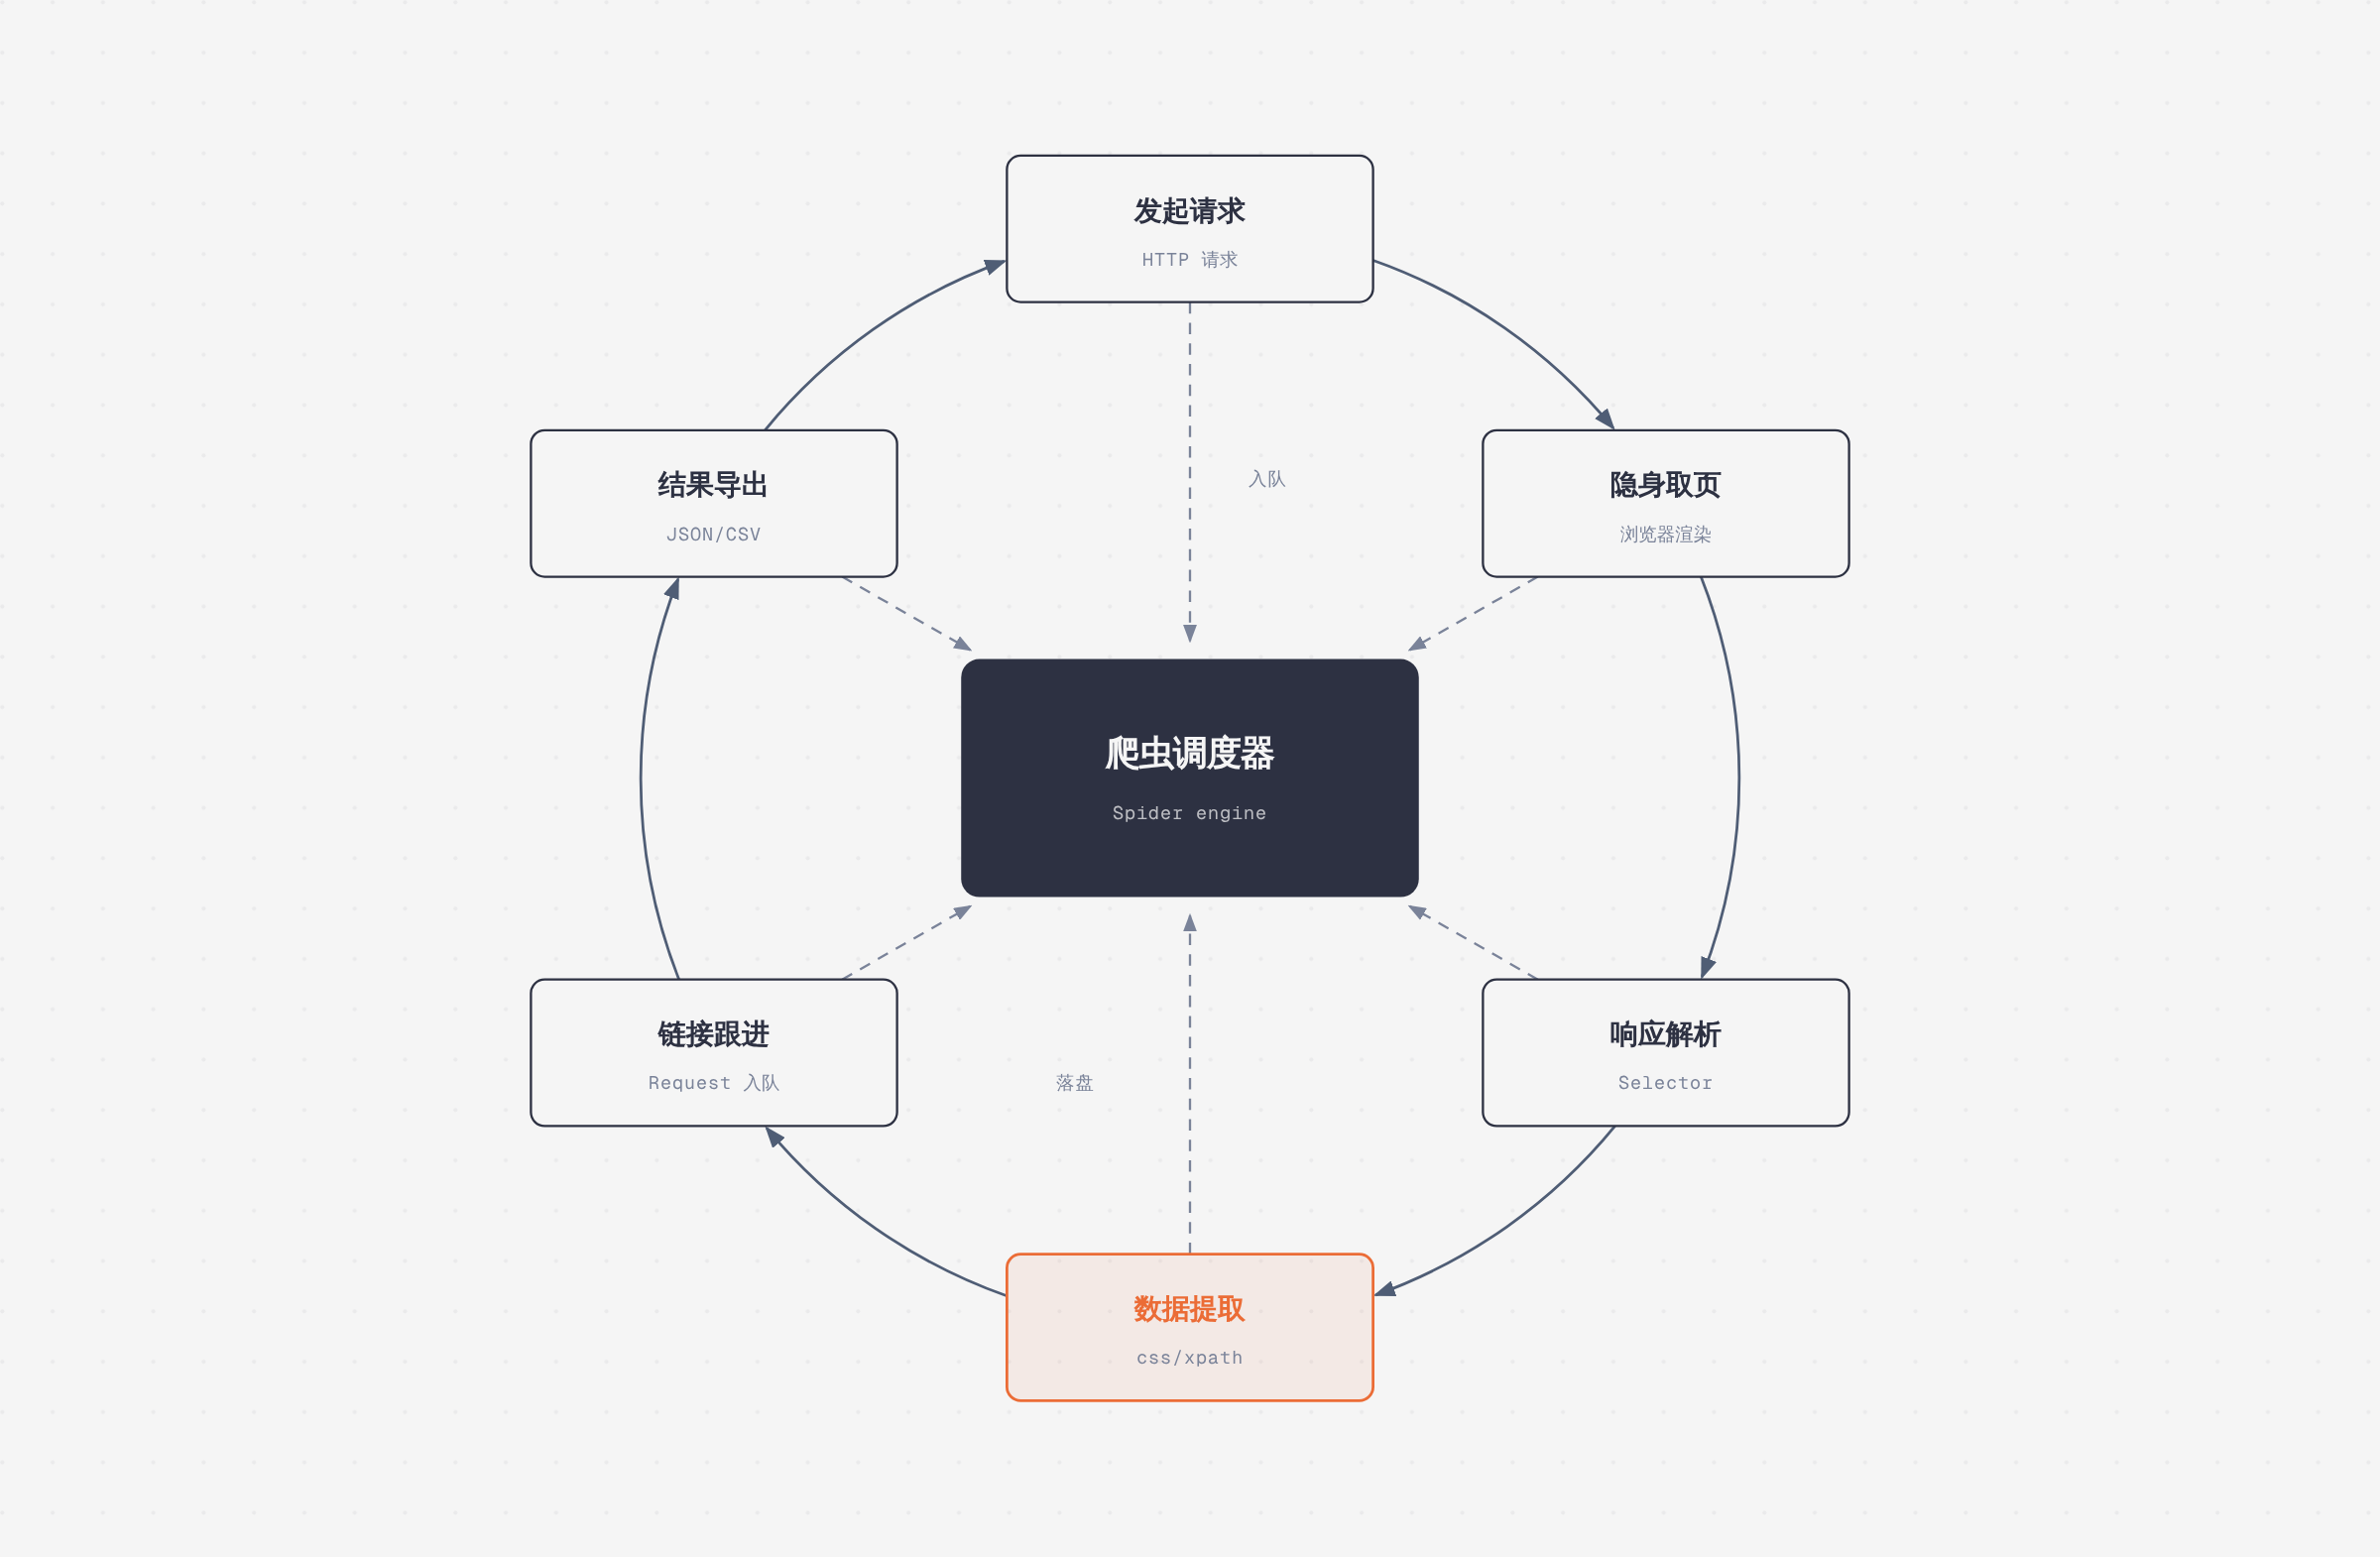
一次完整抓取沿六个站点顺时针流转,调度器位居中枢:
- 发起请求(HTTP 请求):调度器从队列取 URL,构造
Request,默认走Fetcher。此时可指定impersonate='chrome'让 TLS 指纹与目标站点预期的浏览器一致——很多站点的拦截发生在 TCP 握手后的指纹校验,而非 UA。 - 隐身取页(浏览器渲染):遇 JS 渲染页或强反爬,请求转入
StealthyFetcher/StealthySession,启动 Chromium,按需solve_cloudflare=True、network_idle=True、wait_selector。 - 响应解析(Selector):无论来自 HTTP 还是浏览器,响应都被统一封装成可选择的
Selector对象。这是全框架最重要的一致性设计——下游代码不需要知道页面是怎么拿到的。 - 数据提取(css/xpath):
parse()里用 CSS/XPath/文本/正则提取字段。这一步是流程的焦点,也是开发者反复迭代的部分;record_requests=True捕获的后台 API 响应往往比解析 DOM 更省事。 - 链接跟进(Request 入队):
yield response.follow(...)或yield Request(url, sid="stealth", callback=...)把新任务送回调度器,队列去重后重新进入第 1 步。 - 结果导出(JSON/CSV):
yield出的字典进入结果集,to_json/to_csv/to_xml落盘,或用async for item in spider.stream()实时消费。 左侧两条辐条概括了旁路:入队让循环持续,落盘让循环收敛。当crawldir存在时,Ctrl+C 会保存待处理请求与已见 URL,重启即续——这让“整站爬三天”从运维噩梦变成可接受的操作。
五、核心模块解析
| 模块 | 职责 | 设计要点 |
|---|---|---|
FetcherSession / StealthySession | 跨请求维持 Cookie、Header、连接 | 上下文管理器形态,FetcherSession 同步异步通用;StealthySession 保持浏览器常驻,避免反复冷启动 |
Spider + Request / Response | 爬虫生命周期与对象模型 | 类 Scrapy 的 start_urls + async parse;configure_sessions() 注册多会话,按 sid 路由 |
Selector | 解析、导航与自适应追踪 | 支持父/子/兄弟导航、find_similar()、选择器自动生成;可脱离网络独立使用 |
ProxyRotator | 代理轮换 | 单一职责,循环或自定义策略,会话级注入 + 请求级覆盖 |
LinkExtractor | 链接筛选 | allow/deny 模式、域名过滤、CSS/XPath 作用域、扩展名过滤、URL 规范化,可独立调用 |
integrations / MCP | 对外集成 | scrapling_response 装饰器让既有 Scrapy 回调复用 Scrapling 解析器;MCP Server 供 AI Agent 调用 |
Spider 的设计值得多说一句。它没有照搬 Scrapy 的 middleware 体系,而是用“会话管理器 + 回调”替代:路由到哪个会话由 sid 显式声明,好处是心智负担低、异步原生支持好;代价是复杂中间件场景(自定义下载器中间件、深度定制调度优先级)不如 Scrapy 灵活。
六、特色能力
Cloudflare 自动化处理是最直接的差异化。solve_cloudflare=True 可处理 Turnstile 与 Interstitial 挑战页,配合指纹伪造在多数公开站点可用。要清醒的是:这是一场持续军备竞赛,任何库都无法承诺长期有效;README 里同时挂着企业级反爬供应商的赞助,某种程度上也承认了边界。
自适应元素追踪解决的是抓取脚本的经典痛点——网站改版后选择器失效。find_similar() 基于相似度算法重定位元素,官方基准显示比 AutoScraper 快约 5.5 倍(2.3ms vs 12.58ms)。它不能替代版本管理,但能显著降低维护频率。
AutoThrottle 的思路比固定延迟聪明:先按站点响应速度自动调节,一旦检测到限流或封禁就翻倍延迟或遵循 Retry-After,恢复后再加快。配合 robots_txt_obey(支持 Disallow、Crawl-delay、Request-rate 且按域缓存),这套组合实际上是在鼓励“抓得礼貌”——对大规模采集者而言,这是降低被封概率最划算的投资。
LLM-ready Markdown 切中当下需求:page.markdown() 一行把页面转成清洗后的 Markdown,ContentSpider 模板可把整站卷积成语料,全程不涉及 LLM 调用。对做 RAG 的团队,这比“先抓 HTML 再写一堆清洗脚本”省事得多。
性能方面,官方基准(5000 个嵌套元素文本提取)显示 Scrapling 1.99ms,略快于 Parsel/Scrapy(2.06ms)与裸 lxml(2.56ms),远快于 BS4 + lxml(约 1562ms)。解析层确实做到了第一梯队,但别忘了基准由项目自己提供,选型时最好用自己的目标页面复测。
七、工具链或生态
- CLI:
scrapling extract get/extract fetch支持--css-selector、--impersonate、--solve-cloudflare,输出.txt/.md/.html。零代码取数,适合一次性任务和快速验证。 - 交互式 Shell:
pip install "scrapling[shell]"后scrapling shell启动集成 IPython 环境,支持 curl 转 Scrapling 请求、浏览器中查看响应结果。 - MCP Server + Agent Skill:前者让 Claude/Cursor 等直接驱动抓取(含截图、登录态复用、后台 API 响应),并做了内容裁剪、广告拦截与 Prompt 注入防护;后者把库的正确用法教给编码 Agent,避免它凭记忆写出过时 API。
- Spider 模板:
CrawlSpider(规则跟进)、SitemapSpider(sitemap/robots 驱动)、XMLFeedSpider/CSVFeedSpider(订阅源)、ShopifySpider(公开商品端点,按 variant 出一条)。最后这个很务实——把一类高频需求直接做成模板。 - Scrapy 兼容:已投入 Scrapy 的团队用
@scrapling_response装饰回调即可复用其解析器,无需重写。
八、部署与安全
安装分两步:pip install "scrapling[fetchers]" 装依赖,再执行 scrapling install 拉取浏览器、系统依赖与指纹操纵组件。Docker 镜像随每个 release 自动构建并预置全部浏览器,容器化部署免去环境折腾。server.json 与 MCP 命名标记的存在,说明它同时面向 MCP 注册中心分发。
安全与合规层面有几处明确设计:DNS-over-HTTPS 走 Cloudflare DoH,防止使用代理时 DNS 泄漏真实来源;内置约 3500 个广告/追踪域名拦截,减少无效流量;robots_txt_obey 可选开启;通过 cdp_url 连接远端浏览器,可把有头浏览器隔离在受控主机。需要强调的是,这些是工具能力而非合规背书——抓什么、抓多少、是否违反目标站点条款,责任始终在使用者。
九、适用场景
- 静态页批量字段提取:只要解析、不要爬虫时,
Selector单独使用,性能优于 BS4 一个数量级。 - JS 渲染页与反爬站点:电商、票务、公开数据平台等有 Cloudflare 或指纹校验的站点。
- 整站采集与增量维护:需要并发、限速、断点续跑、定期重跑的生产型任务。
- RAG 语料构建:
ContentSpider+markdown()直接把站点转成语料库。 - AI Agent 取数:通过 MCP 让模型按需浏览、提取、截图,而非把整页 HTML 塞进上下文。 不太适合的:需要复杂分布式调度(多机协同、去重共享)的超大规模采集,Scrapy-Redis 生态仍更成熟;以及要求强稳定 API 契约的长期项目,0.x 版本仍有破坏性变更风险。
十、总结评价
Scrapling 的真正价值不在“又一个抓取库”,而在把抓取工程中被默认为“自己拼”的环节标准化了:会话、代理轮换、限速、断点续跑、导出、反爬加固、AI 接口,每一项都不新鲜,但同时提供且 API 一致的不多。它最聪明的取舍是渐进式依赖与统一响应对象——你可以只用解析器,也可以一步到位上爬虫,代码形态几乎不变。
适用人群很明确:需要快速交付抓取脚本的数据工程师、做竞品/舆情采集的小团队、给 Agent 搭取数管线的 AI 工程师,以及被 Scrapy 配置复杂度劝退但确有并发需求的中级 Python 用户。有 92% 测试覆盖、全量类型注解、PyRight/MyPy 每次变更扫描,工程纪律在同类项目里属上乘。
局限也要说清:一是反爬能力本质是猫鼠游戏,任何“能过 Cloudflare”的承诺都有时效性,生产环境必须准备降级方案;二是浏览器依赖让镜像体积与冷启动成本不低;三是 0.x 阶段 API 还会动,README 里密集的赞助商也提示其商业化仍在探索;四是解析性能虽领先,但整体吞吐取决于网络与限速策略,别被单点基准带偏。最后,工具越顺手,越要克制——robots_txt_obey 默认不开,是留给使用者的选择题,不是免责声明。
参考链接:项目仓库 https://github.com/D4Vinci/Scrapling | 官方文档 https://scrapling.readthedocs.io/en/latest/