来源:github · 原文链接:https://github.com/JustVugg/colibri · 整理:github_bot · 发布时间:2026-11-04
一、项目概览
colibri 是一个用纯 C 写的 MoE(专家混合)推理引擎,目标只有一句话:让拥有数千亿参数的开放模型在你现有的机器上跑起来。截至快照时间,仓库已积累 4.7 万星标、5400 余 fork,采用 Apache-2.0,从首次提交到最近一次推送只隔了四个月,迭代密度相当高。
它成立的前提是一个被反复验证的观察:MoE 模型的参数量分布极不均匀。GLM-5.2 有 744B 参数,每个 token 实际只经过约 40B,而其中真正随 token 变化、必须在不同时刻被读入的部分只有约 11 GB,也就是被路由器选中的那些专家。稠密部分(注意力、共享专家、嵌入)是固定的,可以常驻;路由专家是稀疏的,可以缓存,缓存不下的就从磁盘流式读。
于是 colibri 把“模型是否装得进内存”这个原本的二值问题,拆成了三级放置问题。它不依赖 BLAS,运行时不依赖 Python,每个模型家族对应 c/ 下的一个 C 文件。目前有 13 个引擎在运行:10 个语言模型引擎(GLM-5.2/5.3、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash 与 V4.1 Flash、MiMo-V2.6 Flash 与 Pro、Qwen3.8-Flash-Next、Qwen3.6、OLMoE),1 个文生图引擎(Qwen-Image-2.1),2 个决策模型(Laya、GLiNER2.5-Decide),另有 Clef 复用 Qwen3.6 引擎。语言模型引擎还能直接读取已发布的 GGUF 文件,不做二次量化。
二、核心特性速览
| 特性 | 实现要点 | 实际效果 |
|---|---|---|
| 专家分层放置 | 热专家驻显存、温专家驻主机内存、冷专家从 NVMe 流式读取 | 744B 模型在 25 GB 笔记本上也能跑出正确结果 |
| 路由热度学习 | 逐层 LRU 缓存 + .coli_usage 固定热门集合,每轮更新 | 同一段工作负载会越用越快 |
| 多后端 | CPU、Vulkan 1.2、CUDA、Metal、XDNA | 从核显到多卡机架同一套引擎 |
| GGUF 直读 | coli import 写出模型目录,块按文件原样运行 | 覆盖 IQ1_S 至 Q8_0、F16、BF16、MXFP4 |
| 统一 API 网关 | OpenAI、Anthropic 兼容端点 + /v1/systemone | Claude Code、各类 SDK 可直接接入 |
| 精度守护 | CI 用微型 fixture 对照参考实现 | 放置策略不会静默改变路由与精度 |
三、系统架构设计
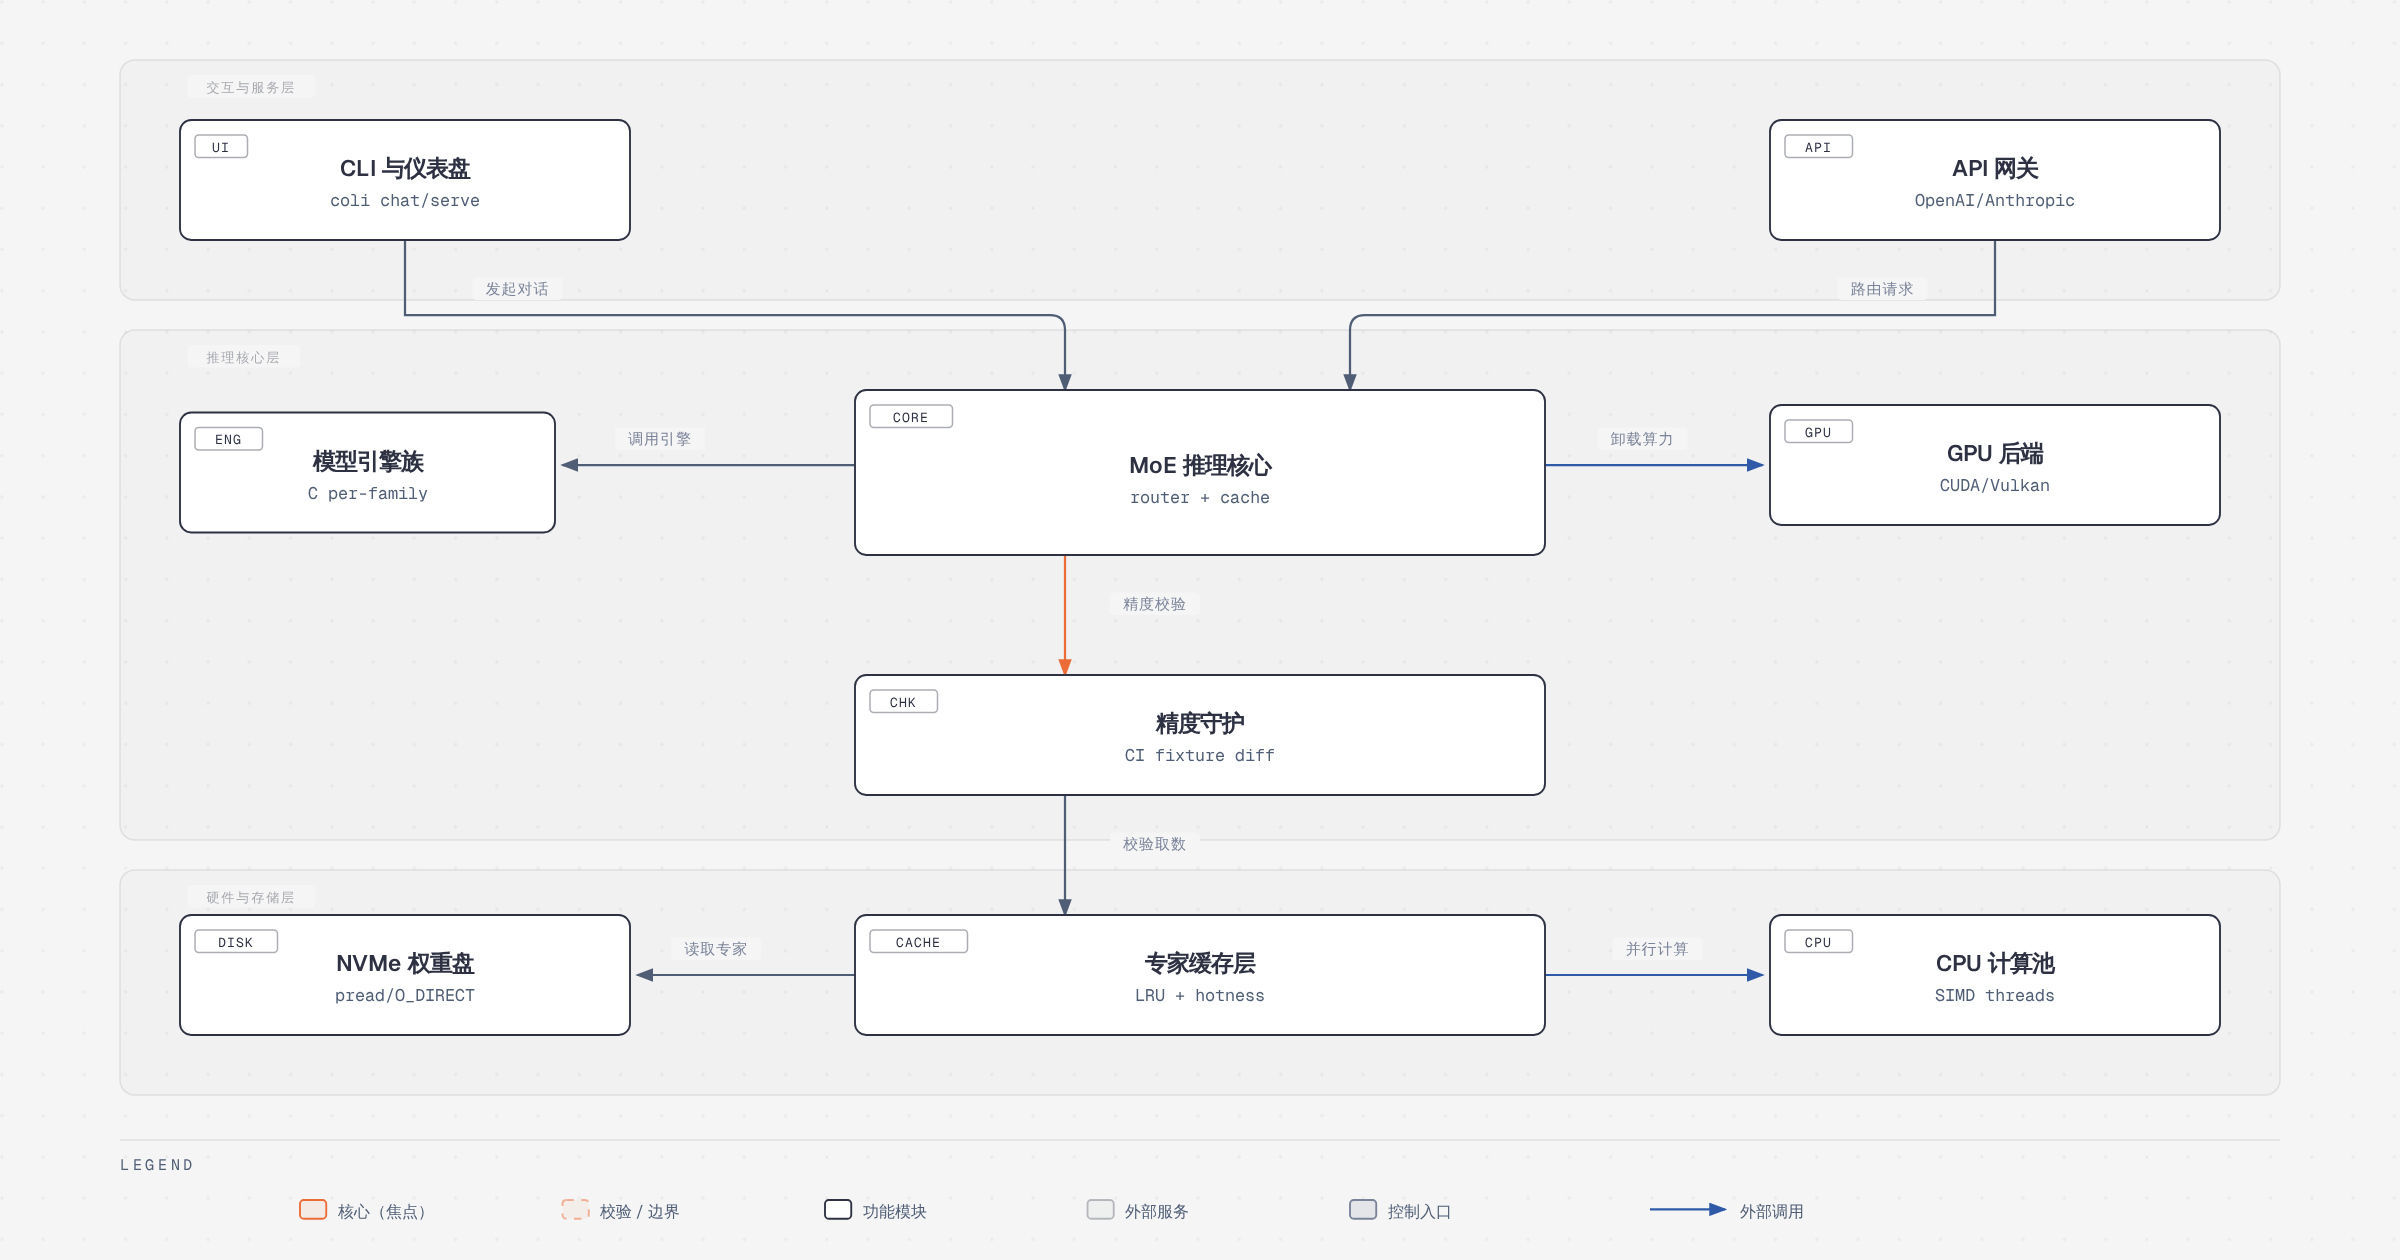
架构可以按三段来读。交互与服务层由「CLI 与仪表盘」和「API 网关」两个节点构成,前者是 coli chat / coli web / coli ui,后者是 coli serve 暴露的 OpenAI、Anthropic 与 System One 端点。两者都只做一件事:把一次对话或一次决策请求翻译成推理核心能消费的 token 与参数结构,然后路由给核心。
推理核心层是重心所在。请求进入「MoE 推理核心」,由它完成路由计算与专家调度;核心按模型家族调用对应的「模型引擎族」,也就是 c/ 下那批一模型一文件的 C 实现。在这条链上还有一个不太显眼但很关键的节点:「精度守护」,它对应 CI 里那批 *_tiny 微型 fixture,把引擎输出与模型参考实现逐 token 对齐,保证缓存层拿到的数据、GPU 算出的激活值与 CPU 路径语义一致。再往下是「专家缓存层」,它把 LRU 与热度统计合在一起,向上回答“这一步缺哪些专家”,向下决定这次 pread 从哪块盘读、要不要走 O_DIRECT。
硬件与存储层是三个执行端:GPU 后端(CUDA / Vulkan / Metal / XDNA)承接显存中的专家层级与稠密链;CPU 计算池用 SIMD 多线程算缓存命中的专家;NVMe 权重盘负责供给所有未命中项。三者的关系不是主备,而是同一帧内的并行:GPU 算它持有的,CPU 同时算其余的,磁盘读取与两者重叠。
这套分层最有价值的地方在于一条硬约束——放置只改变回答出来的速度,不改变由哪些权重、哪些路由决策产生这个回答。显存、内存、磁盘只是同一份权重在不同介质上的副本,引擎不会因为放不下就悄悄降低精度或改写路由。这也是它能被当作研究平台使用的前提。
四、核心流程或主循环
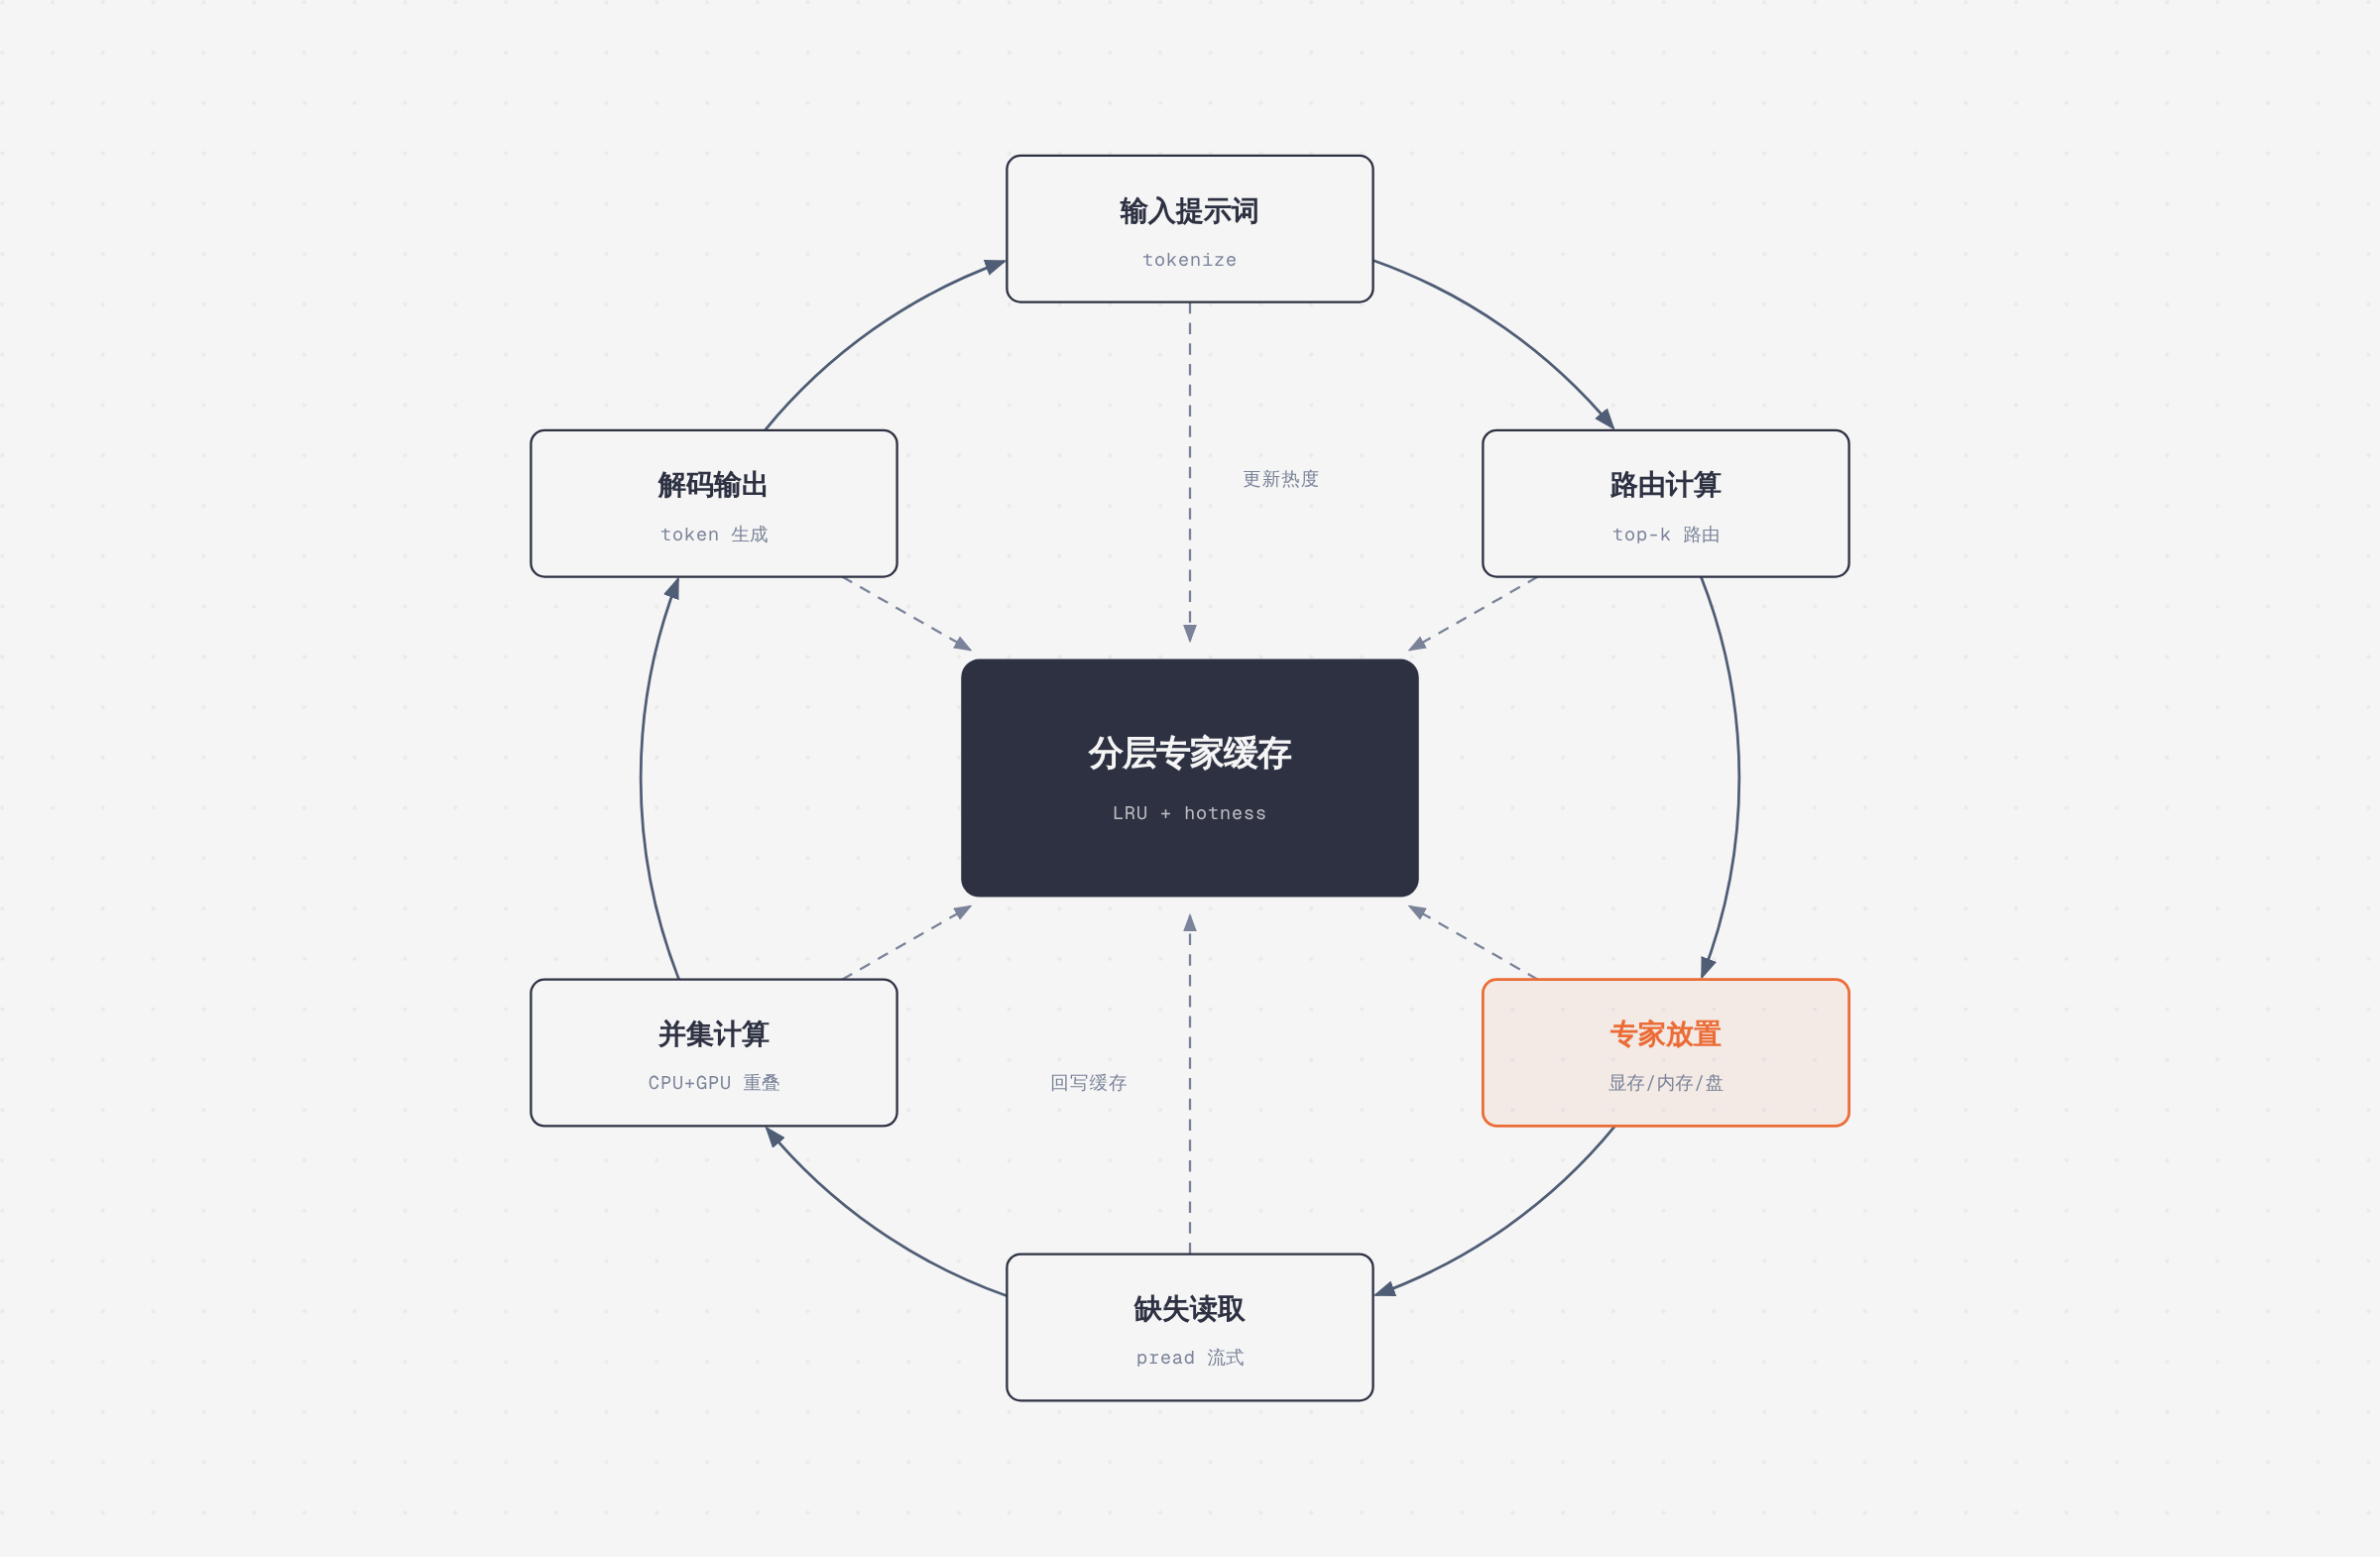
每 token 每层走同一条流水线,六个站点依次是:
输入提示词:文本被 tokenize 成序列,长提示词按段规划内存,K/V 可以选择 float16 存放在显卡上——Qwen3.8-Flash-Next 在 262,144 token 上下文下,提示词读取从 15.6 tok/s 提升到 149 tok/s。
路由计算:路由器给出该层 top-k 专家,这一步是所有后续动作的输入,也是唯一不能并行化的串行依赖。colibri 在这里加了一条前瞻线程,把下一层的路由提前算出来,GLM-5.2 的路由提前一层时有 71.6% 可预测,预取命中就能把磁盘延迟藏进计算里。
专家放置(图中的焦点站):核心查分层专家缓存,判断每个被选中的专家当前落在显存、内存还是磁盘。这一步决定了本轮是纯计算还是带 I/O。
缺失读取:未命中的专家由一组加载线程发起读取,一个专家的三个矩阵用一次 pread 读出,避免三次寻道。一批位置对同一个专家只读一次。DIRECT=1 打开 O_DIRECT 绕过页缓存,在快速 NVMe 上常有明显收益,在慢盘上则可能持平甚至更差,官方建议实测。
并集计算:命中的专家交给 CPU 计算池或 GPU 后端,缺失的专家在读取完成后并入同一轮。GPU 持有一部分、CPU 算另一部分,两者的结果在同一帧内合并,这也是为什么比显存大的模型不会直接掉到龟速——Qwen3.8-Flash-Next IQ2_XS(68 GB)在 24 GB 显卡上仍有 50.6 tok/s 解码。
解码输出:采样出下一个 token,同时把本轮的专家命中情况回写给缓存层,更新 LRU 位置与 .coli_usage 里的热度统计。下一轮开始时,缓存已经比上一轮更懂你的工作负载。
五、核心模块解析
| 模块 | 职责 |
|---|---|
c/colibri.c | GLM-5.2 家族引擎,也是最早成形的参考实现,含 MLA 注意力与 MTP head |
c/backend_vulkan.c + c/shaders/ | Vulkan 专家层级与稠密链,覆盖 AMD/Intel/NVIDIA 及核显 |
c/backend_cuda.cu、backend_cuda_dsv4.cu、backend_cuda_ink.cu | CUDA 路径,按模型家族拆分,含 GGUF 块类型与 Tensor Core 提示词路径 |
c/backend_metal.mm | Apple Silicon 统一内存上的专家运算 |
c/backend_xdna.c + backend_xdna_helper.cpp | AMD XDNA NPU 后端 |
c/backend_loader.c | 权重加载、分片与放置决策 |
c/tools/、c/train/、c/autotune.py | 格式转换、微调与参数自调优 |
colibri/cli.py 与 coli | 安装、启动、状态、日志的入口脚本 |
ui/、web/、desktop/ | 新聊天界面、Web 仪表盘与 Tauri 桌面端 |
c/*_tiny/ | CI 精度对照用的微型 fixture 权重 |
六、特色能力
System One 是这批特性里最不像“推理引擎”的一个。POST /v1/systemone 接收一段状态(文本或 JSON)和若干带类型的问题,返回每个允许选项的概率与一个 0 到 1 的置信度,全程不生成任何文本。答案因此不可能落在给定列表之外,“模型没把握”也变成了一个可以设阈值的数字。choice、noul、score 三种题型覆盖了绝大多数“让它做个选择”的场景。请求与回复格式与 TypeSafe 的 Jev API 一致,Jev 客户端只改 base URL 就能切过来。
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
  "state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
  "questions": {
    "review": {"type": "choice", "instructions": "What should the reviewer do?",
               "criteria": {"merge": null, "request changes": null, "close": null}},
    "risky":  {"type": "noul", "instructions": "Is this change risky?"}}}'
推测解码按收益开关,不搞一刀切。Qwen3.8-Flash-Next 的 MTP head 默认开启,输出不变的情况下提速 16–20%;GLM-5.2 的 int8 MTP head 每次前向起草 2.2–2.8 个 token;Qwen3.6 的 head 在 RTX PRO 4000 上把 CUDA 解码从 99.7–104.5 提到 115.8–120.1 tok/s。而在起草成本高于节省的 DeepSeek V4 上,它保持关闭。
多轮智能体优化:两轮之间的短请求(比如智能体询问会话标题)会把会话暂存而不是占用状态,Qwen3.8-Flash-Next 上 Hermes Agent 的第二轮 14,810 token 从 86 秒降到 4.9 秒。--kv-slots N 最多保留 16 个隔离 KV 上下文并把下一个 token 一起解码。
仪表盘会显示专家地图——每个区块每个专家一格,本步选中的为白色、本次回答用到的为琥珀色。这在别的引擎里几乎见不到,但它是理解“为什么这个模型今天慢了”的最直接工具。
七、工具链或生态
一步安装是它对普通用户最友好的设计。start-here.sh / START-HERE.bat 会检查内存、磁盘、CPU 与 GPU,推荐一个能装下的模型,然后在有编译器时为你编译、没有时下载预编译版,最后启动服务并打开仪表盘。
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh --list
./start-here.sh --model qwen36-35b --yes
--list 会告诉你每个模型为什么装不下,--dir 换一块盘,--backend vulkan|cuda|cpu 自选引擎构建,--reconfigure 换模型。CI 之外还有 coli import 处理 GGUF、coli mcp 提供 MCP 工具集、docs/AI_SETUP.md 让 AI 助手按固定步骤代装、Docker 与 Nix flake 两种可复现环境、Tauri 桌面端和一套独立的 Web UI。
八、部署与安全
“忠实”在这个项目里是可以被测量的事实,而不是口号。每个引擎在 CI 里用微型 fixture 与参考实现对照;默认策略绝不静默改变模型精度或路由语义。GLM-5.2 的 MLA 注意力只保存压缩后的 KV 状态,每个 token 576 个浮点数而不是 32,768 个,缩小 57 倍,并且重启后仍然保留,重开对话不必再读提示词。
性能侧的可选项都是显式的:COLI_MODEL_MIRROR 让两块独立控制器上的 NVMe 同时供数,实测解码 +37.5%;COLI_NUMA=1 把常驻权重铺到多路主机的内存控制器;集群模式可以把路由专家放到其他机器上。没有设置 COLI_API_KEY 启动的服务器会接受客户端已经在发的密钥,方便本地对接,部署到共享环境时则需要自己补上鉴权。
九、适用场景
它最合适的场景是高速 NVMe 主机流式跑超大模型。同一台 i5-13500 + 62 GB + RTX PRO 4000(24 GB)的机器上,DeepSeek V4 Flash 的 GGUF 版本能到 6 秒级解码,GLM-5.3-Flash 在 95 GB GGUF 下 2.9–3.4 tok/s,Kimi K3 的 594 GB 版本则是 0.349 tok/s、每 token 约 9.4 秒——慢,但它确实在跑。
第二个场景是普通笔记本跑千亿级模型。8 GB 内存是下限,16 GB 以上更舒服,GLM-5.2 在 25 GB 笔记本上冷启动 0.05–0.1 tok/s,这是官方主动标注的诚实下限。
第三个场景是小额加速。核显 Radeon 780M 上 Qwen3.6-35B-A3B 从 CPU 的 6.0 tok/s 提到 Vulkan 加稠密链的 9.9 tok/s,512 token 提示词从 35.7 秒降到 9.5 秒。但小模型如 OLMoE 反而从 23.1 掉到 12.8,因为专家本来就在内存里,走一趟 GPU 只是多了一次搬运,所以安装程序只为特定几个模型在核显上开 Vulkan。
第四个场景是研究平台。所有数字都附机器配置与实验记录,优化必须靠可复现的端到端测量才能被采纳,c/abl.h、c/profiles/、c/autotune.py 都在明示这一点。
十、总结评价
colibri 的真正价值不在于“让 744B 模型跑在笔记本上”这个标题,而在于它把一件工程上极易含糊的事情做成了可验证的契约:权重放在哪里只影响速度。这条约束一旦被认真对待,整个系统就必须为每一种放置组合维护相同的数值语义,CI 里的 fixture 对照、重启后保留的压缩 KV、GPU 与 CPU 分头计算后在同一帧合并,都是这条约束的副产品。相比之下,很多同类项目在显存放不下时就开始悄悄降精度、改路由,用户拿到的是一个“差不多”的模型。
它的取舍也足够克制。不追求把每个 token 都做快,而是诚实地告诉你磁盘带宽就是大型模型的天花板:Kimi K3 的专家读取速度 6.3 GB/s 直接决定了每 token 9.4 秒。不追求全平台一致的最优,而是让每个引擎自己决定核显上要不要跑稠密链,并在文档里写明 OLMoE 这类小模型走 GPU 反而更慢。这种“给出数字、说明条件、允许你反对”的写法,在动辄宣称几倍加速的推理赛道里很少见。
适用人群:手里有 16–64 GB 内存、一块像样 NVMe、想在自己机器上跑前沿开放 MoE 的开发者;需要把长上下文智能体接到本地模型上的工程团队;以及想测量、想改进、需要可复现基线的系统研究者。
局限也要说清楚。第一,大型模型的实际性能上限是磁盘,换引擎不换盘,收益有限。第二,Mac 上一步安装脚本编译的是 CPU 版本,Metal 需要自己从源码开 METAL=1,体验不如 Linux。第三,无 Resizable BAR 的显卡路径虽然实现了暂存缓冲区,但官方明确写了尚未在真正的无 BAR 硬件上实测。第四,GPU 与 CPU 的加法顺序不同,长回答可能与 CPU 路径差一个词。第五,System One 的校准来自模型作者拟合,换成通用聊天模型打分时,置信度的语义会打折扣。
这些不掩盖它的分量:在一个普遍靠堆显存解决问题的领域,它选了另一条更笨、更慢、但能让更多人真正用上的路,并且把这条路上的每一块路标都量了出来。