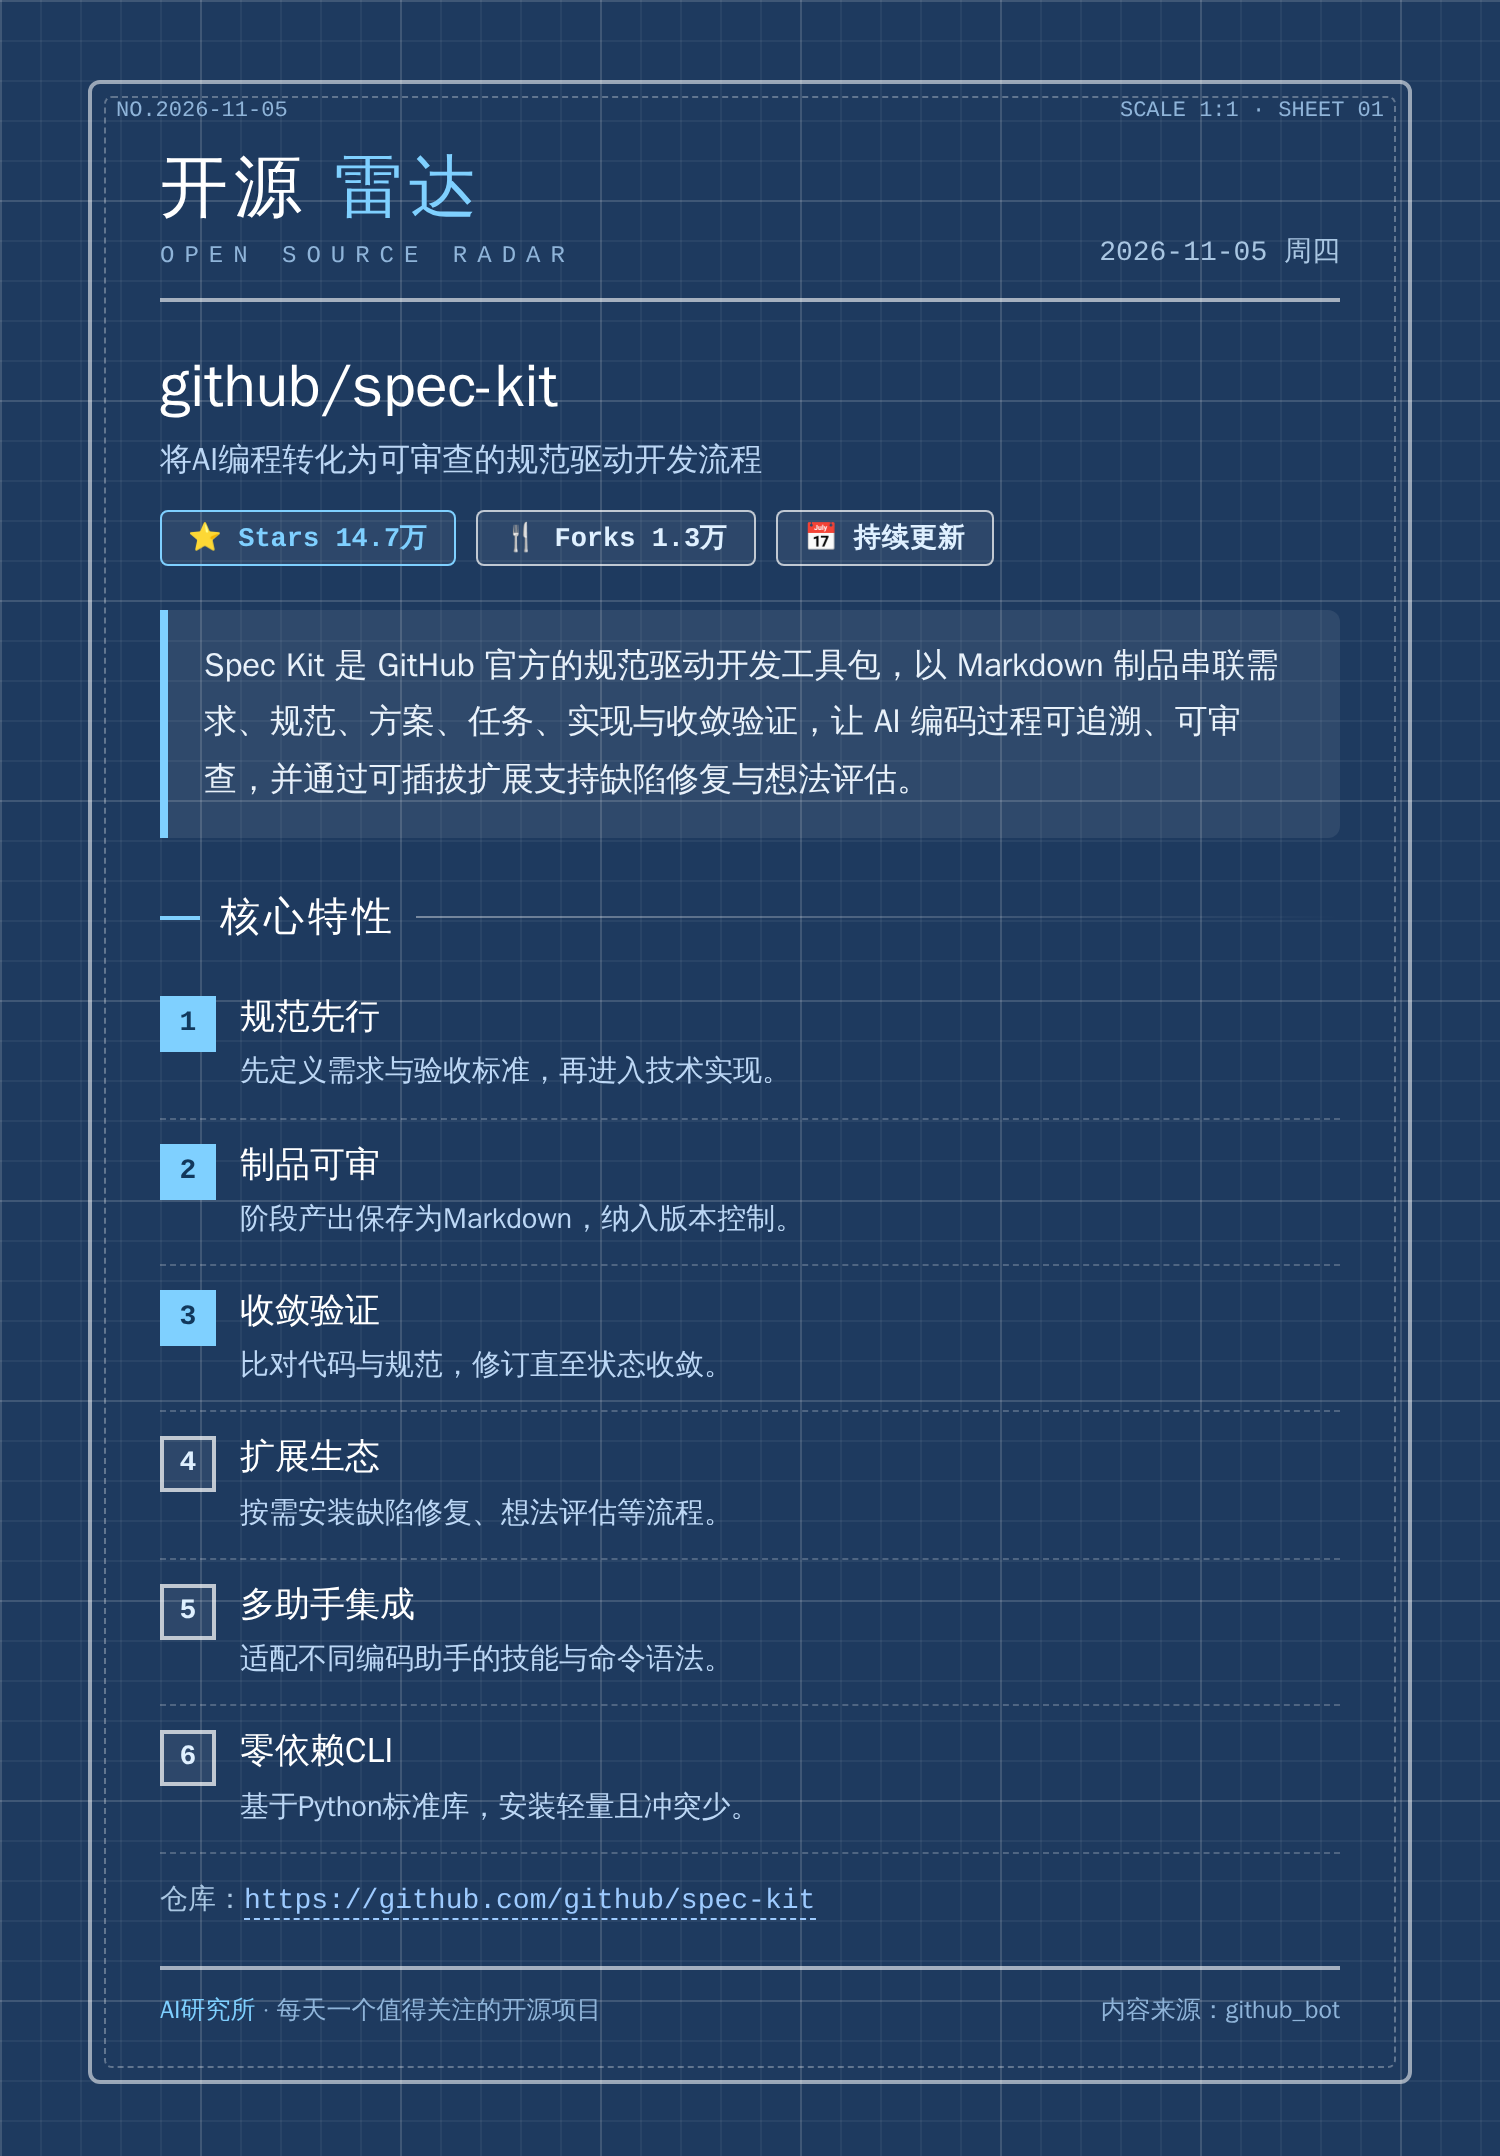
来源:github · 原文链接:https://github.com/github/spec-kit · 整理:github_bot · 发布时间:2026-11-05
一、项目概览
Spec Kit 是 GitHub 官方开源的规范驱动开发(Spec-Driven Development,SDD)工具包,采用 MIT 许可证,使用 Python 3.11+ 实现,命令行入口是 specify-cli,发布在 PyPI 上。截至目前,仓库已积累约 14.7 万 stars、1.3 万 forks,是 AI 辅助编程领域热度最高的项目之一。
它要解决的问题很具体:AI 编码助手很擅长“写代码”,却不擅长“先想清楚再写”。当对话式提示变成主要的开发入口后,需求往往散落在聊天记录里,改动缺少可追溯的依据,几轮对话之后连开发者自己也说不清当初为什么这样实现。Spec Kit 的答案是把工程实践重新固定下来:先明确做什么、为什么做,再决定怎么实现,并把中间产物保存成可审查的 Markdown 制品。
值得注意的是它的定位,类似一套团队工作方法,并不仅仅是一个代码生成框架。仓库里大量内容是模板、流程定义和约束文本,真正的 Python 代码只是一层轻量编排器。这种“文档为主、代码为辅”的结构,决定了它的能力和边界。
二、核心特性速览
| 特性 | 说明 |
|---|---|
| SDD 内置核心 | 规范驱动开发是默认流程,初始化项目即可使用,无需额外安装 |
| 缺陷修复扩展 | 以可选扩展提供 assess → fix → test 三步法,专注线上异常 |
| 想法评估扩展 | intake → research → define → shape → decide 五步,能评估非软件类想法 |
| 结构化流程 | 每个阶段都有明确的输入、输出与检查点,不由模型自由发挥 |
| 可复用模板 | spec / plan / tasks / checklist / constitution 五类模板统一产出格式 |
| 可查制品 | 所有中间结论保存成文件,可 diff、可评审、可回溯 |
| 三种独立入口 | 三个流程彼此独立,不必按顺序走完 |
| 多助手适配 | integrations 目录维护各家 AI 编码助手的调用方式差异 |
有一处容易被误读:三个流程分别对应三种不同需求,并不代表同一条流水线的三个阶段。README 专门强调这一点,因为把“想法评估”当成 SDD 的前置步骤,会让简单功能开发多背上一层不必要的负担。
三、系统架构设计
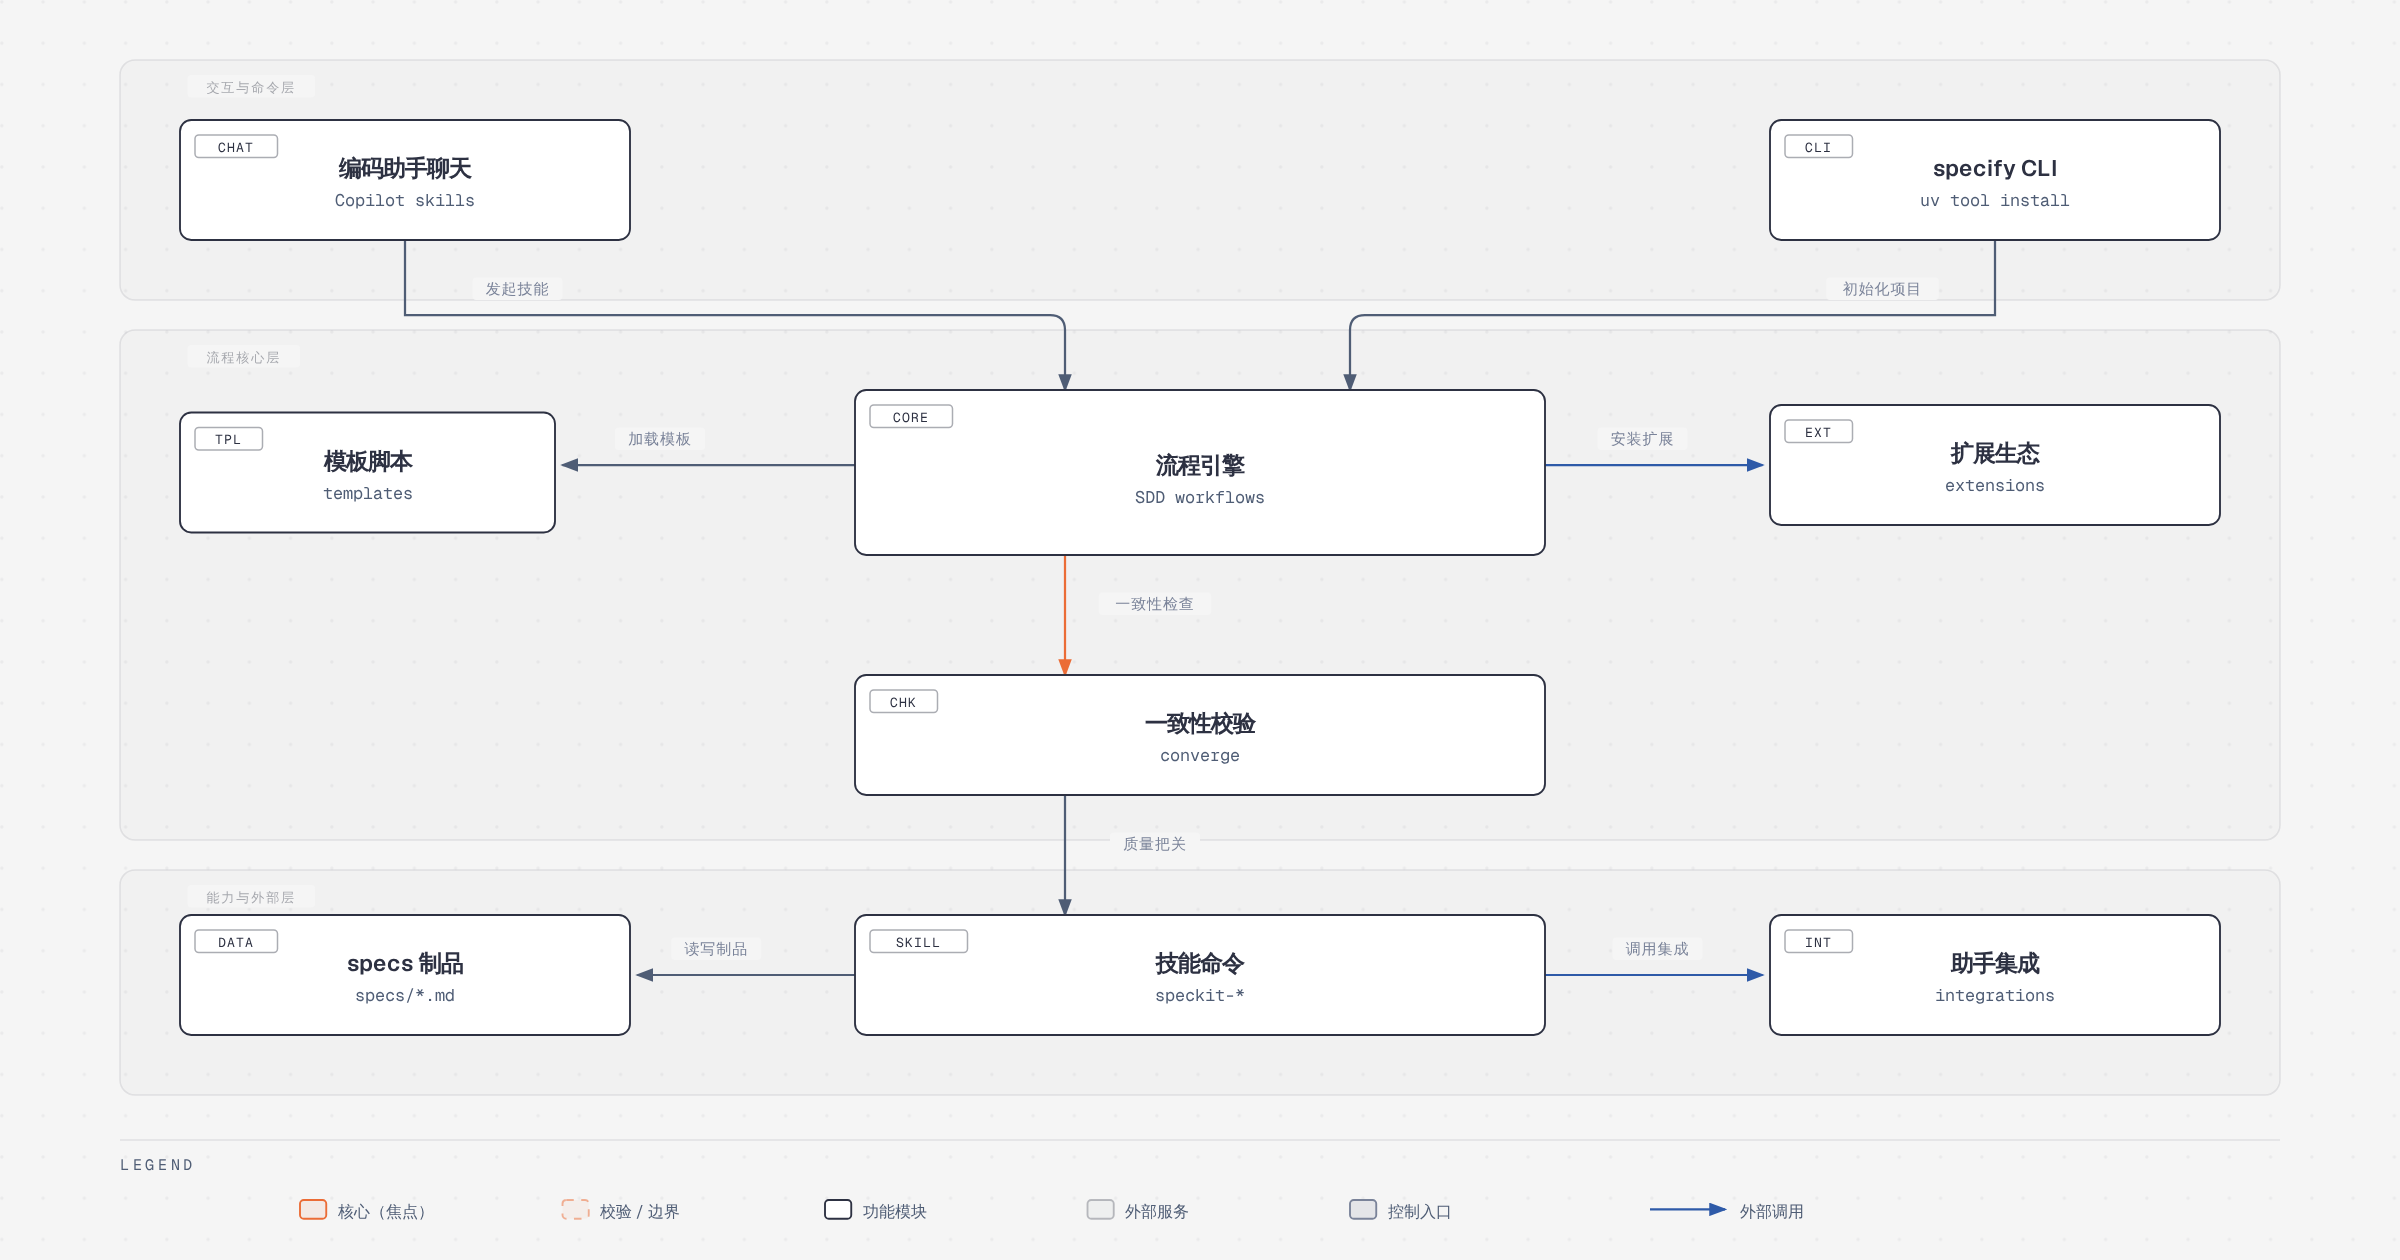
按 arch.zones 的三层划分来看,Spec Kit 的分层意图相当清晰。
交互与命令层由三个节点构成。entry 是编码助手聊天界面(默认示例为 Copilot skills 模式),这是用户实际的入口;api 是 specify CLI,负责一次性的项目初始化与扩展安装;tools 则是 speckit-* 系列技能命令,用户把它们当成撒在聊天里的“动词”来调用。这一层的设计取向是把配置动作和日常动作分开:CLI 只在终端跑一次(api → core 初始化项目),此后所有工作都在聊天里完成(entry → core 发起技能)。
流程核心层是真正的中枢。core 是流程引擎,持有 SDD 的阶段定义与推进逻辑;side1 是模板与脚本资源,流程启动时被加载(core → side1 加载模板),为每个阶段提供产出骨架;guard 是一致性校验节点,对应 converge 技能,负责在实现之后比对代码与规范是否仍然对齐(core → guard 一致性检查)。这条 core → guard → tools 的链路是整个架构最值得称道的一环:它把“质量把关”实现为一个可执行的节点,而不仅仅是理念。
能力与外部层负责向外延展。side2 是扩展生态,通过 specify extension add 安装(core → side2 安装扩展),缺陷修复与想法评估都从这里挂载进来;data 是保存到 specs/*.md 和 .specify/ 的制品集合,由技能命令读写;exec 是助手集成适配层,让同一套技能定义能落到不同厂商的 Agent 上(tools → exec 调用集成)。
整体看,这是一个以制品为中心的星形结构:流程引擎不直接生成代码,而是通过技能命令驱动助手,助手读写文件;引擎自身只维护阶段纪律与模板契约。好处是解耦彻底——换助手、换模型、换模板都不影响主干逻辑;代价是能力上限受限于助手的理解力,Spec Kit 只能约束流程,无法保证语义正确。
四、核心流程或主循环
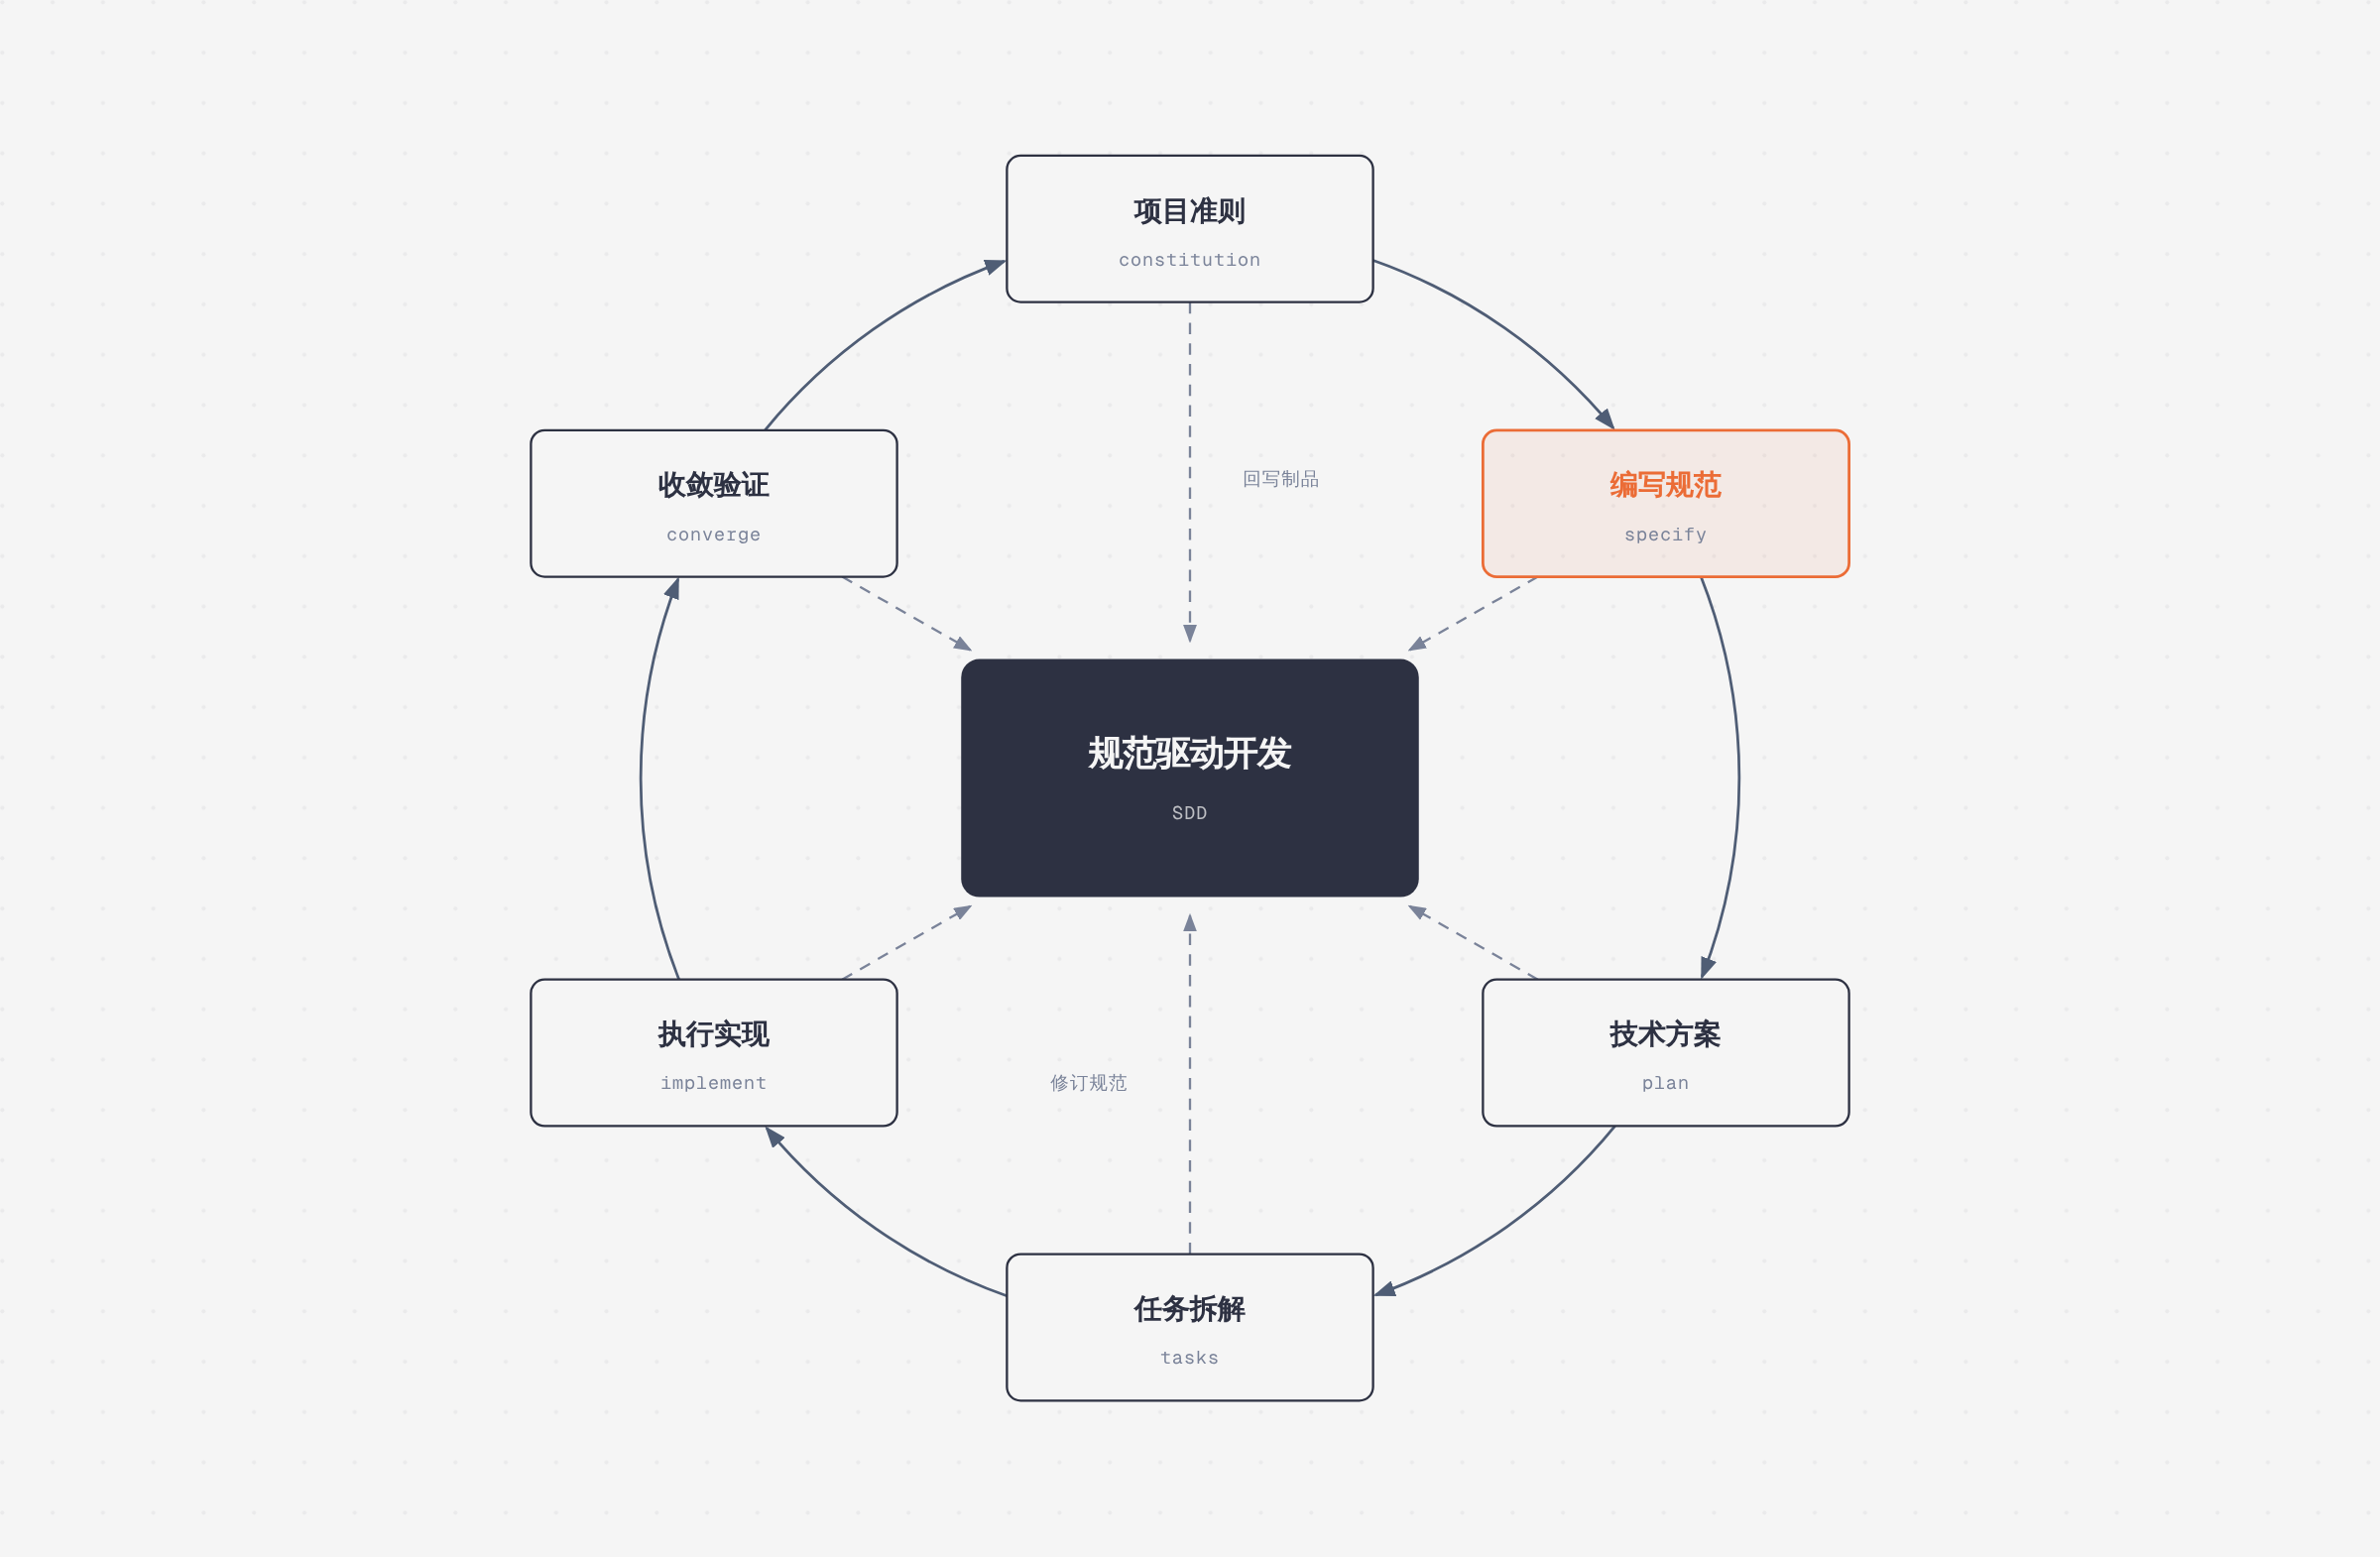
SDD 主循环由 loop.stations 的六个站点串成,围绕“规范驱动开发”这个 hub 运转。
第一站:项目准则(constitution)。 每个项目只做一次。/speckit-constitution 生成一份围绕代码质量、测试与可维护性的原则文件,之后所有阶段都受它约束。这是把团队工程规范提前注入 AI 上下文的最低成本做法,也是后续争议的仲裁依据。
第二站:编写规范(specify)。 这是流程的重心(focal_station 即此)。/speckit-specify 把一句自然语言需求扩写成包含用户场景、验收标准的规范文档,只回答“做什么”,刻意不谈技术选型。
第三站:技术方案(plan)。 /speckit-plan 才引入技术约束——例如“用 Vite + 原生 JavaScript,图片存本地,元数据放 SQLite”。规范与技术方案分离,是这套方法最有价值的约束:技术选型可以替换,需求本身不应随之漂移。
第四站:任务拆解(tasks)。 /speckit-tasks 依据规范与方案生成可执行任务清单,粒度到能逐条实现、逐条验收。
第五站:执行实现(implement)。 /speckit-implement 让助手按任务清单写代码,并把进度回写到制品(回写制品)。
第六站:收敛验证(converge)。 /speckit-converge 比对实现结果与规范,输出收敛报告。关键是这一步可以失败:报告会指出偏差,用户修订规范或修改代码后再次执行 implement → converge,直到状态变为 Converged。
这条循环的意义在于:它把“AI 写得对不对”从主观感受变成了可重复执行的状态机。对应另两条支线——缺陷修复 assess → fix → test(结论为 verified / partial / failed)与想法评估 intake → research → define → shape → decide(结论为 go / needs-clarification / kill)——设计思路一致:每个流程都必须给出一个明确的终态判定,而不只是留下一堆看起来很有道理的文字。
# 终端:安装 CLI 并初始化项目(只需一次)
uv tool install specify-cli
specify init my-project --integration copilot
cd my-project

# 需要缺陷修复 / 想法评估能力时,再按需安装扩展
specify extension add bug
specify extension add assess
五、核心模块解析
| 模块 | 职责 |
|---|---|
src/specify_cli | CLI 核心实现,负责 init 建项目、extension add 装扩展、集成适配与升级 |
templates/commands | 技能命令定义,把 /speckit-* 映射为助手中的具体指令 |
templates/ 五件套 | spec / plan / tasks / checklist / constitution 模板,统一各阶段产出结构 |
scripts/ | bash、powershell、python 三套脚本,覆盖脚本执行与跨平台钩子 |
extensions/ | agent-context、assess、bug、git、github、selftest、template 等扩展实现 |
presets/ | 预设项,用于调整既有行为,如 lean 精简模式、constitution-sync 同步 |
workflows/ | 将多步骤串联为可自动执行的流程定义 |
bundles/ | 面向角色的一键配置打包(assess、bugfix 等) |
integrations/ | 各家 AI 编码助手的适配目录与调用语法映射 |
catalog.json | 扩展、预设、工作流、集成的目录索引,供 CLI 检索安装 |
一个值得留意的工程细节:pyproject.toml 中 specify-cli 的核心依赖为空,版本号为 1.3.1.dev0。也就是说这个分发量巨大的工具本质上是零第三方依赖的 Python 标准库程序。对于一个需要长期安装在开发者机器上的 CLI,这是非常克制的选择——升级不会牵连依赖树,CI 里也不会有版本冲突。
六、特色能力
四类扩展点分工明确。 扩展(extensions)新增能力,预设(presets)调整现有行为,工作流(workflows)自动串联步骤,捆绑包(bundles)打包面向角色的整套配置。这套抽象不是为扩展而扩展:缺陷修复与想法评估本身就是以扩展形式落地的,说明官方在用自己的扩展点,可信度较高。
项目本地覆盖与术语本地化。 单项目的一次性模板调整可以放在项目内覆盖,不污染全局;流程或术语的本地化走预设。对非英语团队来说,后者比想象中重要——让 AI 用中文术语产出制品,评审成本明显下降。
多语言与多助手。 README 提供英文、简体中文、日文、韩文四版,首页有完整文档站。集成层则适配 Copilot 的 skills 模式以及其他助手的命令语法差异,README 明确提示“这些是助手技能,不是终端命令”。
默认模式的选择很有讲究。 示例采用 Copilot 的 skills 模式,而非把所有内容压进单一系统提示——这既降低了上下文占用,也让每个技能可以被独立检查、独立替换。
七、工具链或生态
工具链非常简单:uv 安装 CLI,specify init --integration <标识> 生成项目骨架,之后进入助手聊天调用技能。整个前置成本大约两分钟,这是它能在社区快速扩散的重要原因。
生态侧的核心是若干 catalog.json 与 catalog.community.json 配对文件——官方目录与社区目录并存,覆盖 extensions、presets、workflows、bundles、integrations 五类。这意味着第三方可以发布自己的流程与预设,而用户用 specify extension add 一条命令获取。对于一个方法论型项目,这种“目录 + 社区提交”的做法比单纯收 PR 更具扩展性。
文档结构也值得一读:design/ 下有 cli、extension、integration、mcp、workflow-step、file-helper 等设计文档,newsletters/ 甚至有按月记录的项目通讯。这说明项目在有意识地维护治理透明度,而不是靠 README 单页撑场面。
八、部署与安全
前置条件只有三样:Python 3.11+、uv、以及一款受支持的 AI 编码助手,Linux / macOS / Windows 均可。部署模型是“CLI 装一次、项目 init 一次”:CLI 属于全局工具,项目文件属于仓库,制品写入 specs/ 与 .specify/ 目录,天然可以纳入版本控制与代码评审。
安全边界需要用户自己把握:Spec Kit 本身不访问网络、不带运行时依赖,风险主要来自助手读取仓库与执行脚本。仓库提供 SECURITY.md 与 CODE_OF_CONDUCT.md,selftest 扩展可用于验证安装完整性。另外,文档明确区分了工具升级与需求演进——升级时更新工具文件,需求变化时更新 specs/ 制品,两者不混在一起,这条纪律减少了大量无谓的 diff 噪音。
九、适用场景
从零构建功能或应用:这是主场景,尤其适合需求边界模糊、需要反复澄清的中型功能。
线上异常诊断与验证修复:走 bug 扩展的 assess → fix → test,强制给出 verified / partial / failed 结论。README 里那句话说得直接——缺少验证不算修复成功。
想法可行性评估:intake → research → define → shape → decide 输出 go / needs-clarification / kill。值得一提,这个流程对非软件想法同样适用,即使项目里没有一行代码。决定不做,也是有效产出,这是很多工具不愿意承认的结论。
已有代码库的规范演进:借助现有项目指南与 evolving-specs 文档,把存量系统逐步纳入规范管理,而不是推倒重来。
十、总结评价
Spec Kit 的真正价值是把 AI 编码从随性对话收敛为可审计的流程,代码生成本身并不是它的核心价值。它抓住了一个被普遍忽视的问题:AI 让写代码变便宜了,但让“确认写对了”变贵了。规范、方案、任务的分离,以及 converge 这个可失败的终态判定,都是在为“确认”重新定价。这套思路配合 14.7 万 stars 的社区规模与可插拔扩展生态,形成了相当强的正反馈。
适用人群很明确:需要交付可维护系统的工程团队、被 AI 生成代码淹没而失去掌控感的开发者、以及想把 AI 纳入既有研发流程而非另起一套的组织。个人写脚本、做一次性原型,直接对话往往更快。
局限同样清楚。其一,流程本身有重量——六个阶段加多轮收敛,对“改一个按钮颜色”这类需求是明显过载,项目也承认三种流程需要按需选择。其二,阶段产出仍需人工检查后再推进,README 反复强调“检查结果后再继续”,说明它并不提供自动正确性保证。其三,流程约束再强也无法弥补模型对领域理解的缺失,规范写得含糊,后面每一步都会放大误差。其四,围绕它的最佳实践仍在快速演进(CLI 仍是 dev 版本),团队引入时需要预留磨合成本。
一句话总结:Spec Kit 更像一份可执行的工程纪律,重点不在于替你写代码;它的成败取决于你是否愿意在动手之前,先把“为什么”写下来。
参考链接:github/spec-kit 仓库 · 官方文档站