来源:github · 原文链接:https://github.com/microsoft/VibeVoice · 整理:github_bot · 发布时间:2026-11-06
一、项目概览
VibeVoice 是微软开源的语音 AI 模型族,项目自我定位很明确:Open-Source Frontier Voice AI——不是单点模型,而是一族覆盖语音合成(TTS)与语音识别(ASR)的开源前沿模型。仓库以 MIT 协议发布,累计 Star 已超过 5.5 万、Fork 逾 6000,创建于 2025 年 8 月,并在 2026 年仍保持持续提交,这在语音基础模型领域属于少见的长周期维护节奏。
它的稀缺性在于双栈统一。业界多数开源语音项目要么只做 TTS(追求音色、韵律与表现力),要么只做 ASR(追求字错率与鲁棒性),两条技术栈共享的中间表征很少。VibeVoice 用同一套「连续语音分词器 + LLM + 扩散头」的骨架,向上支撑合成,向下支撑识别,衍生出长音频转写、长对话合成、实时流式三条产品线。这种统一让它在工程上更有复用价值:同一套分词器、同一套语境建模逻辑,换个解码目标和数据就能切换任务方向。
从仓库结构看,它已经不是一个"论文附带代码"的形态,而是带有完整权重发布、Playground、微调脚本、vLLM 推理插件与安全说明的工程化项目。这一点对评估其可用性很关键——你拿到的不只是模型定义,而是一条从权重下载到 LoRA 微调的链路。
二、核心特性速览
项目的核心创新一句话可以概括:把语音压缩到 7.5Hz 的超低帧率,再用 LLM 加扩散头重建高保真声学细节。常规语音 tokenizer 往往工作在 25Hz、50Hz 甚至更高帧率,长音频序列长度会迅速撑爆上下文;7.5Hz 意味着每秒仅 7.5 个 token,一小时的语音在 token 层面被压缩到可被 64K 上下文容纳的规模——这是它能做"单次长音频"的根本前提。
| 能力维度 | 具体指标 | 对应模型 |
|---|---|---|
| 语音分词帧率 | 7.5Hz(Acoustic + Semantic 双分词器) | 全系共享 |
| 长音频识别 | 单次 60 分钟,64K token 上下文 | VibeVoice-ASR |
| 长音频合成 | 单次 90 分钟,语境与音色一致 | VibeVoice-TTS |
| 多说话人 | 单段对话最多 4 人,自然轮次切换 | VibeVoice-TTS |
| 结构化转写 | Who(说话人)/ When(时间戳)/ What(内容) | VibeVoice-ASR |
| 定制热词 | 用户提供专名、术语、背景信息引导识别 | VibeVoice-ASR |
| 流式能力 | 识别边收边出;TTS 首包约 300ms | Streaming 变体 |
| 部署体积 | 0.5B 参数,实时 TTS,约 10 分钟长语音 | VibeVoice-Realtime |
| 语言支持 | 英语、中文及其他语言,支持跨语种 | TTS / ASR |
值得注意的是 Realtime 0.5B 这条支线。它把模型压到部署友好的量级,同时保留流式文本输入与长语音稳定性,说明团队对"研究模型"和"能上线的模型"做了区分设计。表格里最容易被忽略的一行其实是"定制热词"——这是 ASR 落地时最实际的痛点,会议里的产品名、人名、缩写,通用模型几乎必错,热词机制比后处理纠错可靠得多。
三、系统架构设计
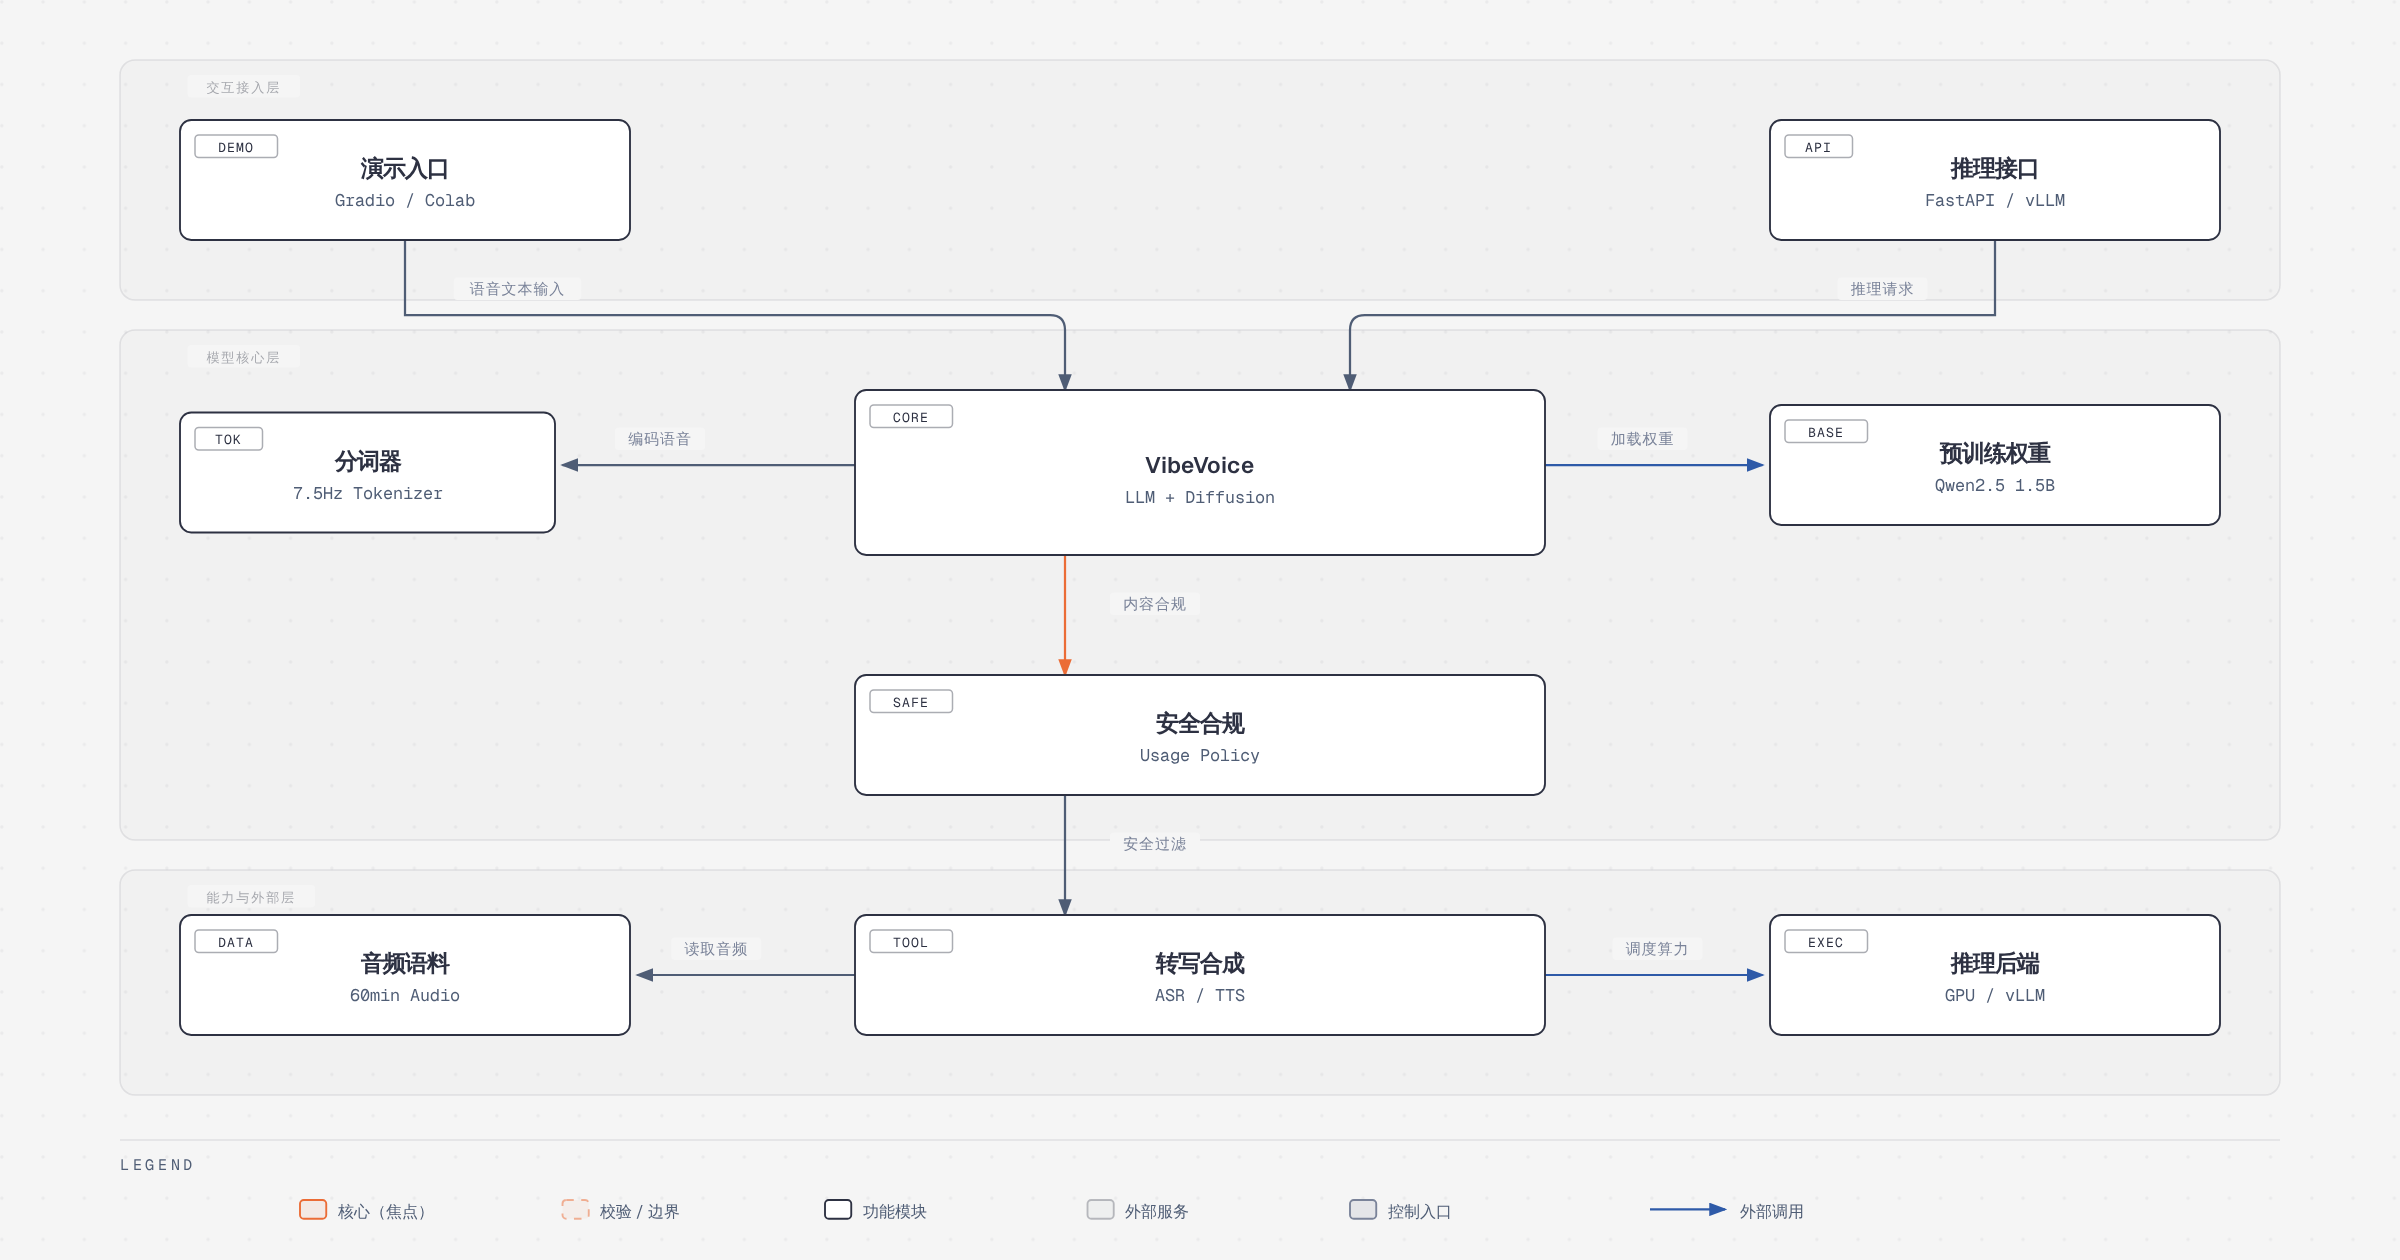
从分层上看,VibeVoice 可以拆成三个 zone:交互接入层、模型核心层、能力与外部层。
交互接入层由「演示入口」(Gradio / Colab)与「推理接口」(FastAPI / vLLM)构成。这一层负责把语音或文本输入送进核心,入口形态覆盖了从零成本体验到生产级服务的全谱系:demo/ 下有 vibevoice_asr_gradio_demo.py、vibevoice_realtime_colab.ipynb、vibevoice_asr_streaming_fastapi_demo.py 等脚本,分别对应交互演示、一键体验与流式服务三种诉求。它们到核心的连线是"语音文本输入"和"推理请求",是纯粹的适配层,不承载算法逻辑。
模型核心层是整个架构的重心,中心节点是 VibeVoice(LLM + Diffusion)。它向下加载「预训练权重」(Qwen2.5 1.5B)——README 明确说明本版本的基座是 Qwen2.5 1.5B,这意味着项目的 LLM 能力、偏见与错误都会从基座继承,这一点在风险章节被官方主动点明。它向侧边连接「分词器」(7.5Hz Tokenizer),连线语义是"编码语音":分词器既是 TTS 的输出重建目标,也是 ASR 的输入压缩通道,是双栈共享的关键接口。核心层内部的分工非常清晰——LLM 负责理解文本语境与对话流,扩散头负责生成高保真声学细节,即 next-token diffusion 框架:把"下一 token 预测"用于语义规划,把"扩散去噪"用于声学细节还原。
能力与外部层包含四个节点:「安全合规」(Usage Policy)、「转写合成」(ASR / TTS)、「音频语料」(60min Audio)、「推理后端」(GPU / vLLM)。核心到安全合规的连线是"内容合规",安全合规再到转写合成是"安全过滤",这条链路体现了项目对合成语音滥用的显式约束;转写合成向下"读取音频"(对应 60 分钟长音频语料)并"调度算力"(GPU 或 vLLM 后端)。vllm_plugin/ 目录正是这条算力连线的实现,内含 model.py、inputs.py、asr_streaming.py、asr_streaming_server.py,把模型接进 vLLM 的推理与服务框架,而不是让用户自己手写 batch 调度。
这套架构的取舍值得说一句:它把"语音"抽象成一种低帧率 token 序列,从而让 LLM 的上下文能力直接变成语音的上下文能力。代价是分词器必须足够强,才能让 7.5Hz 的表征不丢信息;收益是长序列的算力成本被压到可控区间,60 分钟和 90 分钟这些数字才有可能成立。
四、核心流程或主循环
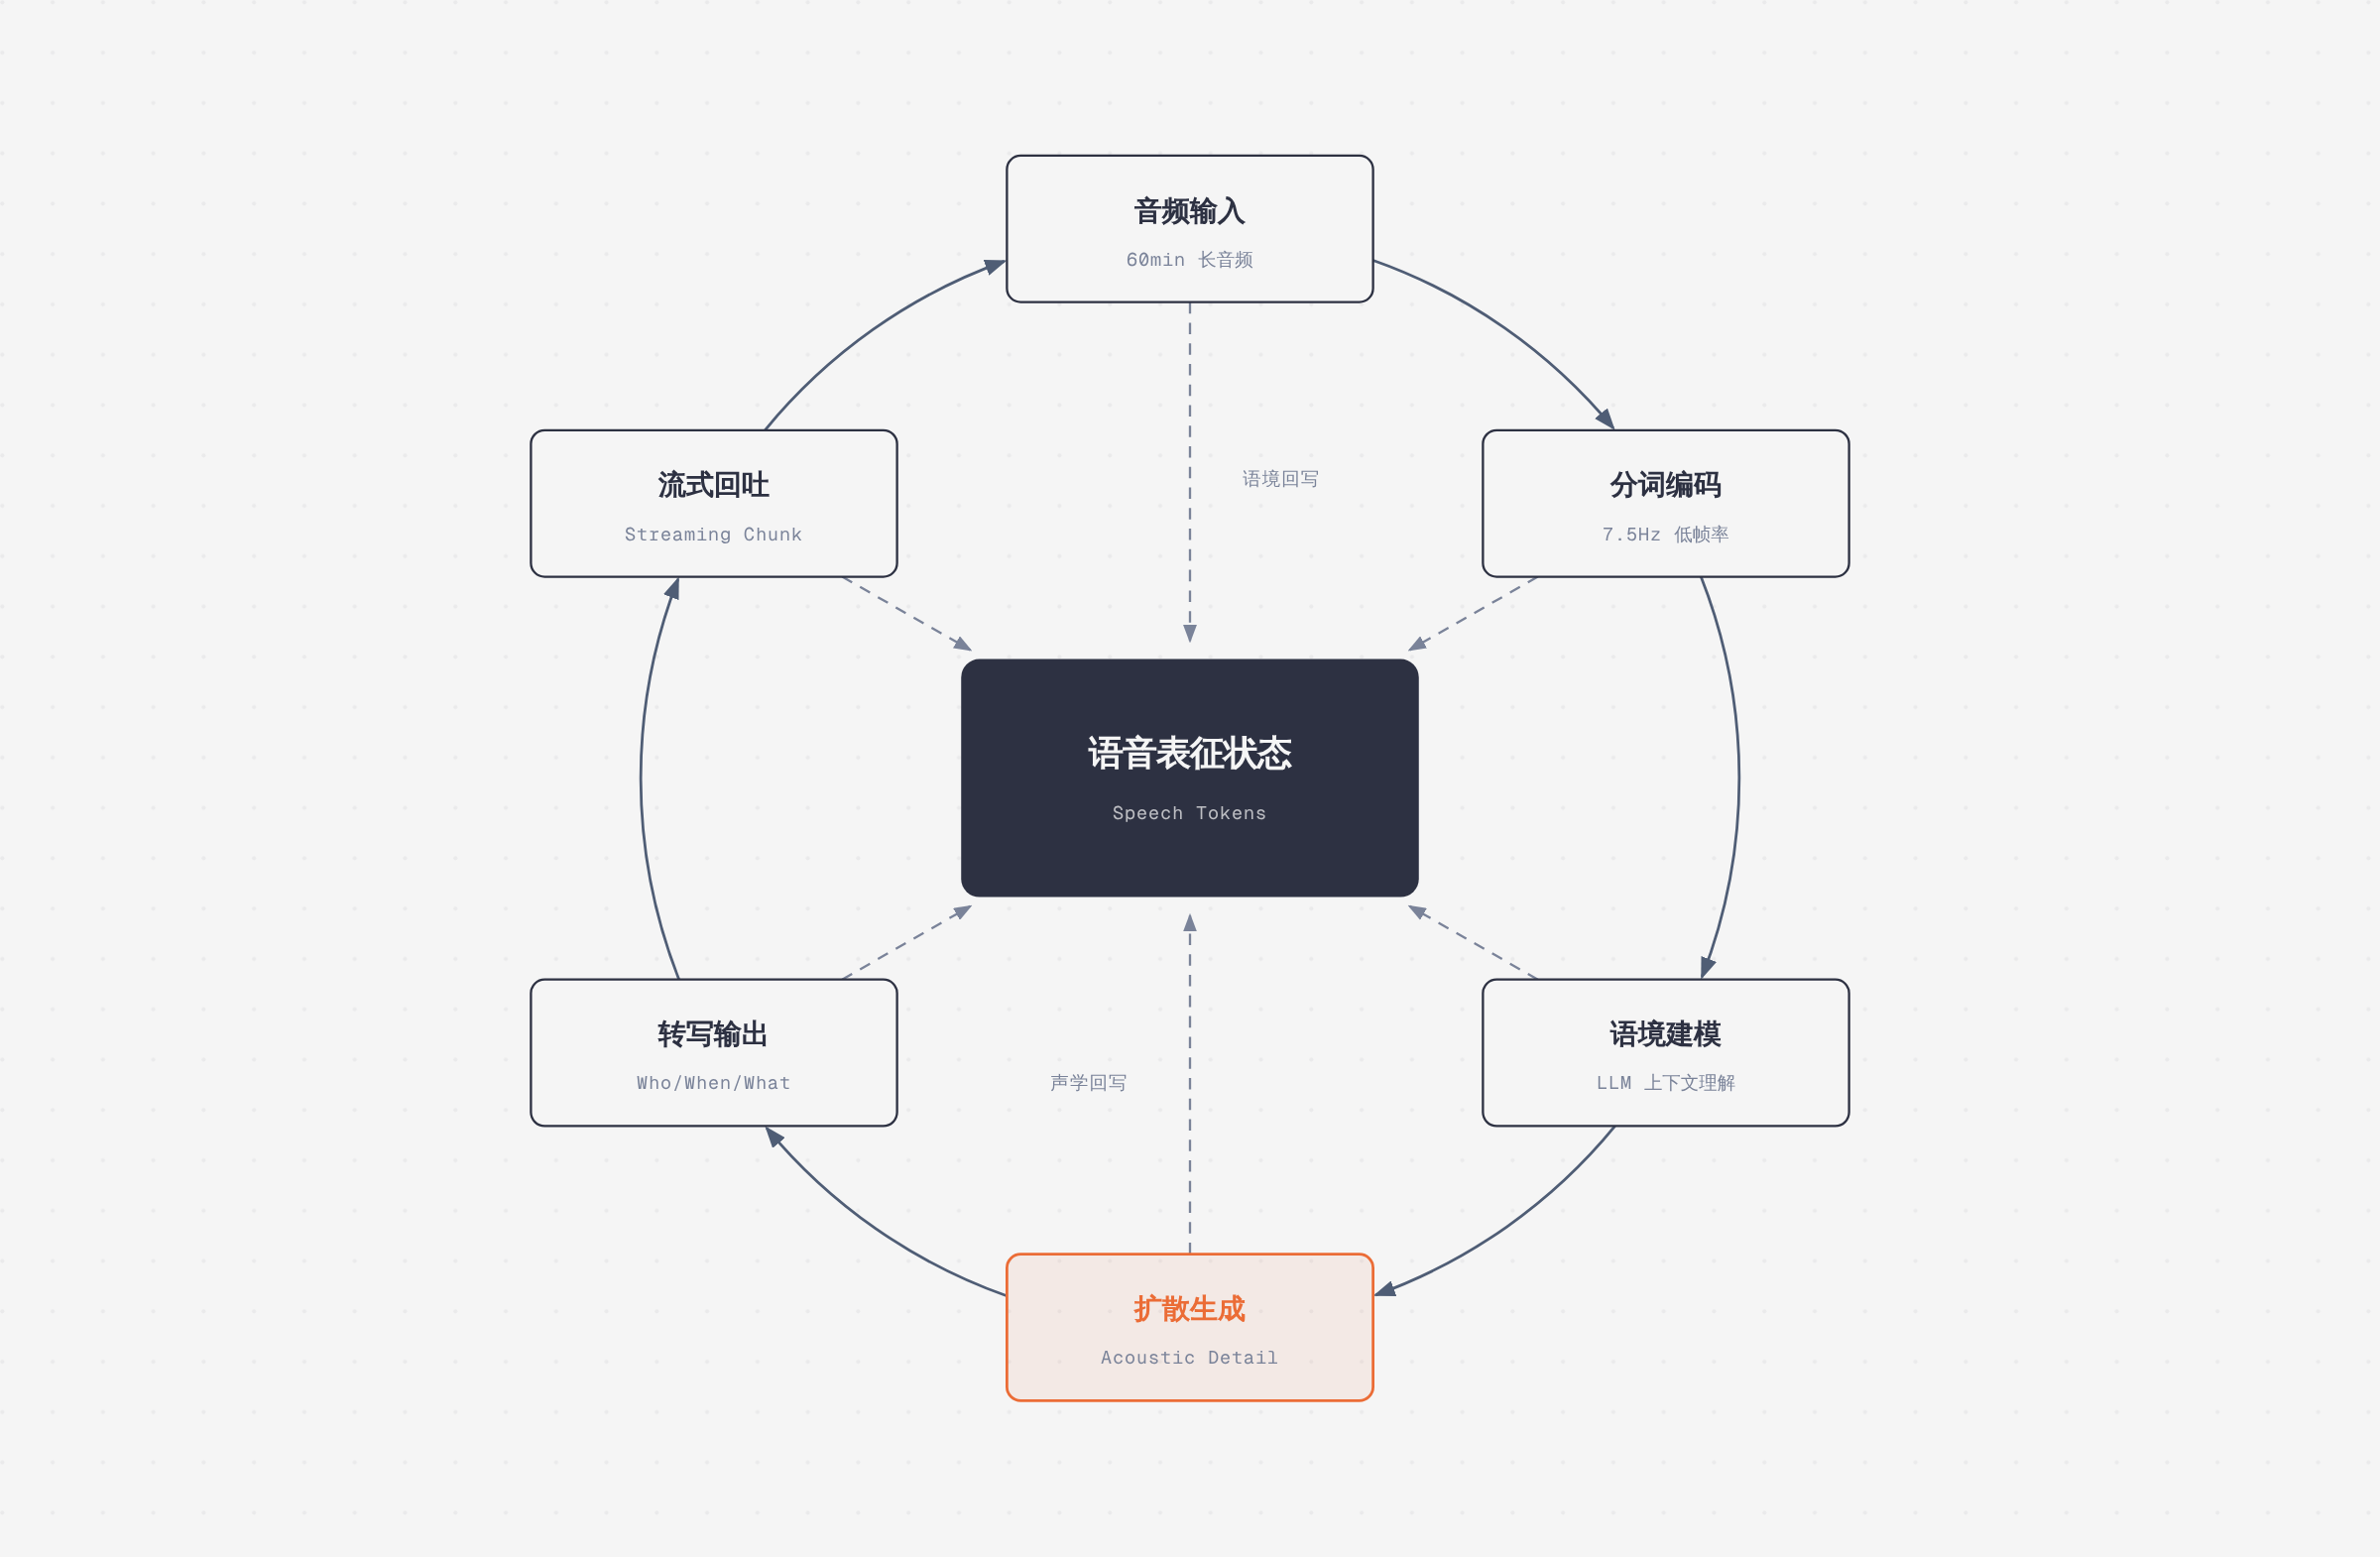
如果把 TTS 与 ASR 拉平成一条主干,流程可以拆成六个站点,中心 hub 是「语音表征状态」(Speech Tokens),整条流水线本质上是在这个表征空间里来回搬运。
第一站:音频输入。 对 ASR 而言是长达 60 分钟的连续音频,一次性喂入而非切片;对 TTS 而言是文本脚本(单人或至多 4 人的对话稿)。这一站的设计意图很明确——不切块。传统 ASR 把音频切成 10~30 秒片段,片段之间丢失全局语境,说话人跟踪容易跳变、专名前后不一致;VibeVoice 选择在 64K token 预算内整段处理。
第二站:分词编码。 音频经连续声学与语义双分词器压缩为 7.5Hz 的语音 token。语义分词器保留"说了什么"的抽象信息,声学分词器保留音色、韵律、环境等细节,二者分工使低帧率不至于牺牲保真度。
第三站:语境建模。 LLM 在 token 序列上做上下文理解,建模对话流、说话人轮次、语义连贯性。这是长音频一致性真正的来源:它知道第 50 分钟说话的人和第 3 分钟是不是同一个。
第四站:扩散生成(本流程的焦点站)。由扩散头在 LLM 给出的语义条件下生成高保真声学细节。这一步决定了输出是"能听懂"还是"听起来像人"。hub 在此处有两条回写——“语境回写"与"声学回写”:语境信息约束声学生成的方向,声学结果又反过来校验语境表征是否自洽,形成一轮闭环。
第五站:转写输出。 ASR 侧输出结构化结果,同时给出 Who(说话人)、When(时间戳)、What(内容),即把 ASR、说话人分离(diarization)与时间戳对齐三件事在一次前向中联合完成,而不是串三个独立模型。
第六站:流式回吐。 对实时场景,文本不等录音结束才输出,而是按音频块逐块回吐;TTS 侧对应约 300ms 首包可听延迟。这一站把"离线批处理"的模型拉进"在线交互"的可用区间。
五、核心模块解析
仓库的目录划分相当克制,四个一级模块各司其职:
| 模块 | 职责 |
|---|---|
vibevoice/ | 主包。configs/ 存模型与训练配置,modular/ 放模型组件化实现,processor/ 处理音视频与文本特征,schedule/ 承载扩散采样调度,scripts/ 为运行脚本入口 |
vllm_plugin/ | 推理与服务插件。model.py / inputs.py 对接 vLLM 的模型与输入规范,asr_streaming.py、asr_streaming_server.py 实现流式识别与服务端,tools/ 提供辅助工具 |
demo/ | 演示与体验层。含 asr_demo/、web/、voices/(音色资源)、text_examples/,以及 ASR 单文件推理、实时 TTS、流式 FastAPI 等可执行脚本 |
finetuning-asr/ | 微调链路。lora_finetune.py 训练、inference_lora.py 推理验证、toy_dataset/ 提供最小可跑样例,降低上手门槛 |
其中 schedule/ 与 modular/ 是理解算法实现的关键:前者对应扩散头的采样调度,后者体现模型被拆成可组合模块的设计取向。finetuning-asr/ 附带 toy dataset 这个细节很实用——很多项目的微调脚本默认你已经有清洗好的大数据集,而这里给了一条能先跑通的最小路径。
六、特色能力
Customized Hotwords(定制热词) 是最具工程价值的一项。用户可以把人名、产品代号、技术术语甚至背景信息作为提示喂给模型,直接引导识别过程。相比识别后做文本替换,热词是在解码阶段介入,对同音异形词、生僻专名的改善更本质。
Who / When / What 结构化转写 把三件事联合建模。独立跑 ASR + 说话人分离 + 强制对齐,三段误差会累积,且三模型对"边界"的判定标准不一致;联合建模天然自洽。
流式识别 有独立文档与独立实现(asr_streaming.py 与 FastAPI 服务脚本),按音频块出文本。它牺牲一部分全局语境精度,换取交互实时性,适合会议直播字幕、语音助手这类场景。
约 300ms 首包延迟的实时 TTS 由 Realtime 0.5B 承担,同时支持流式文本输入——意味着文本一边生成(比如来自另一个 LLM),语音一边合成,不必等整段文本完成。
长时一致性 是这些能力的共同底座:90 分钟合成不跑音色、60 分钟识别不丢说话人,靠的都是超低帧率带来的长上下文可行性。
七、工具链或生态
生态侧项目做得比较完整:Hugging Face 上有官方权重(VibeVoice-ASR、VibeVoice-1.5B、VibeVoice-Realtime-0.5B)与在线 Playground;GitHub Pages 提供项目主页与 Demo 试听;demo/vibevoice_realtime_colab.ipynb 支持 Colab 一键体验,适合先验证效果再决定是否本地部署。
服务化路径有两条:轻量用 Gradio/FastAPI 脚本直接起服务,生产向用 vllm_plugin 接入 vLLM,复用其批量调度与显存管理。微调路径由 finetuning-asr 提供 LoRA 方案,配合 toy_dataset 可以先在小数据上验证流程再放大。
快速开始示意(具体参数以仓库文档为准):
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
pip install -e .          # Python >= 3.10

# 长音频识别(单文件,最长 60 分钟)
python demo/vibevoice_asr_inference_from_file.py --audio meeting.wav

# 实时 TTS 演示(Realtime 0.5B)
python demo/vibevoice_realtime_demo.py

# 流式识别服务(FastAPI)
python demo/vibevoice_asr_streaming_fastapi_demo.py

# ASR LoRA 微调
python finetuning-asr/lora_finetune.py
依赖管理走 pyproject.toml,包名 vibevoice,版本 1.0.0,要求 Python ≥3.10,没有把依赖堆在 README 里让用户手工装。
八、部署与安全
部署门槛不高:Python ≥3.10,pip 安装即可,模型侧有 0.5B 的实时版本适合单卡甚至消费级显卡,长音频版本则需要更大显存或借助 vLLM 的显存优化。ASR 的 64K 上下文是显存消耗的主要变量,跑 60 分钟音频前应评估序列长度与批大小的组合。
安全方面官方态度明确且罕见地直白:承认模型可能产生意外、有偏或不准确的输出,并说明其继承了基座 Qwen2.5 1.5B 的偏见与错误;专门警示高质量合成语音可被用于深度伪造、冒充、诈骗与虚假信息传播;要求使用者自行核验转写可靠性、披露 AI 生成内容、遵守所在司法辖区法律。最重的一句是——不建议在未经充分测试的情况下用于商业或真实场景,本模型面向研究与开发用途。
这不是免责套话,而是对当前合成语音质量水平的诚实定价:当合成语音越过"像人"的门槛,滥用成本会同步下降。想落地的人应当把这句话当成工程前提,而不是法律条款。
九、适用场景
播客与多说话人长对话音频:90 分钟单次合成、4 人轮次,正好覆盖播客、有声剧、教学对话的形态,避免分段合成带来的音色漂移与语气断裂。
长会议录音整段转写:60 分钟单次 + Who/When/What 结构化输出,直接产出可读的会议纪要底稿,无需再拼接分段结果。
实时语音交互与朗读终端:Realtime 0.5B 的 300ms 首包延迟配合流式文本输入,适合语音助手、实时字幕、无障碍朗读等对时延敏感的场景。
领域术语与专名识别增强:医疗、法律、工业、开源社区等专名密集的领域,用热词机制替代后处理纠错,是成本最低的精度提升手段。
需要提醒的是,不适合直接用于对准确性有强合规要求的场景(如医疗记录定稿、法律取证转写),也不适合在缺乏内容审核机制的产品中开放合成能力。
十、总结评价
VibeVoice 的真正价值不在"又一个语音模型",而在用一套统一表征把 TTS 和 ASR 收进同一个技术栈。7.5Hz 分词器是这套设计的支点:它把语音序列长度压到 LLM 能吃下的量级,于是 LLM 的上下文能力、对话理解能力、指令能力都被"借"给了语音任务。60 分钟转写和 90 分钟合成这两个数字,表面是工程指标,实质是这个架构选择的必然结果。加上 MIT 协议、官方权重、vLLM 插件、LoRA 微调与 toy dataset,它给出的是一条从体验到改造的完整链路,而不只是可复现的论文代码。
适用人群:做播客/有声内容生成的产品团队、需要长会议转写与说话人分离的企业应用、研究长序列语音建模的学者、以及想把 TTS 接进实时语音 Agent 的工程师。如果你的场景是"短句、低延迟、单说话人",Realtime 0.5B 是更合适的入口;如果是"长、多人、要一致",TTS 与 ASR 的长音频版本才是正解。
局限性也要说清:其一,基座是 Qwen2.5 1.5B,模型规模决定了它在复杂语义、强噪声、重口音上的上限,不要指望它超越专门的工业级 ASR;其二,7.5Hz 是效率与保真的折中,极高频细节(比如歌声中的细微气声、乐器泛音)可能被平滑;其三,官方明确不建议未经测试商用,深度伪造风险是结构性而非可修补的;其四,生态虽完整但年轻,社区实践、第三方教程与踩坑记录远不如成熟的语音工具链丰富,遇到问题大概率要读源码。
一句话判断:这是目前开源语音领域少有的"架构有想法、链路能跑通、边界说得清"的项目。它的正确用法不是直接上线,而是作为语音基座,在你的领域数据上做一轮微调与充分评测——它把地基打好了,房子还得你自己盖。
参考链接:项目仓库 https://github.com/microsoft/VibeVoice | 项目主页与 Demo https://microsoft.github.io/VibeVoice/