来源:github · 原文链接:https://github.com/TheAlgorithms/Java · 整理:github_bot · 发布时间:2026-11-12
一、项目概览
TheAlgorithms/Java 是 TheAlgorithms 组织下规模最大的语言分支之一,定位非常明确:用 Java 把经典算法一个一个实现出来,供人阅读和学习。仓库积累了 67k+ stars、21k+ forks,MIT 许可,2016 年创建至今保持高频更新,是 GitHub 上最常被收藏的算法类仓库之一。
它和「算法库」这个词容易产生的误解需要先澄清:README 里写得很直白——这些实现是教学用途(for educational purposes),性能可能不如 JDK 标准库。也就是说,它不打算成为你 pom.xml 里的一个依赖,而是一份可以逐行读、逐行改、逐行跑的算法素材集。仓库不做算法竞赛式的极致优化,也不追求 API 抽象的一致性,它追求的是「一个文件就是一个算法,打开就能看懂」。
规模上的可维护性靠 DIRECTORY.md 兜底:这是一份自动/半自动维护的全量算法索引,按包和类名列出了仓库里所有实现。当仓库里堆着上千个 Java 文件时,索引本身就是产品的一部分——没有它,这个仓库只是一个巨大的文件夹;有了它,它才是一个可检索的学习资料库。
二、核心特性速览
| 维度 | 具体表现 |
|---|---|
| 语言与许可 | 纯 Java 实现,无第三方运行期依赖,MIT 许可允许自由使用与分发 |
| 覆盖范围 | 排序、搜索、数据结构、数学、密码学、字符串、贪心、动态规划、图算法等 |
| 组织方式 | 每个算法独立成类,多数自带 main 方法,可直接运行观察输出 |
| 构建体系 | 单模块 Maven 工程,pom.xml 统一管理编译、测试与插件 |
| 质量门禁 | Checkstyle 约束代码风格,PMD 与 SpotBugs 做静态缺陷扫描 |
| 持续集成 | GitHub Actions(build.yml)在 PR 上执行构建与检查,Codecov 统计覆盖率 |
| 在线体验 | Gitpod 一键进入云端开发环境,零本地配置即可改代码 |
| 索引能力 | DIRECTORY.md 提供全量算法清单,是仓库的检索入口 |
一个容易被忽略的细节是「自带 main 方法」这条约定。绝大多数工程仓库会禁止业务类写 main,但在这个项目里它是刻意保留的:每个算法类自己就是一个可执行的最小示例,学习者不需要写测试脚手架,点一下运行就能看到输入输出。这是典型的教学优先设计——牺牲了一点「工程洁癖」,换来了极低的阅读与验证门槛。
三、系统架构设计
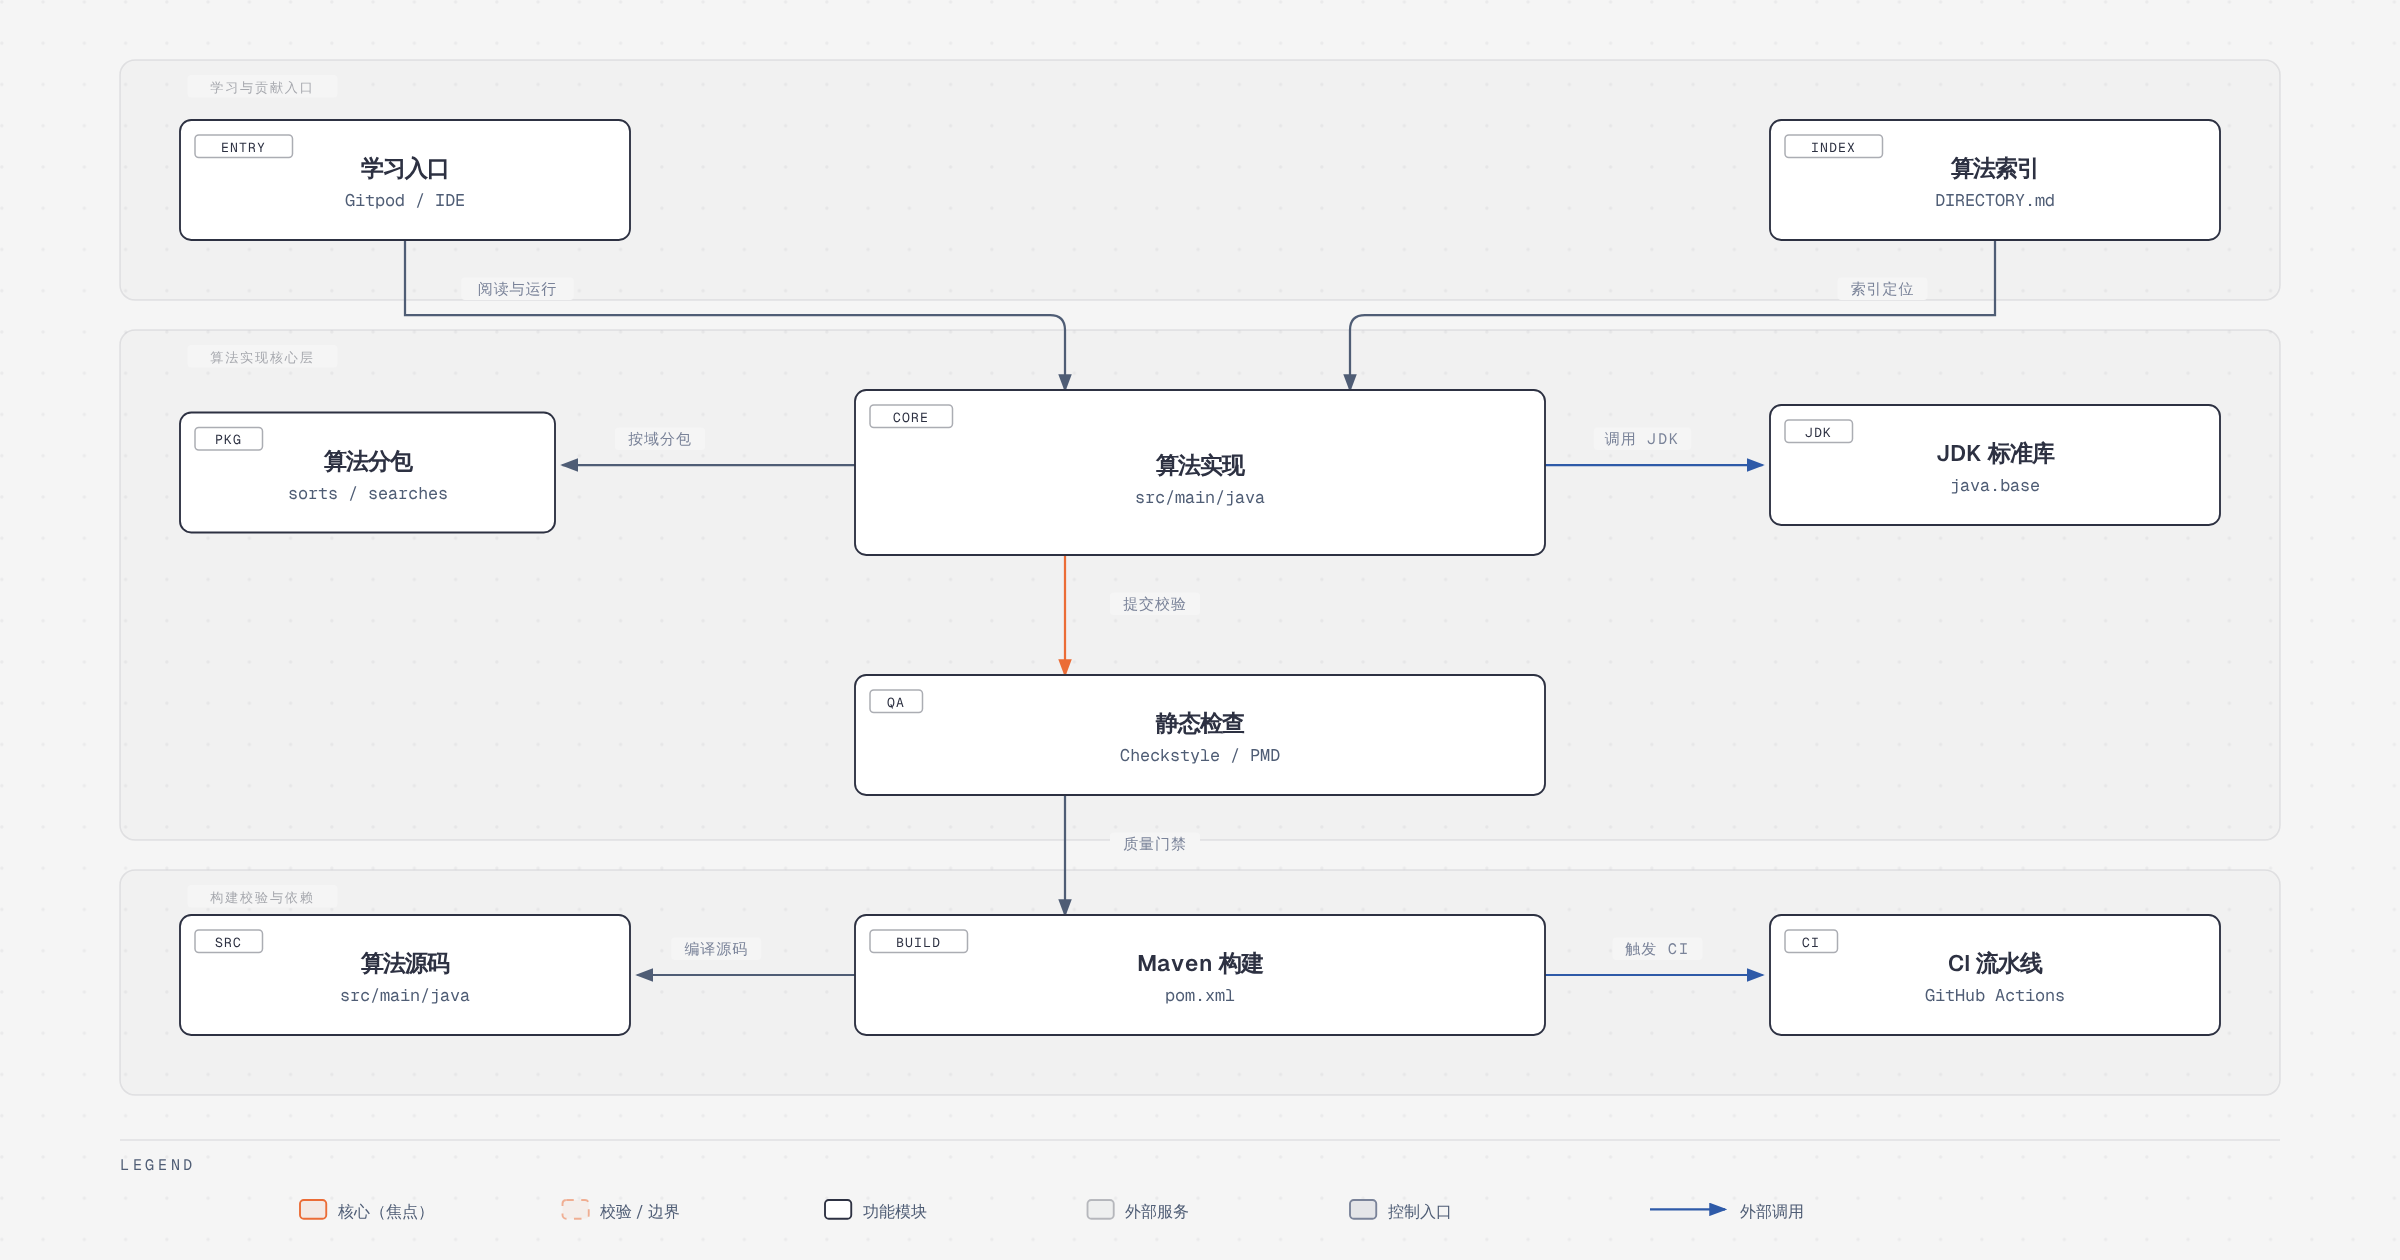
从架构上看,这个仓库的结构简单得近乎「反架构」,但正因为简单,才适合承载上千个互相独立的算法实现。可以按三个区域来理解:
第一层是学习与贡献入口。 学习入口(ENTRY)是 Gitpod 或本地 IDE,贡献者通过它进入代码;算法索引(INDEX)是 DIRECTORY.md,承担「先找到、再阅读」的导航职责。这两个节点分别对应 entry_to_core(阅读与运行)和 api_to_core(索引定位)两条边——一个从执行侧进入,一个从检索侧进入,最终都落在核心层。
第二层是算法实现核心层。 核心节点(CORE)是 src/main/java 下的全部源码,它是整个仓库唯一真正重要的部分。核心按领域分包(PKG,sorts / searches / datastructures 等),这就是 core_to_side1 这条「按域分包」的边:包名即分类,com.thealgorithms.sorts 下的类必然是排序,不需要额外元数据描述。另一侧是 JDK 标准库(JDK,java.base),对应 core_to_side2「调用 JDK」——项目刻意不引入 Apache Commons 之类的工具库,集合、流、数学函数全部走 JDK 原生 API,保证任何装了 JDK 的机器都能直接编译运行。
第三层是构建校验与依赖。 静态检查(QA,Checkstyle / PMD)通过 core_to_guard「提交校验」接收源码,再经 guard_to_tools「质量门禁」交给 Maven 构建(BUILD,pom.xml);Maven 一边 tools_to_data「编译源码」,一边 tools_to_exec「触发 CI」把结果送到 GitHub Actions 流水线。这条链的意思是:代码质量不是靠人肉 review 保证的,而是靠工具在合并前拦下来的。对于一个每年接收大量 Hacktoberfest 新手 PR 的仓库,这是唯一可行的治理方式。
整体上没有服务端、没有运行期容器、没有配置中心。它的「架构」本质上是目录约定 + 构建约束 + CI 门禁三件套,把所有复杂度压缩到了贡献流程里。
四、核心流程或主循环
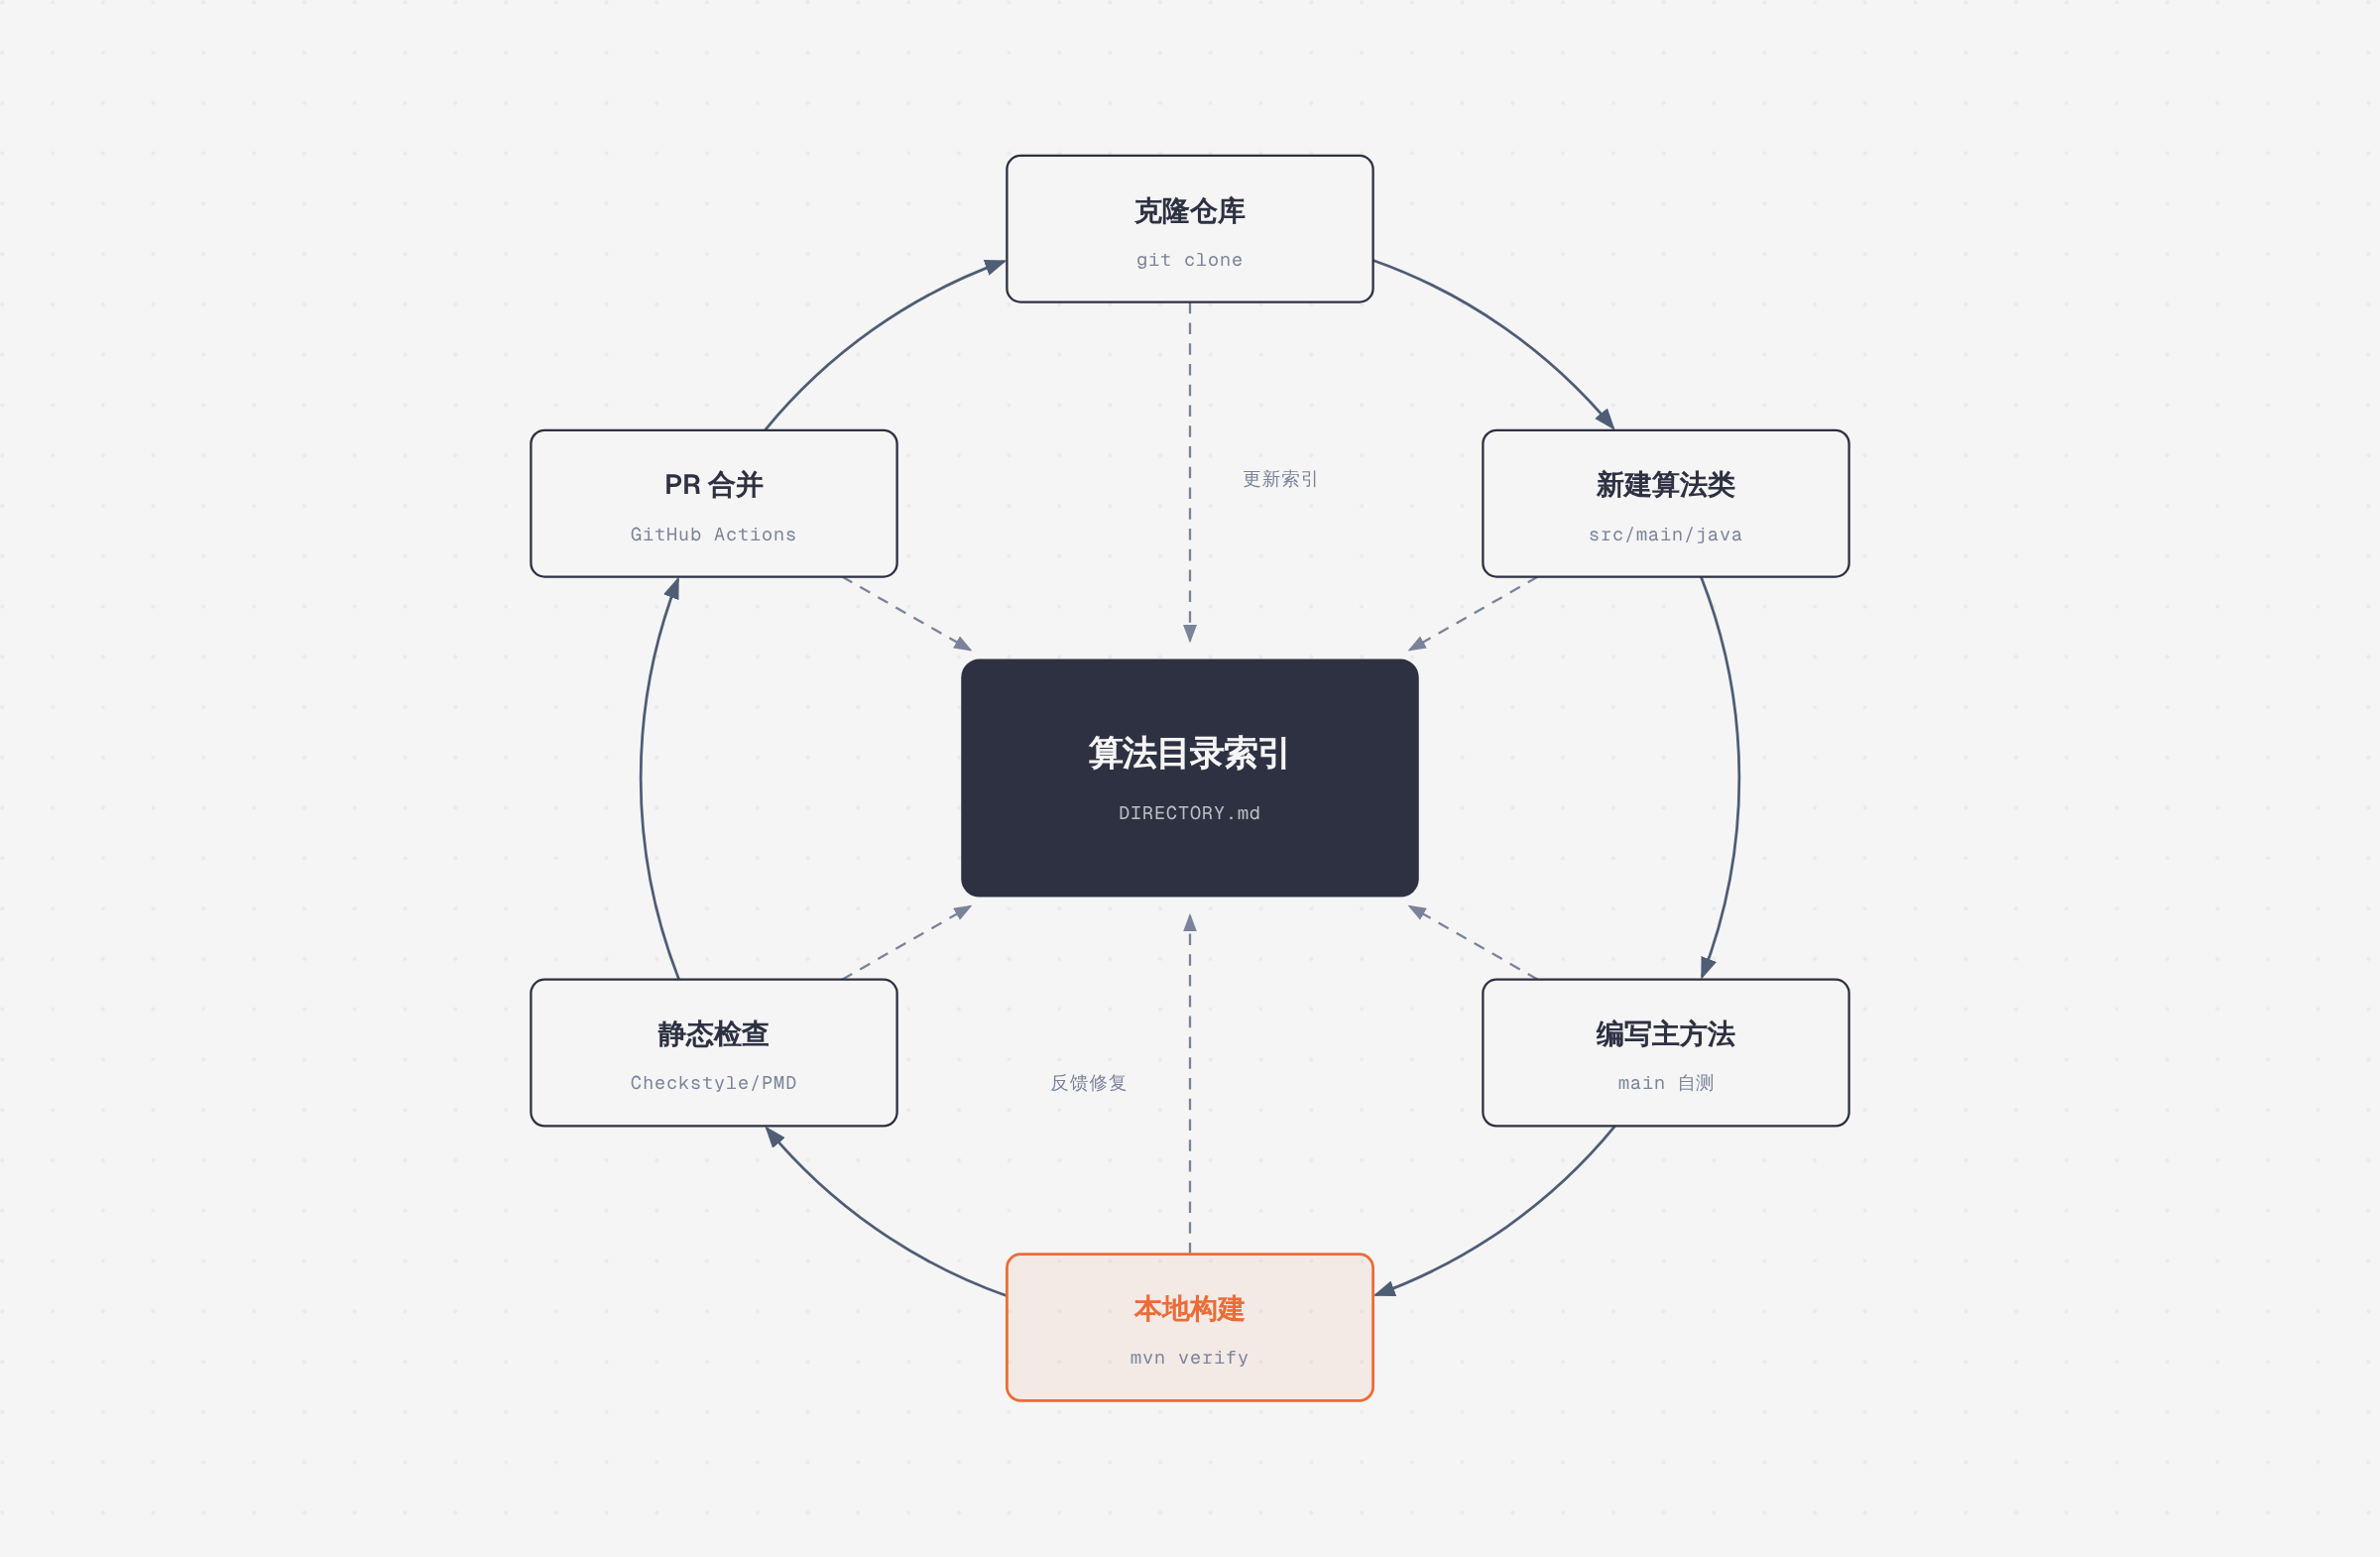
这个项目的「主循环」不是程序运行时的循环,而是贡献闭环:一次算法从想法到进入主干的六步流程,中心挂着 DIRECTORY.md 这个索引枢纽。
- 克隆仓库(
**git clone**):贡献者拿到完整代码库。因为仓库体量大,实践中通常配合浅克隆或直接使用 Gitpod 在线环境,避免本地环境折腾。 - 新建算法类(
**src/main/java**):在对应的领域包下新建一个类,类名即算法名。包的选择是强约束——排序进sorts,搜索进searches,放错包基本等同于没做完。 - 编写主方法(
**main**** 自测)**:这是流程的焦点步骤(focal station)。贡献者必须在类里写一个能直接跑的main,用具体输入演示算法行为。它同时承担三个作用:自测、示例、以及给 reviewer 的「可执行说明」。没有main的实现,评审者需要自己造数据才能验证,成本陡增。 - 本地构建(
**mvn verify**):跑完整生命周期,编译、跑单元测试、执行静态检查插件。这一步是贡献者的自检关卡,绝大多数低级问题(命名不规范、未使用变量、空指针隐患)在这里就会暴露。 - 静态检查(Checkstyle / PMD / SpotBugs):三项工具各有分工——Checkstyle 管格式与命名,PMD 管代码坏味道,SpotBugs 管字节码层面的缺陷模式。规则集通过
checkstyle.xml、pmd-custom_ruleset.xml定义,并用pmd-exclude.properties、spotbugs-exclude.xml维护白名单。 - PR 合并(GitHub Actions):CI 在 PR 上重跑同一套构建与检查,通过后由维护者评审合并。
索引枢纽(
DIRECTORY.md)与流程之间有两条辐条:更新索引——新增算法后必须在目录里登记,否则这个算法在仓库里几乎不可被发现;反馈修复——CI 或评审失败时,问题回流到贡献者,形成循环。这个设计很务实:目录不是自动生成的附产物,而是流程的一部分,逼着贡献者对自己新增的内容负责。
五、核心模块解析
| 模块(包) | 职责 | 典型内容 |
|---|---|---|
sorts | 排序算法实现 | 冒泡、插入、归并、快速、堆排序、计数排序、基数排序等 |
searches | 查找算法实现 | 线性查找、二分查找及其变体、插值查找等 |
datastructures | 基础数据结构 | 栈、队列、链表、堆、二叉搜索树、AVL、图结构等 |
maths | 数学与数论算法 | 最大公约数、素数筛、快速幂、组合数学、矩阵运算等 |
ciphers | 古典与现代密码算法 | 凯撒、维吉尼亚、AES/DES 教学实现、Base64 等 |
strings | 字符串算法 | 模式匹配、回文判定、编辑距离、字符串相似度等 |
graphs | 图算法 | BFS/DFS、Dijkstra、最小生成树、拓扑排序等 |
dynamicprogramming / greedy | 算法范式示例 | 背包、最长公共子序列、活动选择等经典问题 |
这个分包的价值观是「按人类认知分类,而非按抽象层次分类」。它没有统一的 Algorithm 接口,也没有工厂或策略模式去把算法抽象成可替换组件——每个类自我封闭,各写各的。对库设计来说这是缺点,对教学来说这是优点:读冒泡排序时你不需要理解任何框架,只需要理解冒泡排序。
datastructures 是最能体现这种取舍的模块。这里的数据结构实现为了可读性,通常省略了并发控制、扩容策略调优、迭代器完整语义这些工程细节,换来的是几十行就能讲清楚一棵 AVL 树怎么旋转。这正是它的价值所在。
六、特色能力
教学优先,可读性高于运行效率。 这是整个仓库的第一性原则。排序用小规模数据验证,递归实现不刻意改成迭代,变量命名用完整单词而不是缩写。代价是这些代码不能直接搬到生产环境的高频路径上。
单文件即算法。 没有跨文件的继承体系,没有共享基类。一个 .java 文件复制出去就能单独编译运行,这对课堂演示、课件素材、博客示例来说极其方便。
**main**** 方法作为标准示例入口。** 把「怎么用」写进代码本身,而不是写进文档。文档会过期,可运行的 main 不会。
众包驱动的算法清单扩张。 借助 Hacktoberfest 等活动的流量,仓库持续吸收来自全球贡献者的实现。这种模式保证了广度(冷门算法也有人补),也带来了质量参差——所以静态检查门禁不可省略。
Gitpod 一键环境。 对只想改几行代码试试看的学习者,这比「装 JDK、装 Maven、配 IDE」的路径友好得多。
七、工具链或生态
工具链是一套非常标准的 Java 开源组合,没有花活:
# 1. 克隆仓库
git clone https://github.com/TheAlgorithms/Java.git
cd Java

# 2. 编译全部算法
mvn -q clean compile

# 3. 跑单个算法的单元测试(以冒泡排序为例)
mvn -q test -Dtest=BubbleSortTest

# 4. 提交前的完整校验:编译 + 测试 + Checkstyle + PMD + SpotBugs
mvn verify

# 5. 直接运行某个算法的 main 方法,观察输出
java -cp target/classes com.thealgorithms.sorts.BubbleSort
- **Maven + **
**pom.xml**:唯一构建入口,统一 JDK 版本、依赖与插件配置。 - Checkstyle(
**checkstyle.xml**):格式与命名规范,是新手 PR 被打回的最常见原因。 - PMD(
**pmd-custom_ruleset.xml**** +**pmd-exclude.properties**)**:代码坏味道扫描,白名单用于放过教学场景下刻意为之的写法。 - SpotBugs(
**spotbugs-exclude.xml**):字节码级缺陷检测,重点是空指针与资源泄漏模式。 - GitHub Actions(
**build.yml**):把上述检查搬到 PR 上,形成强制门禁。 - Codecov:覆盖率看板,用于观察测试覆盖趋势而非追求数字。
- Gitpod:云端开发环境,降低首次贡献的摩擦。
值得称道的是排除清单的显式化:
pmd-exclude.properties和spotbugs-exclude.xml把「哪些告警我们不修」写成了版本化配置,而不是靠口头约定。这在众包项目里是成熟做法。
八、部署与安全
这个项目没有部署环节。交付物就是源码库本身,没有可执行服务、没有二进制发布、没有运行时攻击面。所谓「部署」,对使用者而言就是把需要的类复制走或加进自己的项目。
安全相关的讨论集中在两点:
其一,许可。MIT 许可非常宽松,允许商用、修改、再分发,只需保留版权声明。这意味着你可以把这些实现抄进自己的代码库,但要注意随之而来的质量责任——MIT 不提供任何担保。
其二,用途边界。README 明确写了实现面向教育。ciphers 包里的 AES/DES 教学实现尤其需要注意:它们用于理解算法流程,通常不包含侧信道防护、填充校验、密钥管理等生产必需环节,绝不能用于真实加密场景。同理,datastructures 里的容器实现也不保证线程安全。
pmd-exclude.properties 与 spotbugs-exclude.xml 的存在说明维护者对静态扫描结果是认真对待的:每一条豁免都是显式决策,而不是关掉规则了事。
九、适用场景
- 算法与数据结构课程学习:配合教材逐章对照,是最直接的用法。看到伪代码看不懂时,读一遍可运行的 Java 实现往往就通了。
- 面试准备的实现对照:刷题时对照标准实现,检查自己的边界处理、循环不变量是否写对。
- 教学课件与示例素材:单文件、可运行、无依赖,非常适合直接嵌入讲义或博客。
- 开源贡献入门:任务粒度小、验收标准清晰(能编译、过检查、有
main),是新手理解 PR 流程的低风险练习场,这也是它常年出现在 Hacktoberfest 话题下的原因。 - 跨语言对照:TheAlgorithms 组织有 Python、C++、Go 等多语言分支,同一算法横向对比不同语言的表达方式,是很有意思的学习角度。 不适合的场景同样明确:不要把整包当依赖引入生产项目,不要指望它提供性能优化过的实现,也不要指望它有一致的 API 抽象。
十、总结评价
这个仓库的真正价值,不在于「实现了多少算法」,而在于它把算法学习这件事的可执行性做到了极致。传统教材给你伪代码,博客给你片段,而这个仓库给你一个能 git clone 下来、mvn compile 之后逐个运行的完整集合。当你对某个算法有疑问时,「改一行、跑一遍、看输出」的反馈速度,远胜于在纸上推演。
它的社区数据也说明了这套模式的可持续性:67k stars 不是靠某个技术突破换来的,而是靠低门槛贡献 + 严格但自动化的门禁这套组合长期滚出来的。这对任何想做「内容型开源仓库」的团队都是一份可参考的治理样本——用工具替代人工评审,用索引替代搜索,用 main 方法替代文档。
适用人群:在校学生、转行学习者、需要教学素材的讲师、想练手 PR 流程的新贡献者。
局限性也要说清楚:代码风格与质量在不同包之间并不均匀,同一个算法可能有多个版本并存;缺少统一的抽象层,无法作为库使用;性能不是目标,部分实现的时间复杂度常数项明显偏大;随着文件数量增长,DIRECTORY.md 的维护成本会持续上升,索引与代码不同步是这类仓库的长期隐患。
一句话定位:它是一份索引化、可执行、可持续生长的 Java 算法教材,而不是一个你可以依赖的算法库。把它当教材读,价值最大;把它当依赖用,会失望。