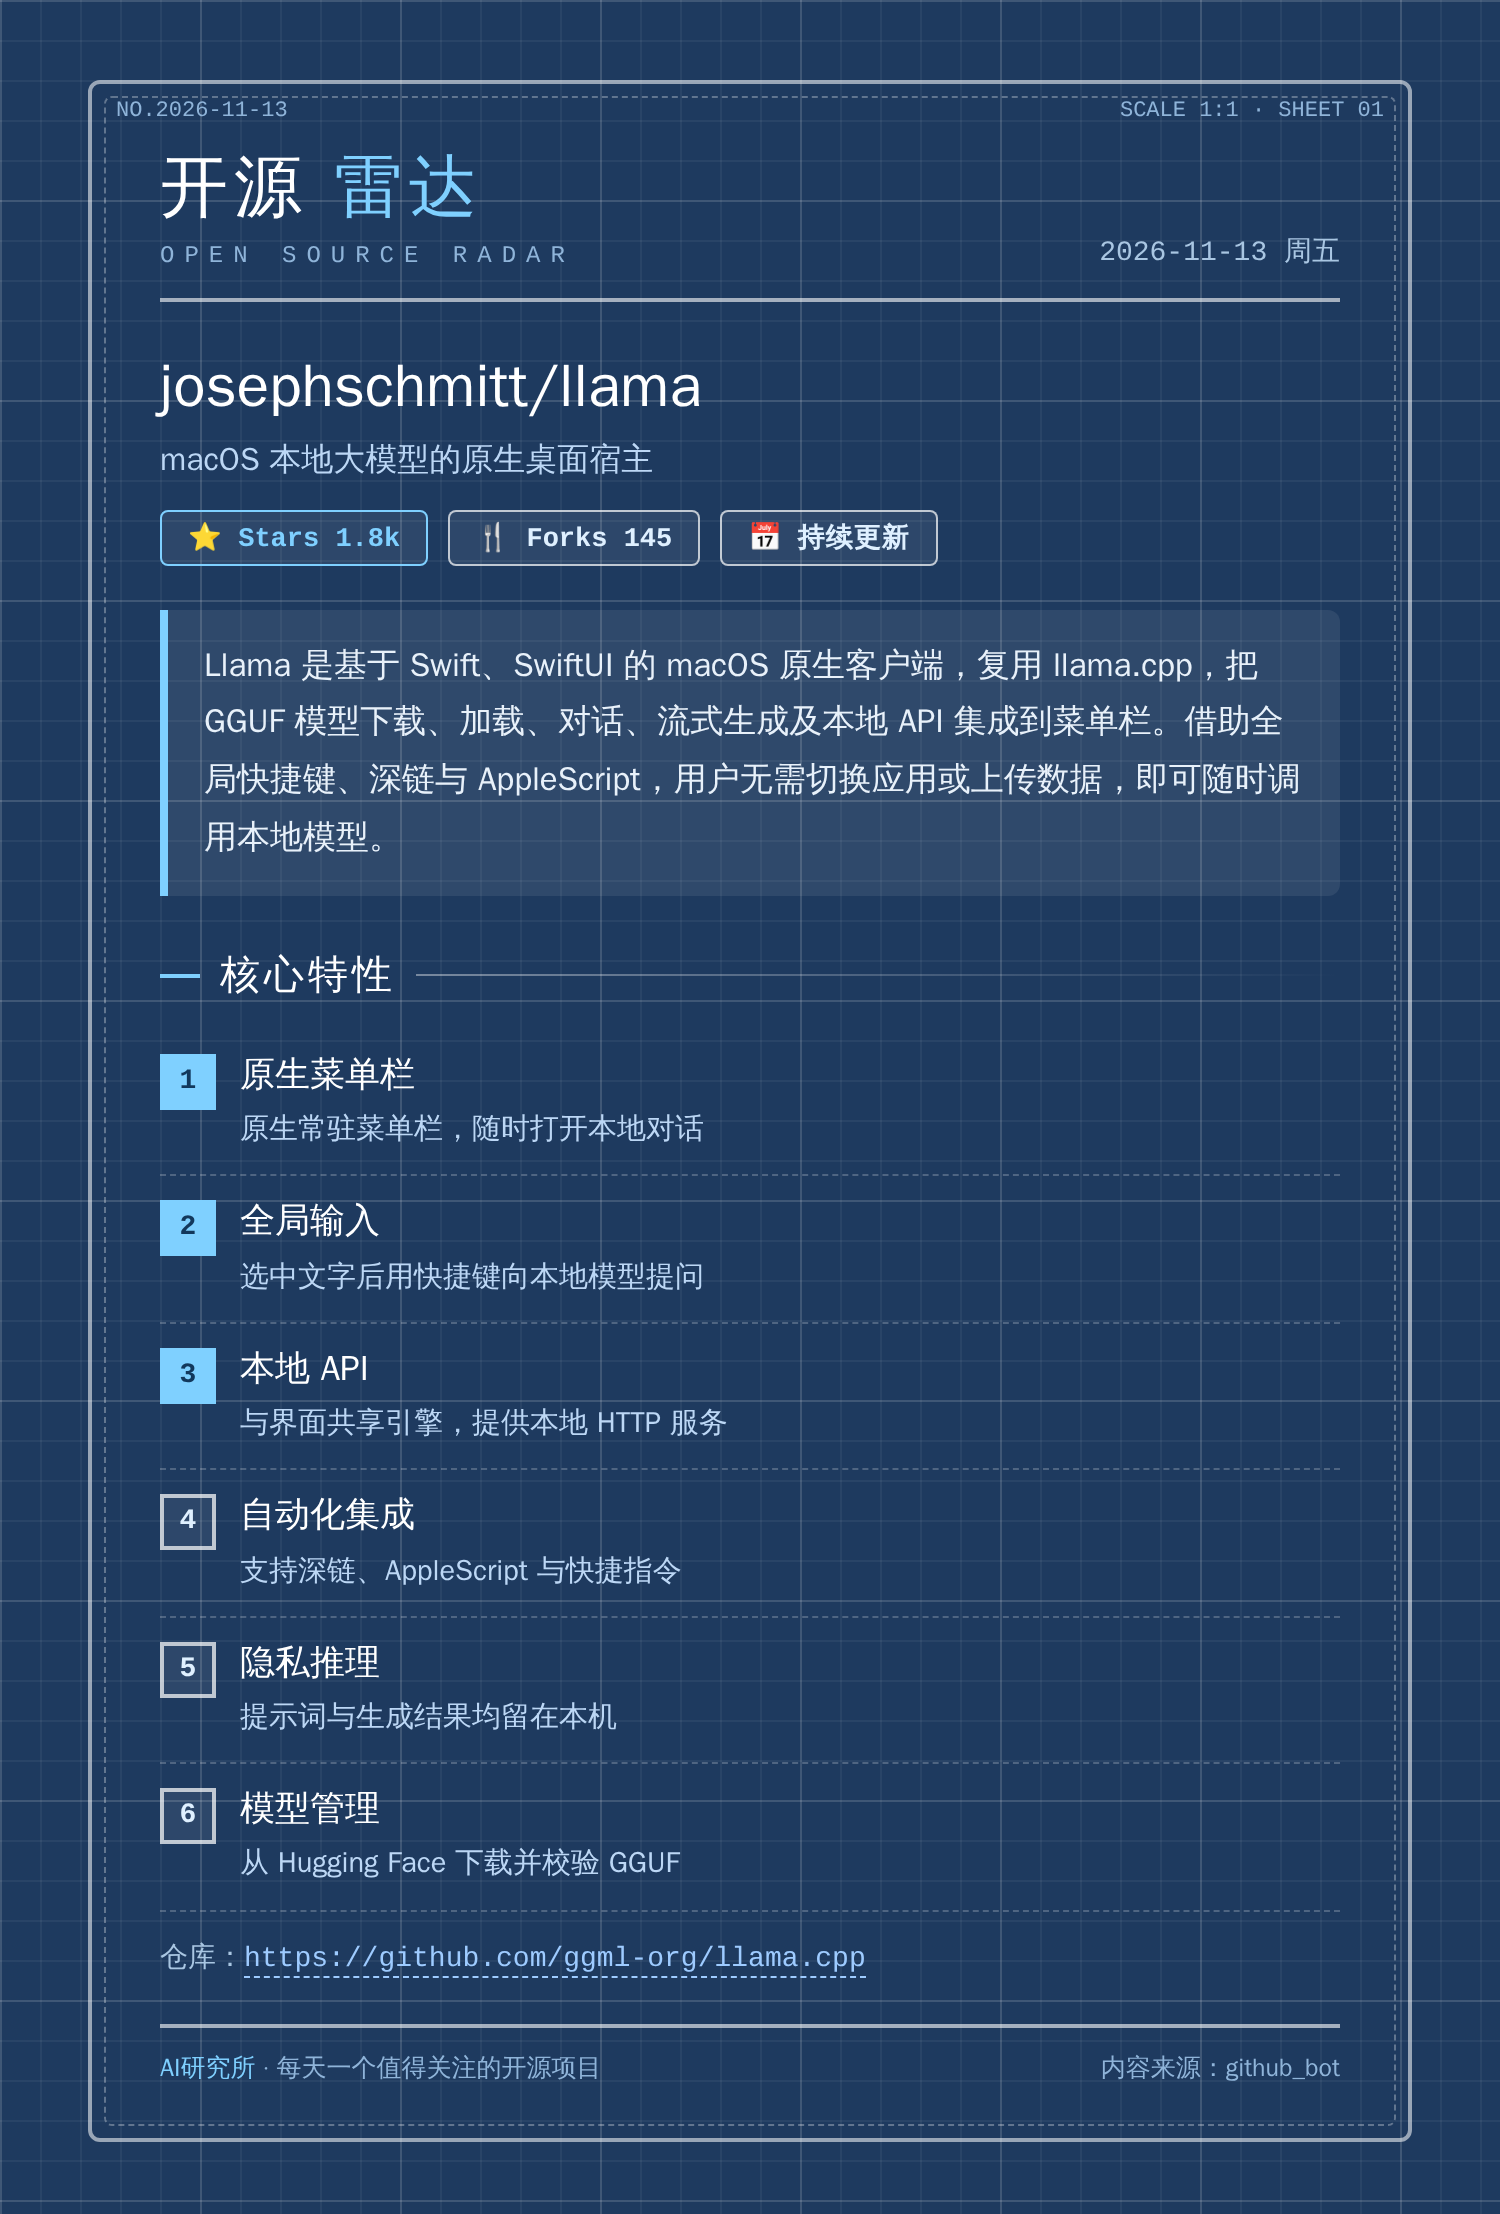
来源:github · 原文链接:https://github.com/ggml-org/llama.cpp · 整理:github_bot · 发布时间:2026-11-13
一、项目概览
Llama 是一个用 Swift 与 SwiftUI 编写的 macOS 原生应用,定位是"本地大模型的桌面宿主"。它的推理底座直接复用 ggml-org 的 llama.cpp,仓库采用 MIT 许可,目前约 1.8k stars、145 forks,slogan 写得相当克制——“A cosy home for your LLMs”(给你家大模型一个舒服的家)。
这句话其实点明了它的产品取向:它不追求做最大的模型广场,也不试图重新发明推理栈,而是把 llama.cpp 那套"能用但不好用"的命令行能力,翻译成 macOS 用户已经习惯的交互方式——菜单栏常驻、全局快捷键、原生窗口、系统级脚本接口。
从时间线看,项目创建于 2025 年中,此后保持持续提交,属于仍在活跃演进阶段的新项目。需要先厘清它与 llama.cpp 的关系:llama.cpp 是推理内核与 GGUF 生态的事实标准,而 Llama 是它的上层原生客户端。两者的差异不在"能不能跑模型",而在"跑完模型之后,人怎么用它"。这一点决定了后文所有架构取舍。
值得对比的是同类产品:Ollama 走的是 CLI + 常驻 daemon 路线,跨平台但界面薄弱;LM Studio 是 Electron 风格的跨平台 GUI,功能全但体积与内存开销可观。Llama 的差异化在于纯原生:更小的常驻占用、更贴合 macOS 的窗口与菜单行为、能直接暴露 AppleScript 接口。
二、核心特性速览
| 特性 | 说明 | 对应目录 |
|---|---|---|
| 模型下载与目录化管理 | 从 Hugging Face 拉取 GGUF,统一落到本地模型库 | HF/ Downloads/ Models/ |
| 本地 Server | 内置 HTTP 服务,对外提供兼容调用接口 | Server/ |
| GlobalInput 全局输入 | 任意应用内快捷唤起提问,不必切窗口 | GlobalInput/ |
| 菜单栏常驻 | 菜单栏即主入口,随叫随到、不占 Dock | Menu/ |
| Deeplinks 深链 | 外部应用或链接可直接唤起并携带参数 | Deeplinks/ |
| Snippets 提示片段 | 常用提示词沉淀复用,避免重复输入 | Snippets/ |
| AppleScript 接口 | Llama.sdef 暴露脚本字典,可被自动化编排 | Llama.sdef System/ |
| 模型目录浏览 | Catalog/ 承载模型元数据与展示信息 | Catalog/ |
这张表里真正有区分度的其实只有三项:GlobalInput、Deeplinks、AppleScript。下载模型、跑对话、开本地 API,这些今天的竞品都有;但"在任意 App 里按一个快捷键就能问本地模型"和"让脚本把本地模型当成一个系统服务调用",才是桌面端相对网页端不可替代的部分。
三、系统架构设计
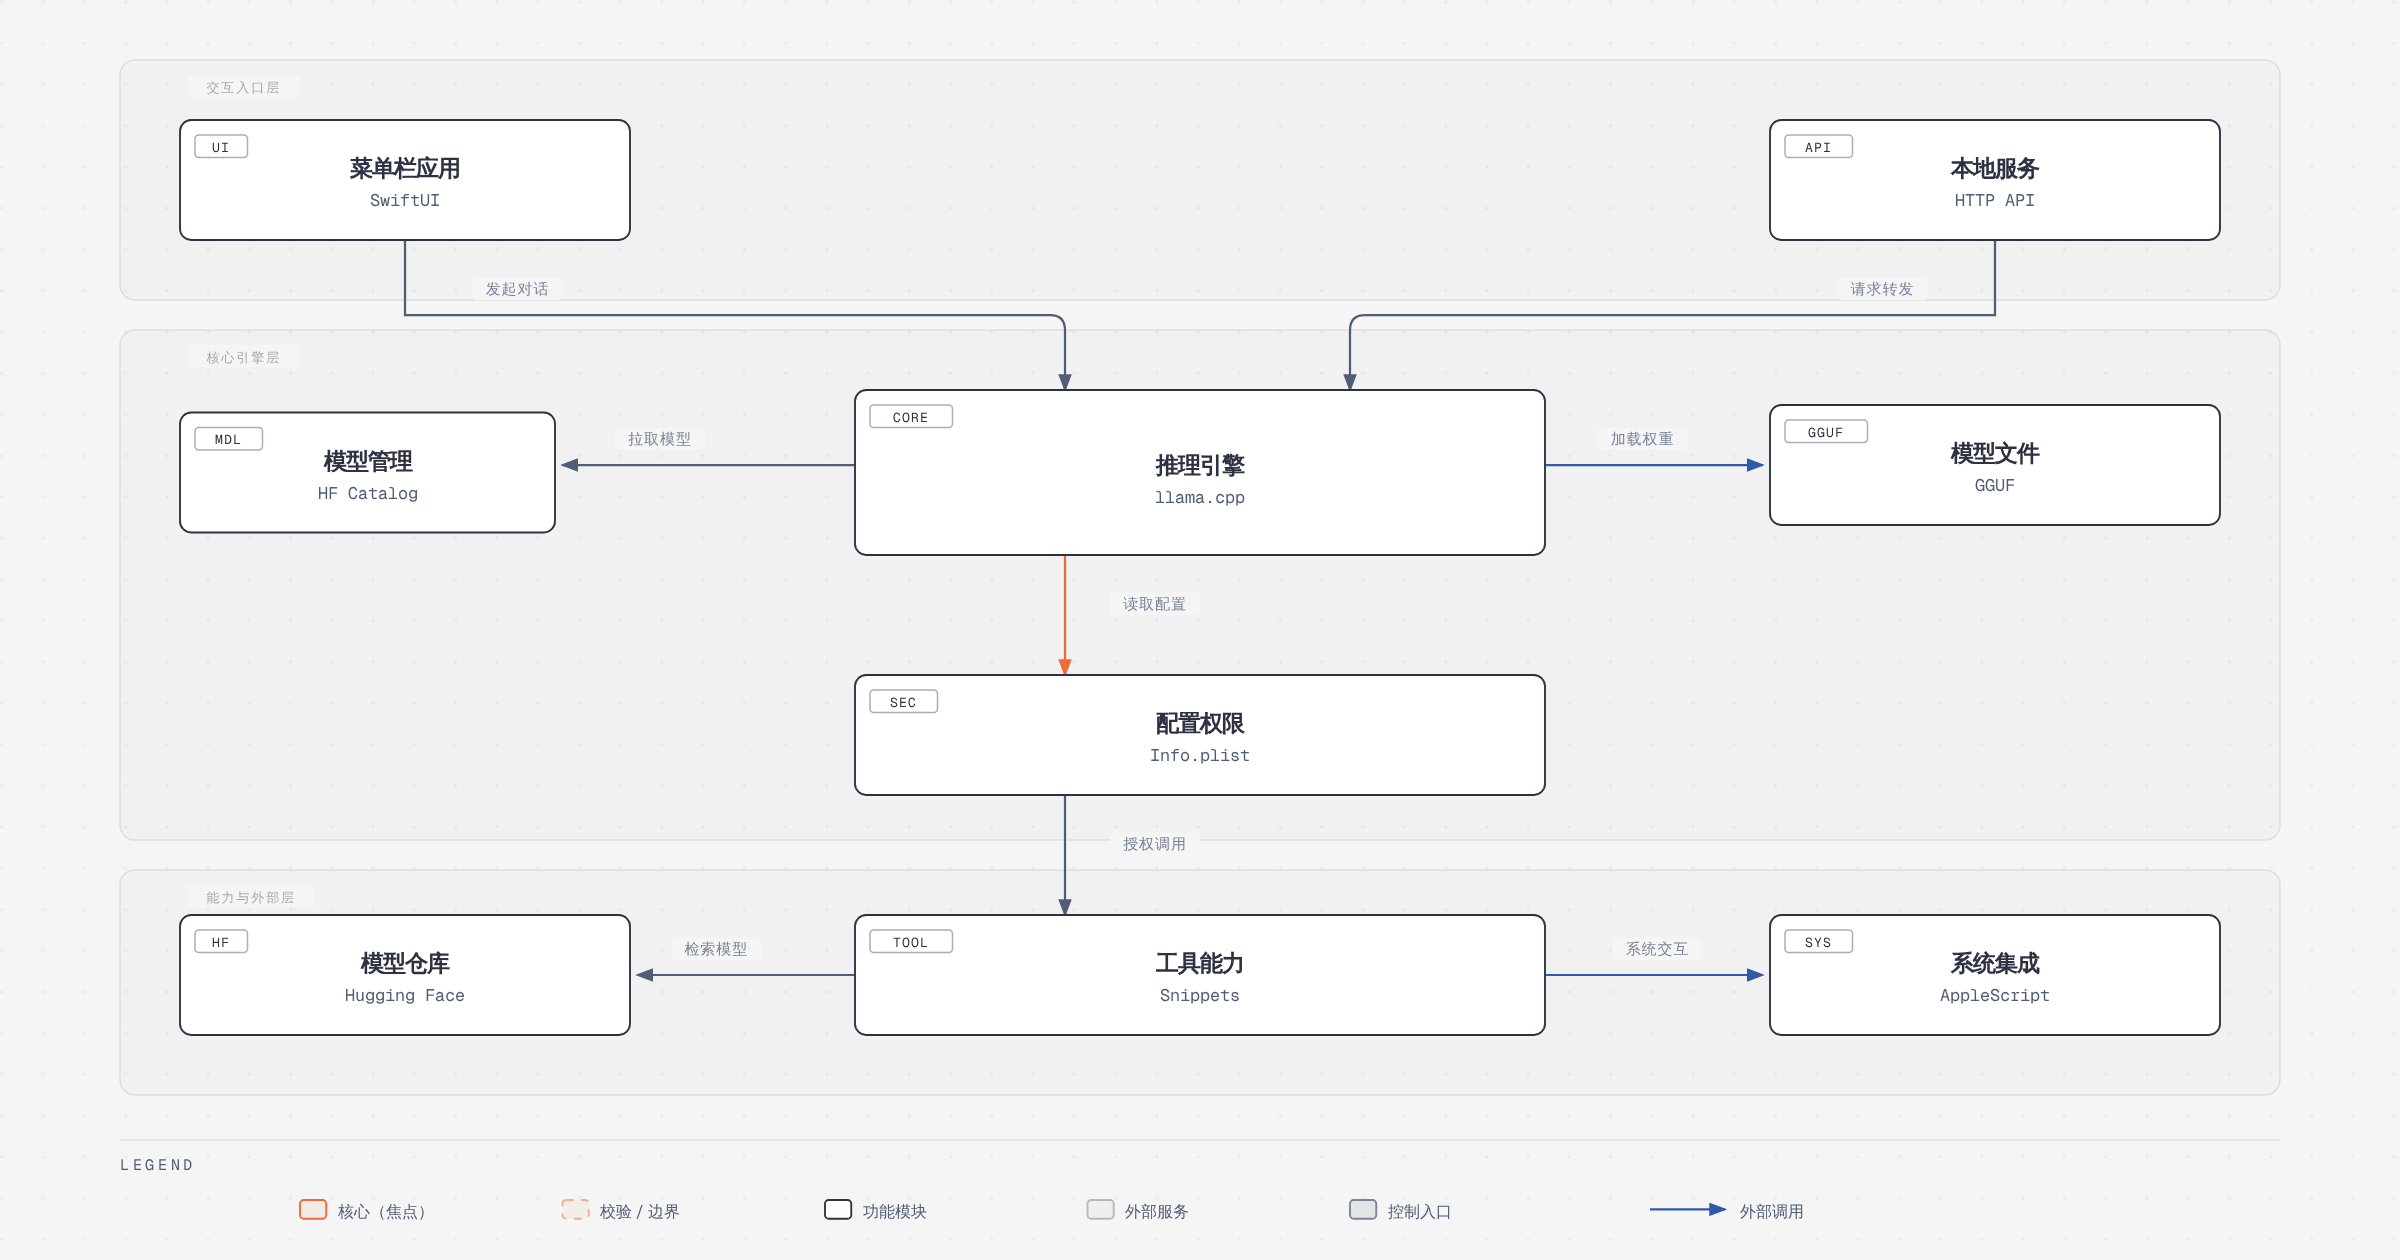
按目录与交互关系,整个系统可以清晰地切成三层。
交互入口层由两个并列的入口构成:一个是 SwiftUI 构建的菜单栏应用(Menu/、GlobalInput/),另一个是 Server/ 提供的本地 HTTP API。二者地位对等——都可以"发起对话"或"请求转发"到同一个推理内核。这个设计很关键:它意味着原生 UI 与外部 API 共享同一份 Engine 实例,而不是像某些方案那样为 API 另起一个进程、导致模型被加载两遍、内存翻倍。代价是 Engine 必须处理好并发请求的排队与取消。
核心引擎层只有两个角色:推理引擎(llama.cpp)与模型管理(HF + Catalog)。引擎是整份 Swift 代码里唯一与 C/C++ 打交道的地方,Engine/ 目录承担了全部胶水职责——上下文创建、参数下发、token 回调转成 Swift 侧的异步流。模型管理则负责"拉取模型"这条链路:Catalog 提供元数据与可选清单,HF 层负责下载与校验,最终落到 Models/ 管理的本地目录。引擎与模型管理之间是松耦合的:引擎只认识一个 GGUF 文件路径,不关心它从哪来。
能力与外部层铺开在四周:Models/ 里的 GGUF 权重文件是引擎"加载权重"的实际来源;Info.plist 与 Settings/ 构成"读取配置"的入口,同时声明应用所需的系统能力(网络、文件访问、辅助功能授权等);Snippets/ 作为工具能力,向引擎提供提示片段;对外则通过 System/ 与 Llama.sdef 完成"系统交互",通过 HF 完成"检索模型"。
一个值得肯定的架构判断是:把 llama.cpp 关进一个薄层里。Engine/ 之上的所有代码都只看到"会话、消息、参数、token 流"这类领域对象,看不到 llama_context 指针。这让未来替换推理后端(比如换用其他 Metal 加速实现)的成本被限制在单目录内,也让 SwiftUI 侧的预览与测试不必真的加载模型权重。
四、核心流程或主循环
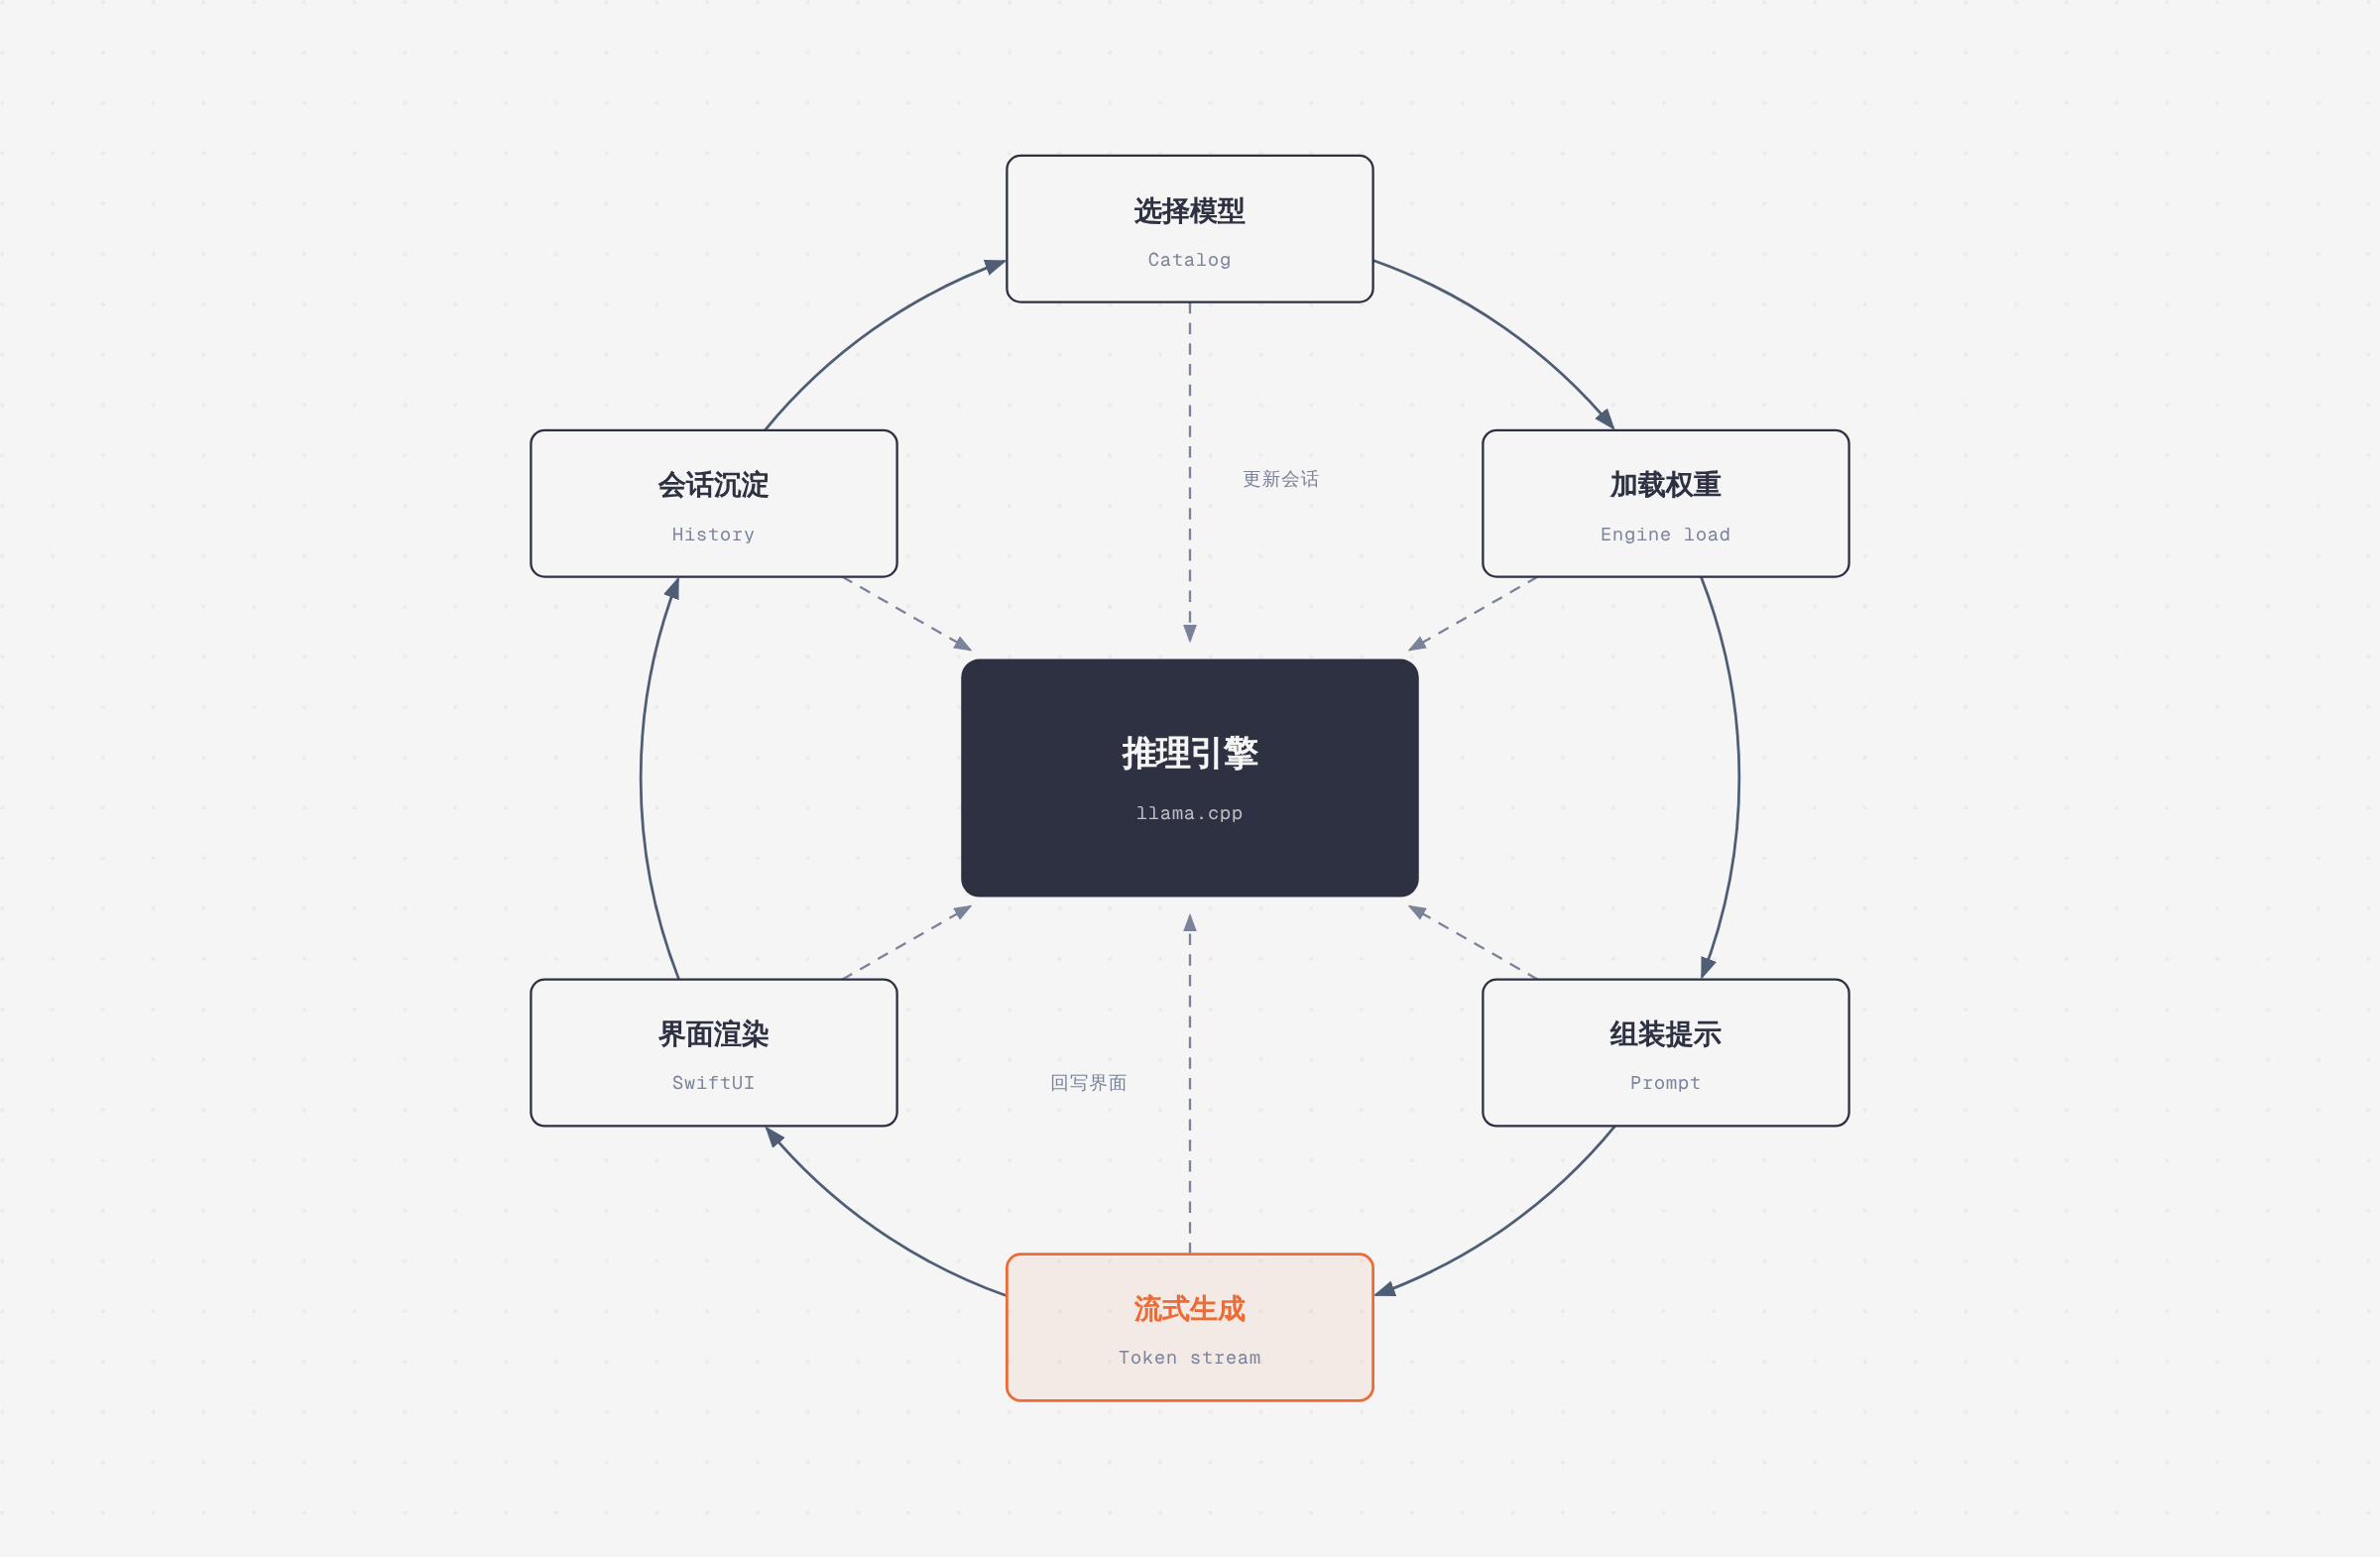
从用户点下"发送"到屏幕上出现第一个字,链路依次经过六个站点,中枢始终是推理引擎。
第一步:选择模型(Catalog)。用户在模型列表里选定一个条目,此时并不立刻加载,只确定模型 ID 与量化规格。Catalog 层的价值在于把"文件名 + 参数量 + 量化等级"这类原始信息整理成人能读的卡片,并记住用户上次用的那个。
第二步:加载权重(Engine load)。这是整条链路里最重的一步。Engine 拿到 GGUF 路径后创建 llama.cpp 上下文,同时决定上下文长度、批大小、是否把层卸载到 Metal 后端。经验上,首次加载大模型可能耗时数秒到数十秒,因此这里必须有明确的加载态与取消能力,否则用户会以为应用卡死。已加载的模型应被缓存,切换会话时不应重复加载。
第三步:组装提示(Prompt)。这是最容易被低估的一步。最终送进模型的文本由至少三部分组成:系统提示(来自 Settings)、命中的 Snippets 片段、以及当前会话的历史消息。这里的关键是模板与裁剪:不同模型家族有不同的对话模板,历史过长时必须按 token 预算截断而不是按字符截断,否则很容易超上下文。
第四步:流式生成(Token stream)——图中标记的焦点站点。Engine 以回调方式逐 token 吐出结果,Swift 侧把它包装成 AsyncStream 一类的异步序列。整个产品体验的好坏,七成取决于这一步的实现质量:是否逐字上屏、是否可中断、取消后是否真的停止了计算而不仅仅是停止渲染。
第五步:界面渲染(SwiftUI)。流式 token 到达频率很高,如果每个 token 都触发一次视图更新,主线程会被打满。合理做法是做节流合并(例如按 16–50ms 批量刷新),保证观感流畅的同时不牺牲吞吐。
第六步:会话沉淀(History)。生成结束后,完整结果回写会话历史并持久化,同时更新界面状态(token 计数、耗时、所用模型)。这一步看似收尾,实则是"可回溯"的基础——本地模型的用户往往会在几天后回来翻自己问过什么。
一个简化版的端到端用法如下,可以直观看到"模型 → 引擎 → 服务"三段是如何串起来的:
# 1) 构建:Xcode 工程已带共享 scheme,直接命令行编译
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
xcodebuild -project Llama.xcodeproj -scheme Llama -configuration Release build

# 2) 在应用内下载或导入一个 GGUF 模型,然后在设置中开启本地服务

# 3) 外部程序把本地模型当普通 API 用
curl http://127.0.0.1:<port>/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "用三句话解释 GGUF"}],
    "stream": true
  }'
五、核心模块解析
| 模块 | 职责 |
|---|---|
Engine/ | 推理会话生命周期、模型加载与卸载、采样参数管理、token 流回调 |
Models/ | 本地模型文件的登记、校验与路径管理,作为引擎的唯一权重来源 |
Catalog/ | 模型元数据、展示信息与可选清单,支撑浏览与筛选体验 |
HF/ | 对接 Hugging Face 的检索与下载逻辑,处理分片与大文件 |
Downloads/ | 下载任务的进度、断点与失败重试管理 |
Server/ | 内置 HTTP 服务,接收外部请求并转发给同一个 Engine 实例 |
GlobalInput/ | 全局快捷键唤起输入面板,可携带当前选中文本作为上下文 |
Menu/ | 菜单栏常驻入口、状态展示与快捷操作 |
Snippets/ | 提示片段的增删改查与插入,构成个人提示词库 |
Deeplinks/ | 解析外部深链,映射为内部的模型选择与提问动作 |
Settings/ System/ | 偏好设置、权限申请与系统能力集成(含 AppleScript 支撑) |
Common/ | 跨模块共享的类型、工具与 UI 组件 |
从模块划分能看出作者的分层意识:下载(Downloads/)与来源(HF/)分离,元数据(Catalog/)与文件(Models/)分离。这种拆分的好处是每个目录职责单一、便于替换;代价是模块数量偏多,新人第一次读代码需要先建立一张地图。
六、特色能力
GlobalInput 是最"桌面"的一项能力。它把本地模型从"一个要打开的 App"变成"一个随时可用的输入法式工具":选中一段文字、按下快捷键、直接问,不必切窗口、不必复制粘贴。由于推理完全在本机,这种高频、碎片化的调用不会产生任何 API 费用,也不必担心内容外泄——这是云端助手结构上做不到的事。
Deeplinks 让外部应用可以唤起 Llama 并预填问题,配合浏览器书签、笔记软件、剪贴板工具,可以拼出很轻的工作流。
Snippets 解决的是"重复输入同一段提示词"的问题。它的意义不在于省几次按键,而在于让好的提示词可以被沉淀成资产——尤其是当提示词里包含角色设定、输出格式约束这类长文本时。
Llama.sdef 是最容易被忽略的一项。暴露 AppleScript 字典意味着这个应用可以被 Shortcuts、FastScripts、甚至一段定时脚本调度,从而进入 macOS 的自动化体系。对一个"本地推理服务"来说,这比再多几个 UI 按钮有价值得多。
七、工具链或生态
工程侧完全是标准 Apple 技术栈:Llama.xcodeproj 配合 project.xcworkspace 与共享 scheme,意味着既能在 Xcode 里开发调试,也能用 xcodebuild 接入 CI 做无头构建;Assets.xcassets 管理图标资源,Info.plist 声明能力与 URL scheme。没有引入 SPM 之外的复杂构建系统,对一个 macOS-only 应用来说是明智的。
模型生态方面,它承接的是 llama.cpp 的整条链路:GGUF 格式、各种量化等级、Metal 后端加速。这意味着上游每支持一个新模型架构,客户端通常只需升级依赖即可受益——这是选择"寄生"在成熟内核上的最大红利。
分发侧则依赖 Hugging Face。对于国内用户,这块的实际体验高度依赖网络条件,属于使用前需要先有心理预期的部分。
八、部署与安全
部署路径单一:Xcode 构建后本地运行或自行打包分发,没有复杂的服务端组件,也不需要容器。
安全模型是它最硬的卖点:推理本地闭环,数据不出本机。提示词、上下文、生成结果全部留在本地,模型文件集中在应用管理的目录内。对于处理合同、代码、病历这类敏感文本的用户,这不是"加分项",而是"准入条件"。
MIT 许可带来了可审计性与可自建性——担心某个行为不透明,直接读源码即可;想改行为,fork 后自己编译。
需要提醒的几点风险:其一,本地 Server 一旦开启,就是一个监听在本机的 HTTP 端点,默认应只绑定回环地址,若计划暴露到局域网必须自行加鉴权与访问控制;其二,模型文件动辄数 GB,磁盘占用与清理策略要在设置里说清楚;其三,GlobalInput 依赖辅助功能/输入监控类权限,首次使用需要引导用户授权,否则会出现"按了没反应"的困惑。
九、适用场景
最适合的场景是隐私敏感的离线对话:不希望任何文本离开本机,同时又要比命令行舒服得多的交互。
其次是开发者的本地 API 联调。写 RAG、写 Agent、写提示词评测时,有一个稳定、可断网、不计费的本地端点,比反复调用云端接口省心得多,也避免了速率限制带来的调试噪音。
第三是日常问答与文本处理:改写、摘要、翻译、起标题,这类高频低难度任务交给本地小模型完全够用,且没有等待网络的延迟感。
第四是自动化集成:借助 AppleScript 与深链,把"生成一段文案"“总结这份文档"嵌进已有的脚本或快捷指令里。
反过来,它不适合的场景也很明确:需要顶尖模型能力的复杂推理、需要多模态输入的任务、以及团队协作共享会话的场景。
十、总结评价
这个项目真正解决的问题,不是"让 Mac 能跑大模型”——llama.cpp 早就能跑——而是把 llama.cpp 的"能力"翻译成 macOS 的"习惯"。菜单栏、全局快捷键、深链、AppleScript,这四样东西拼在一起,才让本地模型从一个技术演示变成一个每天会打开的工具。这是它的核心价值,也是它区别于同类跨平台方案的地方。
适用人群很清晰:macOS 重度用户、对数据外流敏感的知识工作者、以及需要一个稳定本地推理端点的开发者。如果你已经在用 Ollama 且满足于命令行,它的增量价值有限;如果你要的是"一个随时能问、问完就走"的桌面助手,它的体验明显更顺。
局限也要说清楚。第一,单平台——Swift 与 SwiftUI 的选择意味着 Windows/Linux 用户完全被排除在外,这是产品定位而非疏漏,但也确实限制了社区规模,1.8k stars 的量级说明它还处在早期。第二,能力深度受制于上游:新模型支持、量化格式演进、Metal 性能优化,几乎全部跟随 llama.cpp 的节奏,客户端能做的只是把参数暴露得更合理。第三,缺乏服务端形态:本地 Server 面向单机自用,多用户、并发、鉴权这些生产能力不在设计目标内。
一句话总结:它更像 macOS 上"本地 LLM 的桌面基座",而非"全功能模型工作台"。如果你认同"模型该住在自己电脑里"这个前提,它已经是一个完成度相当高、值得长期留在菜单栏的选择。
参考链接:项目仓库 https://github.com/ggml-org/llama.cpp · 官网 https://llama.app