来源:github · 原文链接:https://github.com/louislam/uptime-kuma · 整理:github_bot · 发布时间:2026-11-14
一、项目概览
Uptime Kuma 是一个以 MIT 许可开源的自托管 uptime 监控工具,作者是 louislam。项目于 2021 年 7 月创建,至今在 GitHub 上累计约 93.8k stars、8.7k forks,是自托管监控领域社区规模最大的项目之一。技术栈上,服务端为 JavaScript(新版本代码中已大量引入 TypeScript 文件),前端是 Vue 3 + Vite 构建的单页应用,界面基于 Bootstrap 5 风格组件体系,整体通过 Socket.IO 而非传统 REST 接口完成前后端数据同步。
README 中作者的动机写得非常坦白:市面上的自托管方案(如 statping)不够稳定或已停止维护,而 Uptime Robot 这类 SaaS 无法自托管;顺带还想练手 Vue 3、Vite、Bootstrap 5,以及"用 WebSocket 替代 REST API"的 SPA 实践。这段自述其实解释了项目的气质——它不是从企业级可观测性平台的需求倒推出来的架构,而是从**“一个人也能装、装了就能用”**的产品直觉出发,再逐步补齐工程能力。这一点贯穿了它的功能取舍、部署方式和性能边界,也是理解这个项目最重要的前提。
二、核心特性速览
| 维度 | 能力 |
|---|---|
| 监控协议 | HTTP(s)、HTTP(s) Keyword、HTTP(s) JSON Query、TCP、Websocket、Ping、DNS Record、Push(被动上报)、Steam 游戏服务器、Docker 容器 |
| 告警渠道 | 90+ 通知服务,含 Telegram、Discord、Slack、Gotify、Pushover、SMTP 邮件等 |
| 检查频率 | 默认 20 秒间隔,可按监控项调整 |
| 状态页 | 支持多状态页,可映射到独立域名对外展示 |
| 辅助信息 | Ping 图表、TLS 证书信息与到期提示、代理支持、2FA 登录 |
| 国际化 | 多语言界面,翻译通过 Weblate 协作维护 |
这张表里最值得注意的是 Push 类型和 Docker 容器监控。前者把 Uptime Kuma 从"主动探测者"变成"被动接收端",让 cron 脚本、批处理任务甚至 IoT 设备可以主动上报心跳,一旦超时未上报即判定异常——这覆盖了传统 HTTP 探针完全无法触达的场景。后者则把监控对象从"网络端点"扩展到"宿主上的容器状态",对于把监控工具和被监控服务跑在同一台机器上的 homelab 用户来说非常实用。
三、系统架构设计
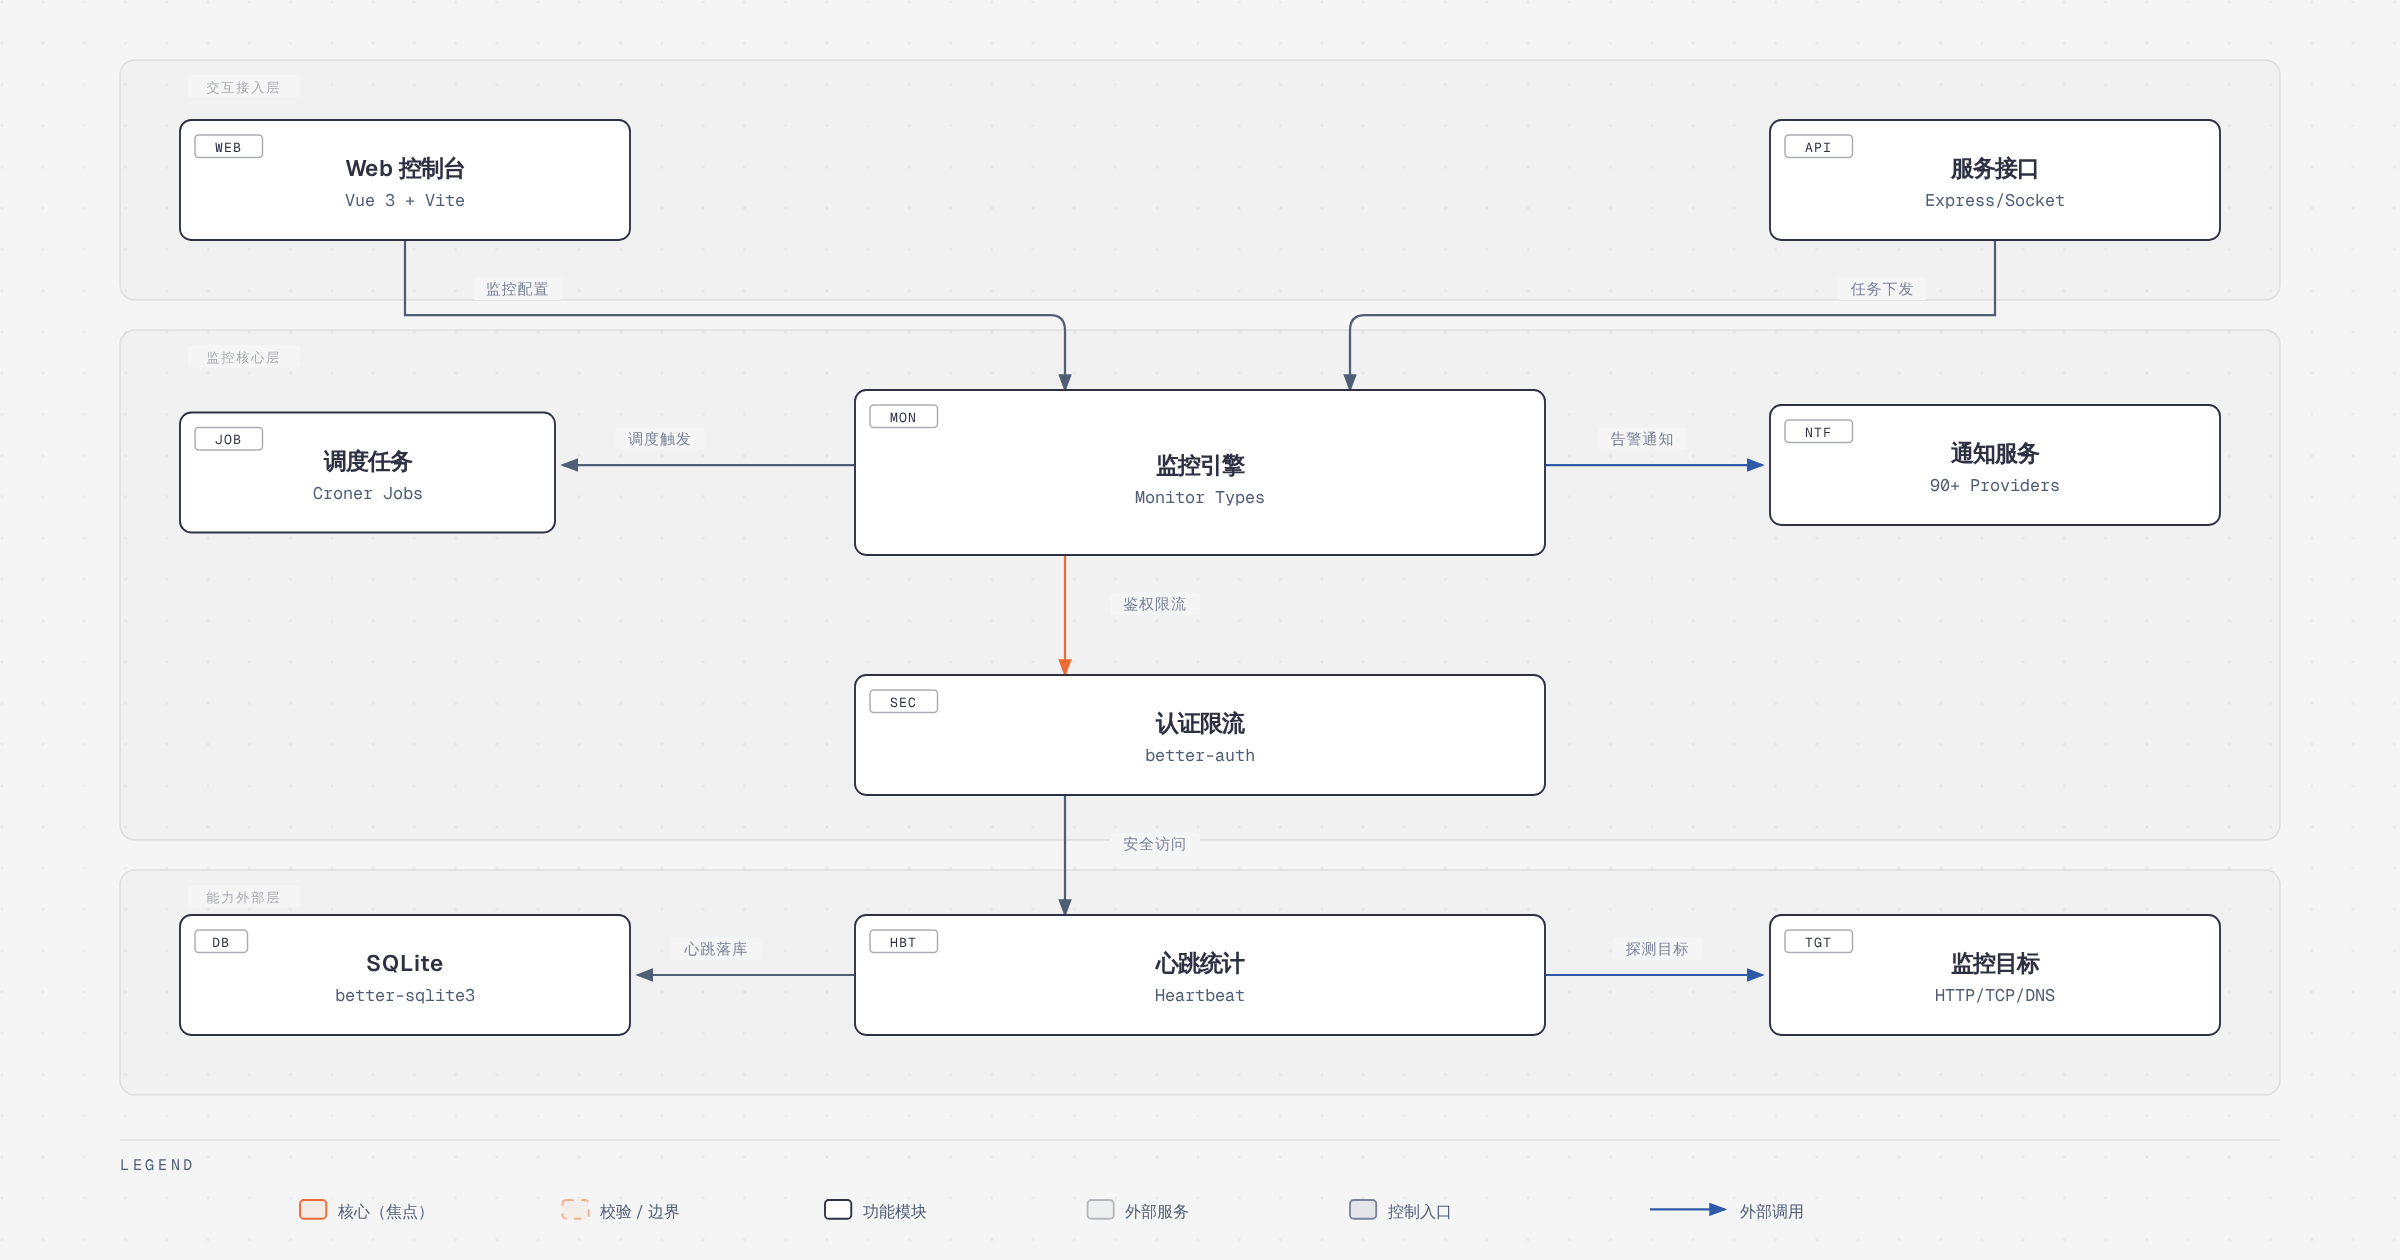
整体可以按三层来读:交互接入层、监控核心层、能力外部层。
交互接入层由 Web 控制台(Vue 3 + Vite)与服务接口(Express + Socket.IO)构成。浏览器加载的是静态 SPA 资源,之后所有交互——新增监控项、查看心跳、编辑通知渠道、订阅实时状态——都走同一条长连接。Express 只承担静态资源托管、少量 HTTP 路由(状态页、徽章、Prometheus 指标导出等)与 Socket.IO 的挂载职责。这种设计让"监控配置"的下发和"状态变化"的上推共用一条通道,避免了轮询带来的延迟与额外开销,代价是服务端必须维护连接状态,横向扩展时需要考虑 sticky session。
监控核心层是真正的重心,包含监控引擎(Monitor Types)、调度任务(Croner Jobs)、心跳统计(Heartbeat)和认证限流(better-auth)四块。监控引擎以插件形式组织:每个 server/monitor-types/ 下的模块实现同一套接口契约(检查、超时、状态判定、附加数据采集),新增协议只需要新增一个文件,而不必改动调度逻辑。调度任务由 server/jobs/ 承担,基于 Croner 维持定时器,并按监控项各自的间隔触发引擎执行。心跳统计负责把每次探测结果聚合成可用率、平均响应时间等派生指标,供图表与状态页消费。认证限流节点(v3 起迁移到 better-auth,配合 rate-limiter.js、login-lists.ts)横切在配置变更与登录路径上:从架构连线看,引擎侧的能力要经过鉴权与限流才能落到数据与目标上,这条路径保证了即使监控配置被误改,也不会立刻无节制地打向外网目标。
能力外部层包括通知服务(90+ Providers)、SQLite 存储(better-sqlite3 + Knex 迁移)和真实的监控目标(HTTP/TCP/DNS 等)。通知渠道同样是插件目录 server/notification-providers/,一个渠道一个文件、统一描述表单字段与发送方法,前端据此动态渲染配置项——这是它能快速堆到 90+ 渠道的工程原因。数据层默认单文件 SQLite,通过 Knex 管理 schema 迁移;db/ 目录下同时存在新旧两套 migration 目录,说明项目在版本演进中做过数据迁移策略的调整,而 server/embedded-mariadb.js 的出现则表明多数据库支持仍在推进。
四、核心流程或主循环
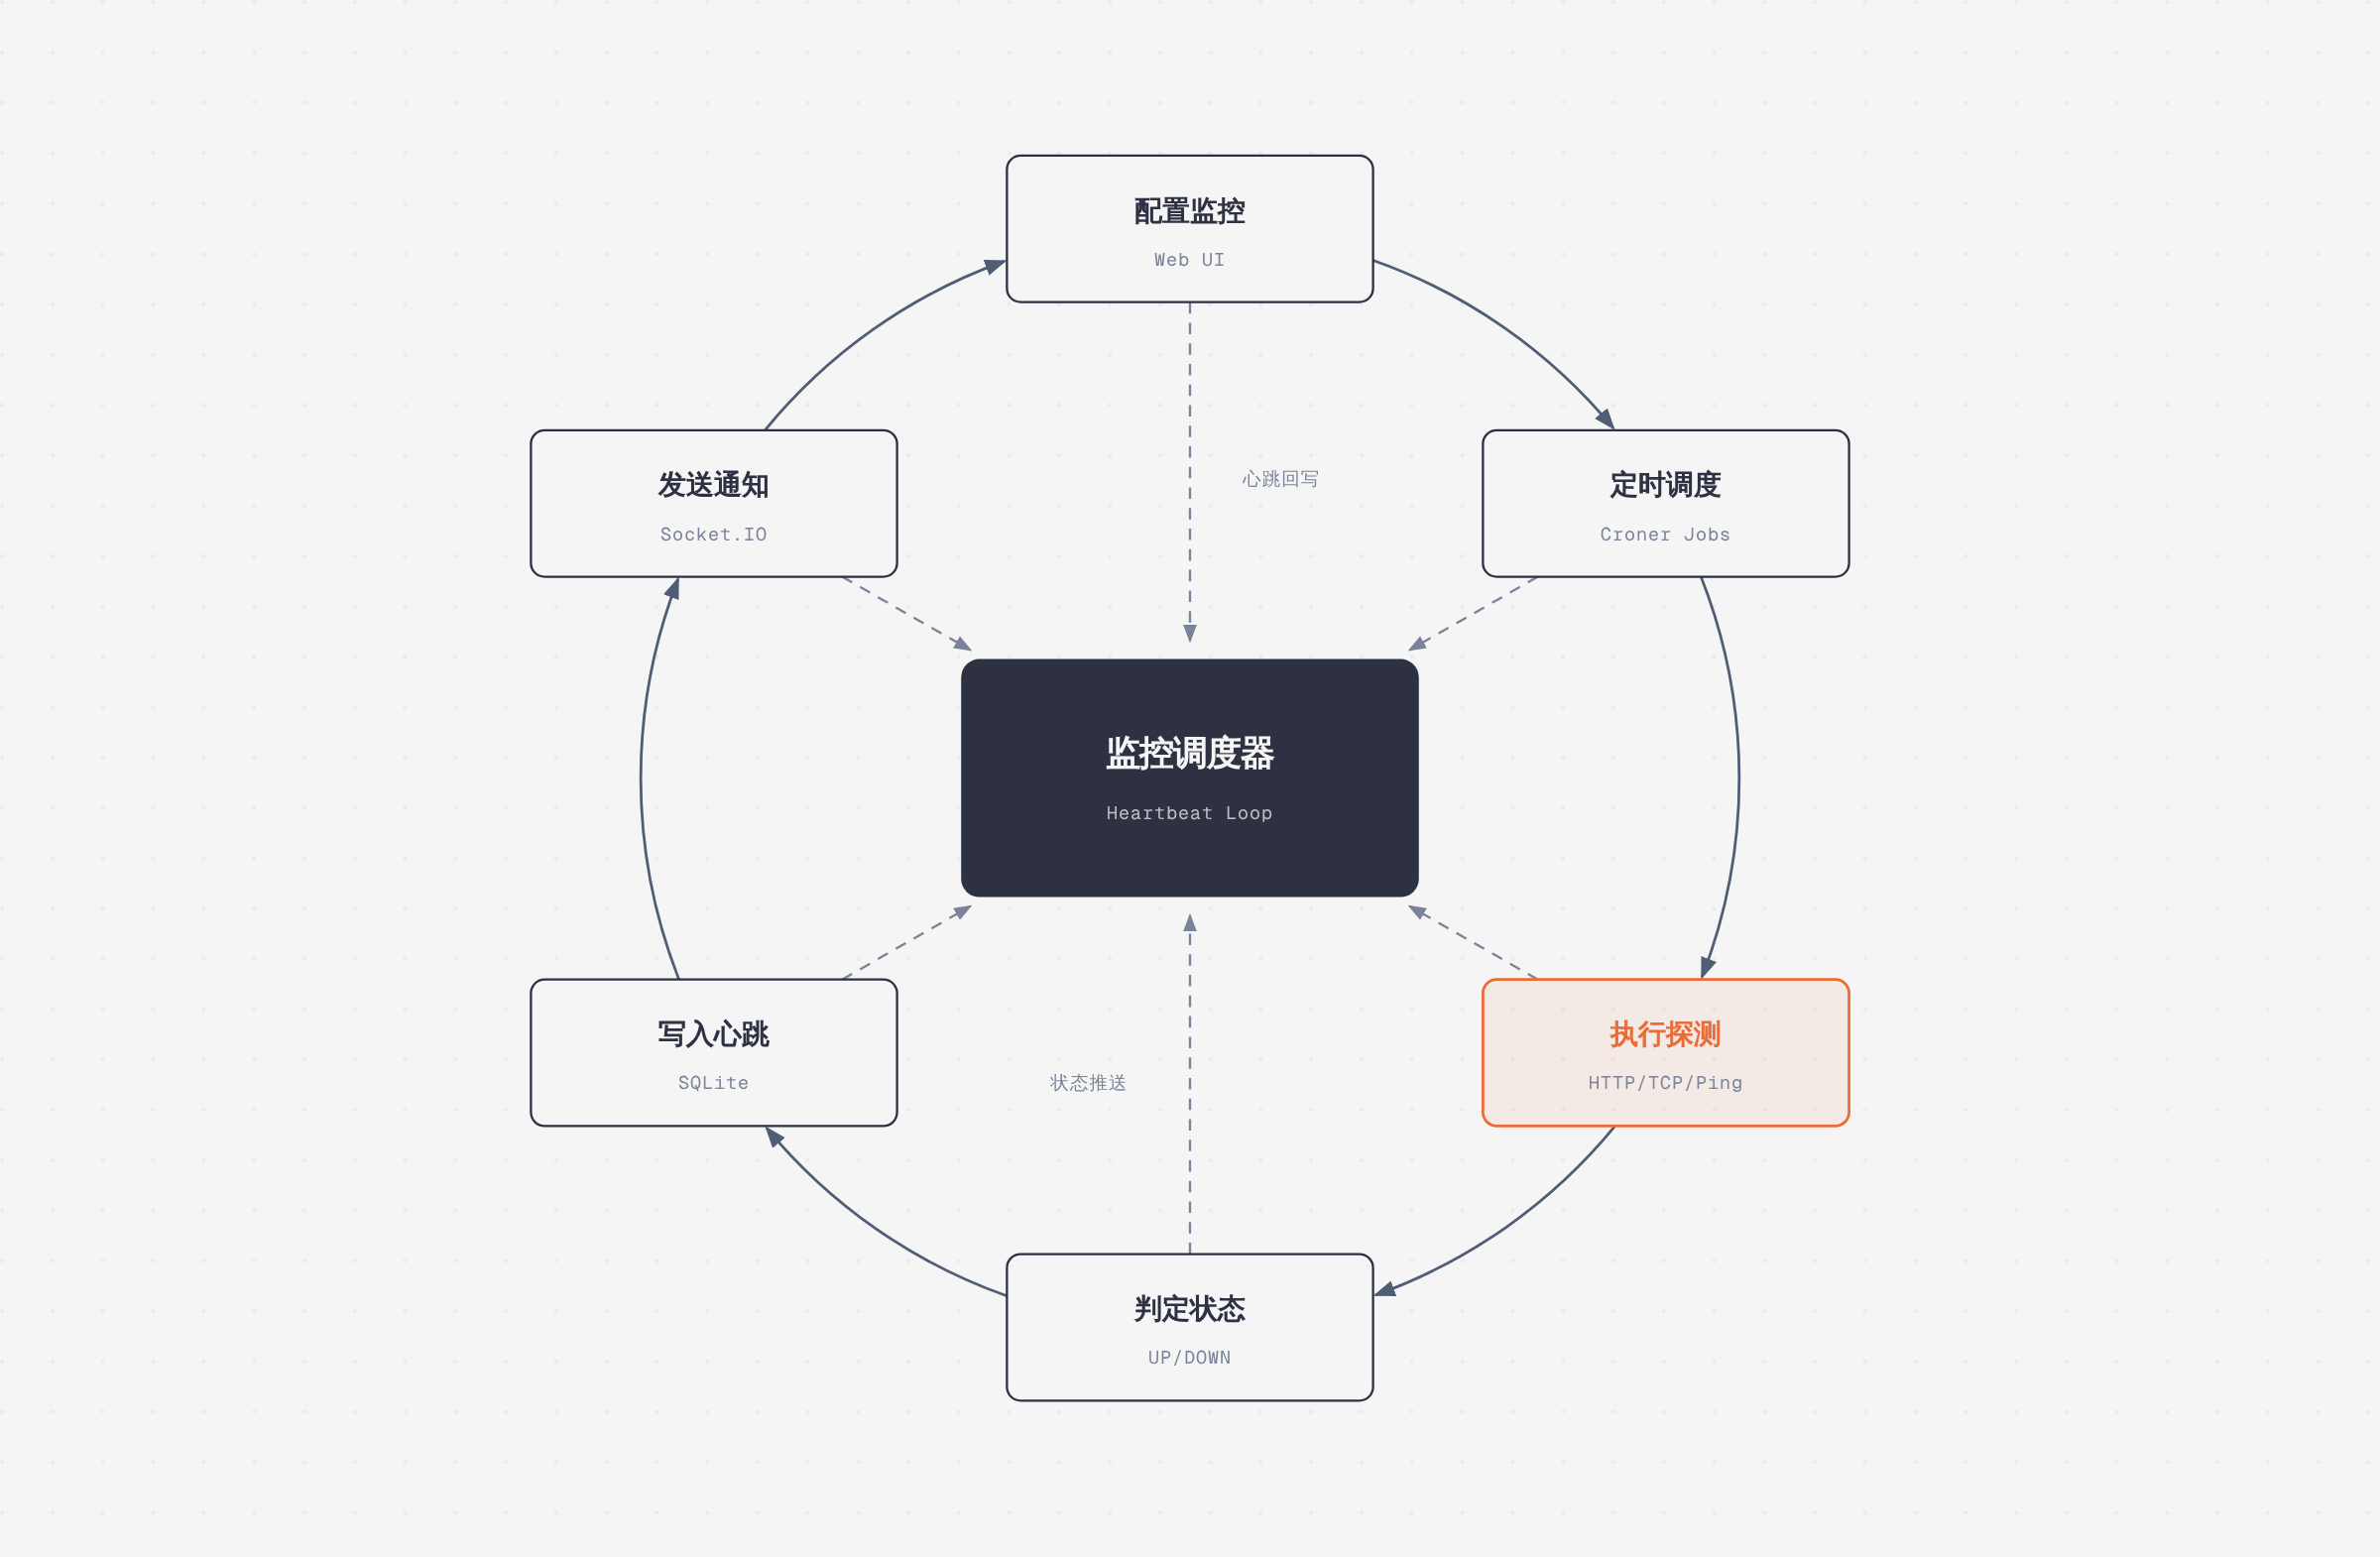
第一步:配置监控。用户在 Web UI 选择监控类型、填写目标地址、设置间隔(默认 20 秒)、重试次数、超时时间、期望状态码或关键字、关联通知渠道与代理。提交后通过 Socket.IO 事件送达服务端,服务端校验权限后写入数据库,并把该监控项注册进内存中的调度器。
第二步:定时调度。调度器为每个启用中的监控项维护独立计时器,触发粒度由监控项自身的 interval 决定,而非全局统一节拍。这样既能对关键服务做到 20 秒级检测,也能让低优先级目标保持 60 秒甚至更长间隔,减少无谓的探测量。调度器同时负责并发控制,防止同一时刻大量监控项集中触发。
第三步:执行探测。引擎根据类型分发到对应实现:HTTP 类发起请求并可选做关键字/JSON 路径断言、TLS 信息采集;TCP 类建立连接即断开;Ping 类依赖系统 ping 能力;DNS 类查询指定记录类型;Docker 类通过宿主 socket 读取容器状态;Steam 类借助 Gamedig 查询游戏服务器。每一步都可能抛出超时、证书错误、DNS 解析失败等具体异常。
第四步:判定状态。探测结果被映射为 UP / DOWN / PENDING 三态之一。这里的关键设计是重试与抖动抑制:首次失败不会立即告警,而是在配置的重试次数内连续失败才判定 DOWN,恢复时同样要求连续成功,避免网络瞬断造成告警风暴。
第五步:写入心跳。结果以 heartbeat 记录落库,同时更新聚合统计(可用率、平均响应时间、24h/30d 统计表)。图表数据、状态页展示和历史回溯都从这里来。
第六步:发送通知并推送界面。服务端先通过 Socket.IO 把心跳广播给所有打开的控制台,实现"探测完就能看到"的即时反馈;随后按监控项绑定的渠道逐个发送通知,并区分"故障发生"与"故障恢复"两种语义。
五、核心模块解析
| 模块 | 职责 |
|---|---|
server/monitor-types/ | 插件式探测实现,每种协议/目标一个模块,实现统一的 check 接口 |
server/notification-providers/ | 通知渠道实现,含字段描述与发送逻辑,前后端共用元数据 |
server/socket-handlers/ | 按业务域拆分的 Socket.IO 事件处理器,负责实时读写与权限校验 |
server/jobs/ | 定时调度与后台任务(心跳清理、统计刷新、版本检查等) |
server/model/ | 数据模型与查询封装,向上屏蔽 Knex/SQL 细节 |
src/components/ src/pages/ | 前端交互界面:监控编辑器、仪表盘、状态页、设置页 |
server/prometheus.js | 将内部状态导出为 Prometheus 指标,便于接入现有观测体系 |
值得单独说的是 server/socket-handlers/ 的拆分方式。项目没有把几十个事件塞进一个文件,而是按 dashboard、monitor、notification、status-page、maintenance 等领域分文件注册,每个文件独立声明自己关心的事件与校验逻辑。这种"按域切分的事件总线"让新增功能时改动面收敛,也降低了事件命名冲突的概率。另一个容易被忽略的是数据模型层的抽象——由于历史上支持过 SQLite 与 MariaDB(v3 又在探索内嵌 MariaDB),模型层必须避免写死某一方言的 SQL,这解释了为什么 db/ 下有 Knex 迁移体系,而 extra/ 目录里塞满了 check-knex-filenames.mjs、prepare-v2-test-db.mjs 这类校验与测试准备脚本。
六、特色能力
TLS 证书信息是实用性极高但常被低估的功能:HTTP 类监控会解析证书链并记录签发者、有效期,界面直接展示剩余天数。对个人站长而言,证书过期导致的全站不可用比服务宕机更常见,把这件事纳入监控闭环,比另装一套证书检查工具划算得多。
多状态页与域名映射把监控从"运维内部工具"推向"对外沟通工具"。你可以为不同客户或不同业务线建独立状态页,挂到各自的域名下,选择性暴露部分监控项,并附带维护窗口说明。对小型 SaaS 团队来说,这几乎省掉了一个独立状态页产品的采购。
代理支持让探测可以模拟不同网络出口,避免"服务端和被测服务在同一内网,探测永远成功"的盲区;2FA 与认证模块则回应了"监控面板暴露在公网"这一常见现实。此外,Docker 容器监控与 Steam 游戏服务器监控属于典型的"人群特化"功能——不通用,但对目标用户极其精准。
七、工具链或生态
部署路径有三条,官方推荐程度依次递减:
# 1. Docker Compose(推荐)
mkdir uptime-kuma && cd uptime-kuma
curl -o compose.yaml https://raw.githubusercontent.com/louislam/uptime-kuma/master/compose.yaml
docker compose up -d

# 2. 单条 docker run
docker run -d --restart=always -p 3001:3001 \
  -v uptime-kuma:/app/data --name uptime-kuma louislam/uptime-kuma:2

# 3. 非 Docker:Node.js >= 20.4 + PM2
git clone https://github.com/louislam/uptime-kuma.git
cd uptime-kuma && npm run setup
pm2 start server/server.js --name uptime-kuma
Docker 镜像托管在 Docker Hub 官方命名空间,Compose 文件随仓库同步更新,属于"文档即部署"的做法。非 Docker 场景依赖 npm run setup 完成前端构建与依赖安装,再用 PM2 常驻,pm2 startup && pm2 save 可接管开机自启。翻译协作走 Weblate,src/lang/ 下的语言文件由 CI 脚本(check-lang-json.js)校验键一致性。
生态层面还有两个信号值得注意:一是 extra/uptime-kuma-push/ 与 push-examples/ 提供了 Push 类型的上报示例,把"被动心跳"变成可复用的集成点;二是依赖列表中出现 @modelcontextprotocol/server、@scalar/express-api-reference、globalping 等新面孔,说明 3.0 beta 正在把监控能力往 API 化、可编程化方向推。
八、部署与安全
默认情况下容器监听 3001 端口并绑定所有网卡,公网可达。最小必要的加固是把端口收敛到本机,再由反向代理暴露:
docker run -d --restart=always -p 127.0.0.1:3001:3001 \
  -v uptime-kuma:/app/data --name uptime-kuma louislam/uptime-kuma:2
反向代理场景需要正确处理 WebSocket 升级头,否则界面会表现为"能打开但数据不刷新"——这是社区里最常见的一类求助。应用层安全依靠 better-auth 体系、rate-limiter.js(登录与敏感操作的频次限制)以及 2FA;login-lists.ts 之类的模块则用于记录与审计异常登录。
数据持久化有一条硬性约束:README 明确不支持 NFS 等网络文件系统,必须映射到本地目录或卷。原因是 SQLite 的文件锁语义在网络文件系统上不可靠,轻则写入失败,重则数据库损坏。同样地,server/docker.js 通过挂载宿主 /var/run/docker.sock 读取容器状态,这等于把宿主 root 等价权限交给容器,生产环境应权衡是否真的需要该功能——这是自托管监控典型的"便利性 vs 攻击面"取舍。
九、适用场景
中小团队的可用性看板:十几到上百个端点,需要 20 秒级检测与即时告警,不想为 SaaS 按监控点付费。独立开发者与 homelab:一台 VPS 或 NAS 上跑起来,同时监控网站、家庭网络设备、NAS 容器和定时备份任务(用 Push 类型)。面向客户的状态页:把可用性作为服务承诺的一部分对外公示,多状态页与域名映射正好覆盖。告警聚合入口:把原本散落在各处的 cron + curl 脚本,统一成带重试、带历史、带通知渠道的监控项。
反过来,以下场景应谨慎:需要多地域分布式探测来判断"是服务挂了还是我这台机器网络有问题"——Uptime Kuma 是单实例探测,天然的盲区;监控目标达到数千量级、需要水平扩展与高可用的团队——SQLite 单机写入会成为瓶颈;以及需要复杂告警路由、静默策略、值班排班的大型运维体系。
十、总结评价
Uptime Kuma 的真正价值不在于"功能多",而在于它把 Uptime Robot 级别的产品体验压缩进了 **docker run** 一条命令。90+ 通知渠道、插件式的协议与渠道扩展点、Socket.IO 带来的即时反馈,这三件事组合起来的产品完成度,是绝大多数自托管工具达不到的。它的工程取舍也足够诚实:单机 SQLite、单实例探测、内存调度器——这些选择在"一个人维护"的尺度上是正确解,而不是疏漏。
适合谁:需要快速建立可用性监控与对外状态页的中小团队、独立开发者、homelab 玩家,以及希望以 MIT 许可二次开发内部监控面板的公司。不适合谁:要求分布式探测、大规模指标吞吐和成熟告警治理体系的组织——那类需求应该走向 Prometheus + Alertmanager 或商业 APM,把 Uptime Kuma 定位成"面向人与状态的轻量看板",而不是"面向机器的时序数据库"。
最后提醒一点运维现实:自托管的另一面是自负其责。监控系统的价值恰恰在故障时刻体现,而如果它和被测服务跑在同一台机器、同一个 Docker 宿主、同一块盘上,那它大概率会在最需要它的时候一起消失。至少做到:数据卷独立备份、监控实例与被监控对象物理/网络隔离、关键告警渠道保留一条外部通道。
参考链接:项目仓库 · 官网与在线 Demo