来源:github · 原文链接:https://github.com/mvanhorn/last30days-skill · 整理:github_bot · 发布时间:2026-11-18
一、项目概览
/last30days 是一个以 Agent Skill 形态分发的跨平台研究智能体。给它一个主题——一个人、一家公司、一款产品、一场冲突——它会在 30 天窗口内并行检索 Reddit、X、YouTube、Hacker News、Polymarket、GitHub、TikTok、arXiv、Techmeme 等十余个来源,再按真实用户的互动行为(赞同票、点赞、观看量、评论数)以及真金白银定价出的市场概率排序,最后由宿主智能体综合成一份带引用的简报。
它要解决的问题很具体:各个平台各自封闭,而研究需要横向比较。Google 搜不到 X 帖子和 Reddit 热评,ChatGPT 有 Reddit 却没有 X 和 TikTok,Gemini 能看到 YouTube 却进不去 Reddit。每家平台都有自己的 API、令牌和反爬机制,于是"一次性看完所有人怎么想"变成了一件只能靠人工开十几个标签页的事。这个项目采用另一条路径:不自己造搜索引擎,而是把你自己的密钥、Cookie 和本地 CLI 交给一个智能体,让它同时打到所有平台,再把信号汇总到一起。
工程上它是 Python 3.12+ 项目,MIT 许可,当前版本 4.3.2,仓库约 6.9 万 Star、6100+ Fork。需要注意,这不是一个单体应用,而是规范层(**SKILL.md**)+ 执行引擎(**last30days.py**)+ MCP 桥接(Go 实现) 的复合体:同一个研究内核被包装成 Claude Code 插件、npx skills 通用技能、.mcpb 桌面扩展和 OpenClaw 插件。它更接近"给现成智能体装上一副跨平台感官",而不是一个面向终端用户的产品。
二、核心特性速览
| 特性 | 具体表现 | 实际价值 |
|---|---|---|
| 多源并行检索 | Reddit、X、YouTube、HN、Polymarket、GitHub、TikTok、Bluesky、arXiv、Techmeme、招聘页、专利等 | 一次运行覆盖十几个封闭平台,避免人工逐站搜索 |
| 互动度加权排序 | 按赞同、点赞、播放、评论量评分,而非 SEO 相关性 | 1500 赞同的帖子权重高于无人问津的博客 |
| 跨平台事件聚类 | Wireless Festival 官宣、X 争论、TikTok 票价信息合并为同一故事 | 消除重复,呈现事件全貌而非三份同质结果 |
| 引用行与数据行 | Reddit/X/YouTube 高赞评论单独成行;Polymarket 概率及其变化、Yahoo Finance 股价与标普 500 对照 | 结论可追溯,“谁说的、多少人认同"一目了然 |
| Secret Signals | 读取公司招聘页与当月美国专利申请,标出反常信号 | 在官方发布之前推断公司正在做什么 |
| 发现模式 | /last30days what's trending in AI agents? 输出 5–10 个按增速排序的话题 | 从"研究已知主题"扩展到"发现未知主题” |
| 资料库与监控 | library feed / library search 离线索引历史简报;--store + watchlist 定时监控 | 单次研究积累为可检索、可订阅的长期资产 |
| 结构化输出 | --emit=json 提供带版本号的 agent profile | 可嵌入脚本、CI 与自动化工作流 |
三、系统架构设计
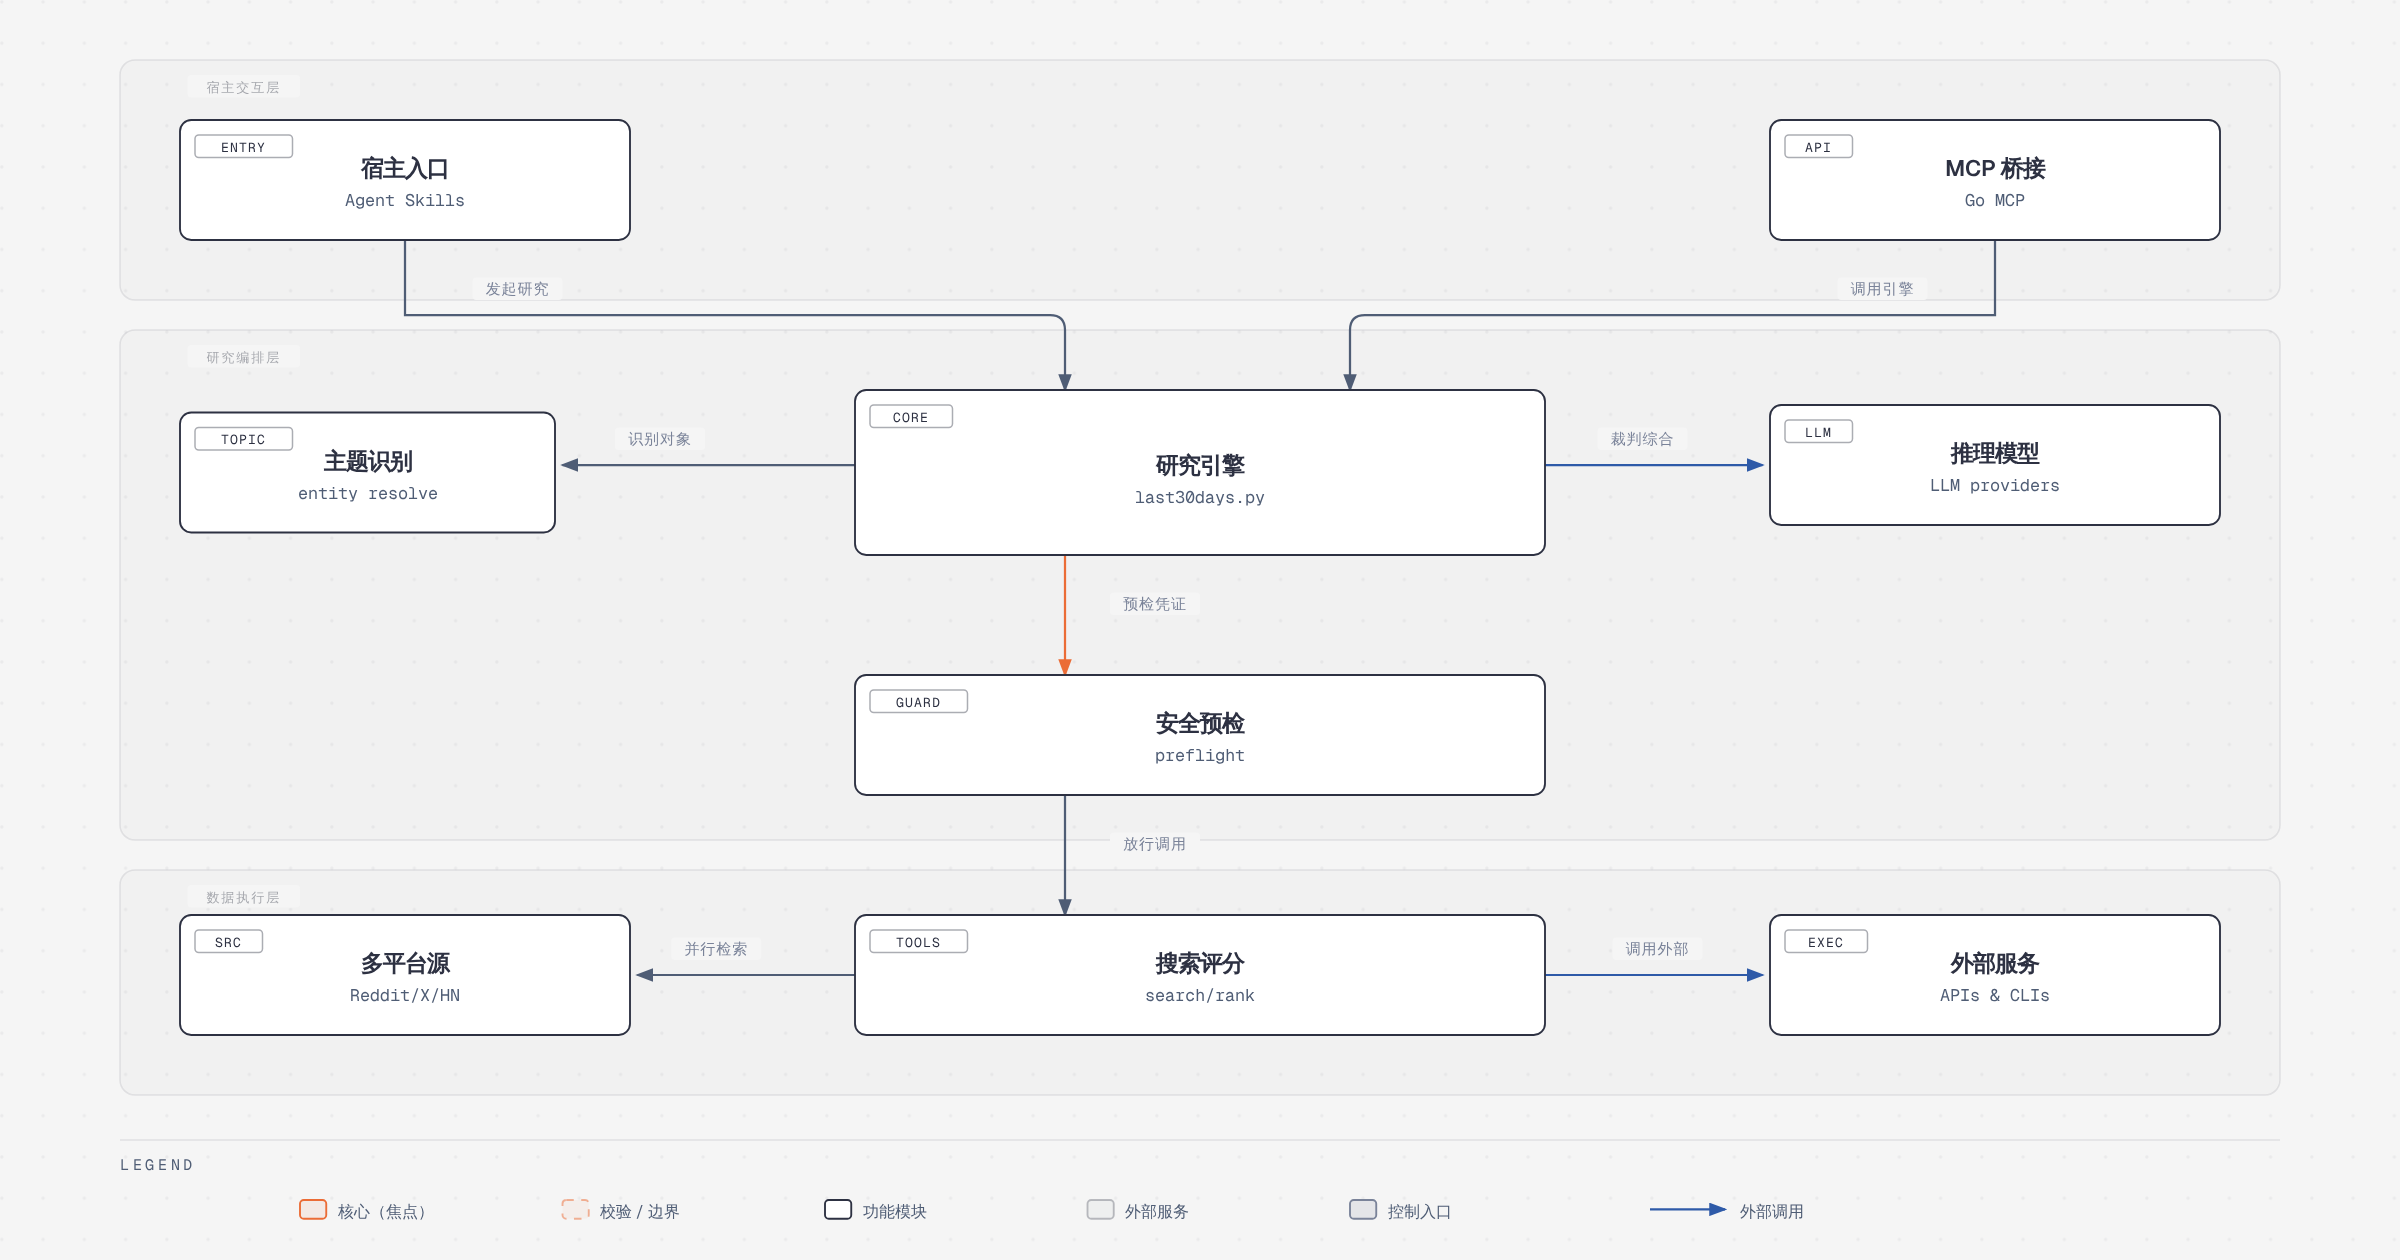
整体是清晰的三层结构,边界划得比多数"AI 搜索"项目更明确。
宿主交互层由 宿主入口 与 MCP 桥接 两个节点构成。入口是各家的 Agent Skill 机制:Claude Code 通过 marketplace 安装,Codex / Cursor / Copilot / Gemini CLI 等 50 多个宿主走 npx skills,Claude Desktop 则通过 Go 编写的 mcp/ 包以 .mcpb 形式注册一个 research 工具。这一层的设计意图是把 UI、会话管理和模型推理全部外包给宿主,项目自身不提供聊天界面。
研究编排层是真正的大脑,包含四个节点:主题识别 负责把自然语言主题解析成具体对象——X 账号(含创始人)、GitHub 仓库、subreddit、TikTok 话题标签、YouTube 频道,乃至公司对应的官网与股票代码;研究引擎(last30days.py)是总编排器;推理模型 作为裁判负责相关性重排与最终综述;安全预检(--preflight)在真正开跑前展示配置来源、Cookie 方案、计划写入的文件与被忽略的项目配置,但不读取 Cookie、不写文件、不执行研究。
数据执行层分为 搜索评分 与 多平台源 / 外部服务。这里有一个值得称道的工程取舍:绝大多数平台适配被下沉到独立的 CLI 包装器(digg-pp-cli、arxiv-pp-cli、techmeme-pp-cli、yahoo-finance-pp-cli、trustpilot-pp-cli),引擎只负责探测 PATH 中是否存在、调用、归一化结果。核心引擎因此不必为每个平台背一份认证代码,新增数据源的成本被压到"写一个 CLI"。
一条隐含的设计原则贯穿全图:安全预检 位于 搜索评分 之前,放行调用 是一道真实的关卡。先确权、再出网,这在需要携带浏览器会话 Cookie 的工具里是必要的克制。
四、核心流程或主循环
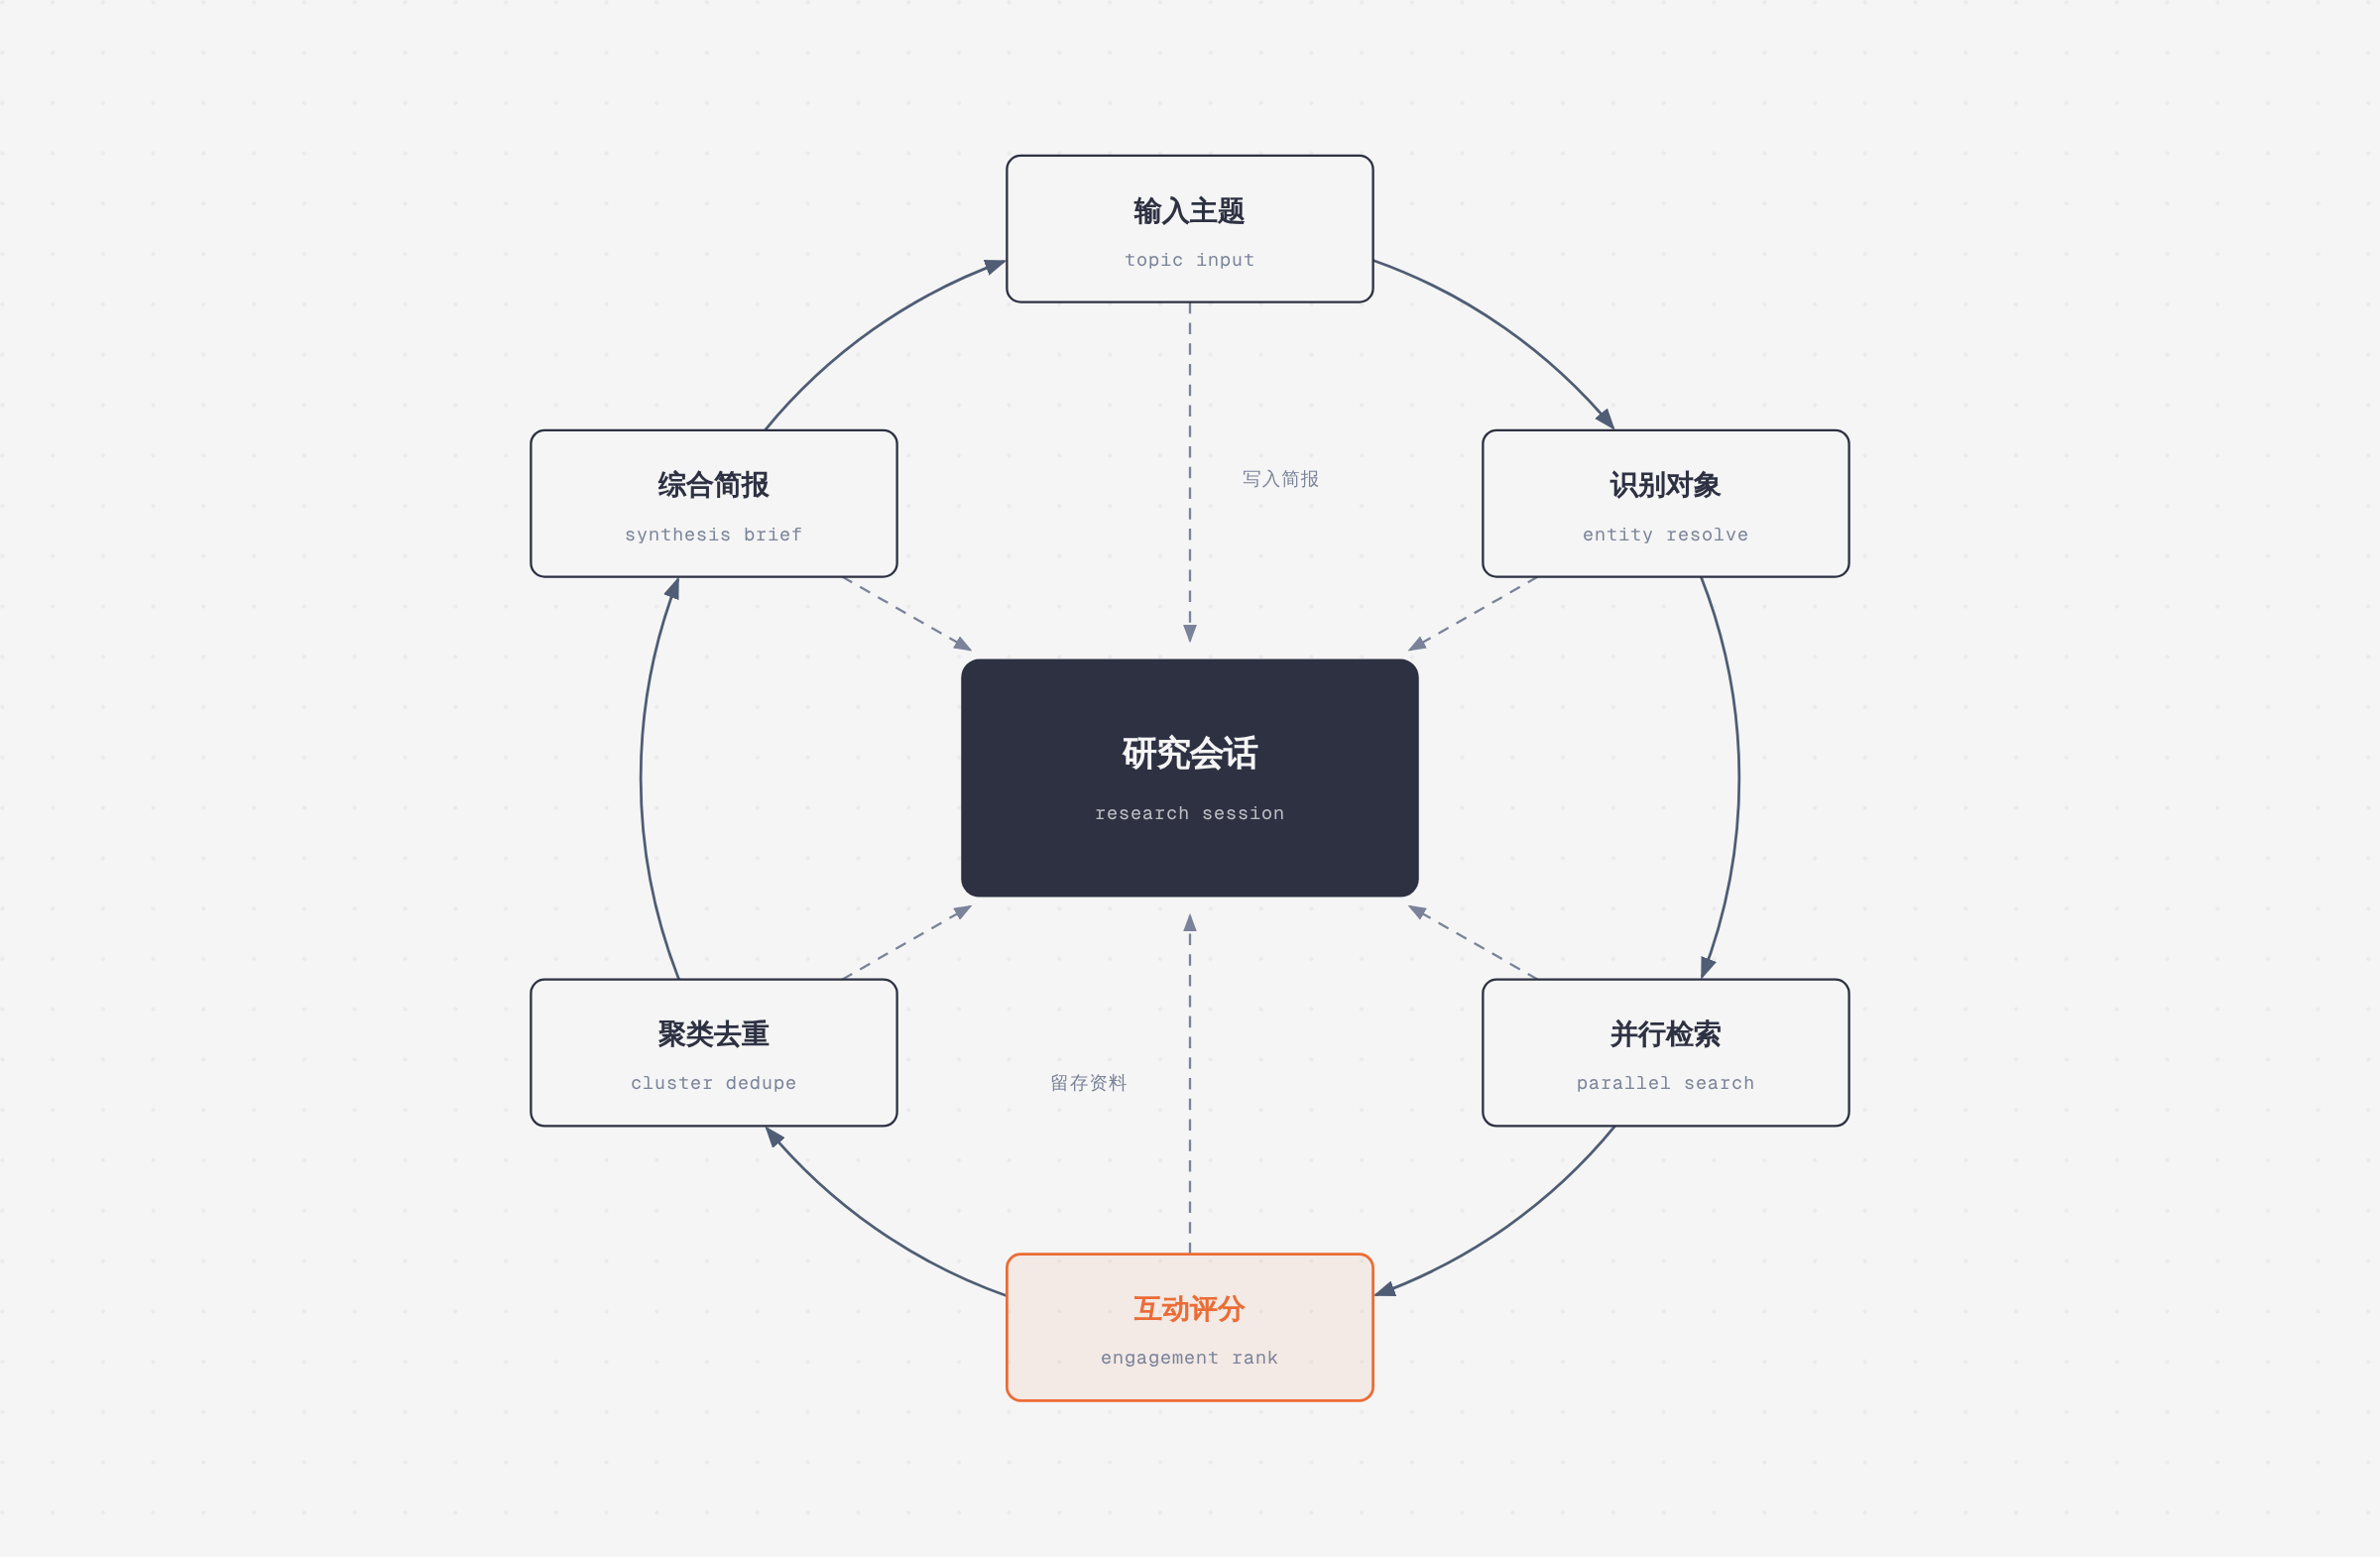
主流程是一条六站流水线,研究会话 作为中心枢纽,两个出口分别是"写入简报"与"留存资料"。
第一步,输入主题。 用户输入自然语言,可以是 /last30days Peter Steinberger,也可以是 OpenClaw vs Hermes vs Paperclip 这类对比式查询。主题形态决定了后续走哪条流水线:人物、公司、产品、技术、事件、对比,各有不同的检索策略。
第二步,识别对象。 这是决定结果质量的关键一步。搜 “Kanye West” 时,引擎需要知道该查 r/hiphopheads、@kanyewest、YouTube 上的专辑评测;搜 “OpenClaw” 时,要定位到 GitHub 仓库并拉取实时 Star 数;搜 “Apple” 时要自动映射到公司实体、官网与股票代码。对象识别错了,后面的检索全是噪音。
第三步,并行检索。 查询被扩展成多个变体后并发打到各平台。此处的差异在于获取内容的深度:拉取的是 YouTube 完整字幕而不是标题,是带赞同数的 Reddit 高赞评论而不是链接,是 TikTok 文案与互动数据、Polymarket 概率,而不是搜索结果摘要。
第四步,互动评分(流程重心)。 结果按互动度、相关性、新鲜度三维打分。这是整个系统的价值观落点——排序依据的是"人们真正参与过的内容",社会相关性优先于关键词相关性。若有推理密钥,主题与片段会交给推理提供商做语义重排;没有则退化到本地评分模型,不发起外部调用。
第五步,聚类去重。 同一事件在不同平台的碎片被合并成一个故事簇。这一步决定了简报读起来像"一件事的多方视角",而不是"十个平台的搜索结果罗列"。
第六步,综合简报。 智能体裁判在聚类结果上写出综述,并附上引用行、概率行、股价行。会话结束后研究结论留在上下文里,用户可以继续追问、写提示词、起草邮件——一次运行把当前会话变成该主题的领域专家。出口分两路:写入简报(Markdown / JSON / HTML 资料库)与 留存资料(--store 落 SQLite,供 watchlist 与 briefing 复用)。
五、核心模块解析
| 模块 | 职责 |
|---|---|
skills/last30days/SKILL.md | 运行时规范:命令、参数、配置行为的唯一权威来源,README 明确以它为准 |
scripts/last30days.py | 主编排器:主题解析、并发调度、评分、聚类、渲染、持久化 |
| 主题识别 | 实体消歧与锚点发现:账号、仓库、subreddit、频道、股票代码、官网 |
| 搜索与评分 | 查询扩展、平台调用、互动度/相关性/时效性三维打分,可选 LLM 重排 |
| 聚类合成 | 跨平台事件合并、引用行/概率行/股价行注入、简报生成 |
| 输出层 | Markdown 快照、--emit=json 结构化 profile(带版本契约)、--json-profile=raw 内部转储 |
mcp/(Go) | MCP 服务器,向 Claude Desktop 暴露 research 工具,打包为跨平台 .mcpb |
scripts/watchlist.py / briefing.py | 周期监控与日报/周报生成,支持 Slack 与 Webhook 推送 |
library 子系统 | 离线增量索引历史简报,提供 library feed(Atom/HTML)与 library search |
| 配置安全层 | .env、进程环境、macOS Keychain 三级来源,--preflight 只读预检 |
六、特色能力
真正拉开差距的是把"间接证据"纳入研究。Secret Signals 有两类:Jobs Page Secret Signals 直接读公司自己的招聘页面(Workday、Apple、Amazon、Google、Microsoft、Netflix 等),标出泄露未公布动向的职位——比如一个"测试请求是否经由合作伙伴 API 与金融系统完成交易"的总监岗,暗示的是能替用户完成购买的助手;Patent Secret Signals 读取当月新公布的美国专利申请,只在"不符合公司一贯风格"或"描述了尚未发布之物"时才标记。两者都免费、无需密钥,只在主题是公司时触发。
市场信号是另一条差异化路线。Polymarket 概率行不只给数字,还标注变动幅度;Yahoo Finance 行给出 30 天股价涨跌并与标普 500 对比,还会指出最大单日波动。观点可以被反驳,概率和股价不太容易。
内容深度上,YouTube 走完整字幕而非标题,只提炼真正值得引用的几句;Reddit 拿到带实际赞同数的热评,经同意后还能以用户自己已登录的账号搜索以获得更多帖子与实时分数;TikTok、Instagram Reels 抓取互动数据与口播文案。这些是 Google 索引里根本不存在的内容层。
可运维性上,发现模式(无主题的趋势扫描)、--store 的 SQLite 沉淀、watchlist 的增量告警、library 的离线全文检索与 Atom 订阅,把一个"一次性查询工具"变成了可持续的情报管道。
七、工具链或生态
分发策略是这个项目最聪明的一环:不做客户端,寄生在所有主流宿主上。
# Claude Code(推荐,marketplace 自动更新)
/plugin marketplace add mvanhorn/last30days-skill
/plugin install last30days

# 通用 Agent Skills 宿主:Codex / Cursor / Copilot / Gemini CLI 等 50+
npx skills add mvanhorn/last30days-skill -g
npx skills update last30days -g

# 直接调用引擎(脚本 / CI)
python3 skills/last30days/scripts/last30days.py "AI coding agents" --emit=json
python3 skills/last30days/scripts/last30days.py --discover "AI agents"
python3 skills/last30days/scripts/last30days.py library search "MCP servers"
python3 skills/last30days/scripts/last30days.py --preflight
生态位覆盖得相当全:Claude Code marketplace、Grok Build CLI 的原生插件(.grok-plugin/ 清单,并进入 xAI 官方插件目录)、Grok Bot marketplace、OpenClaw 的 clawhub install last30days-official、claude.ai 网页版的 .skill 上传、Claude Desktop 的 .mcpb 拖拽安装,以及开发者用的符号链接手动安装。外部依赖则包括 yt-dlp(YouTube)、Node.js(内置 X 搜索的 Bird 客户端)、ScrapeCreators(TikTok/IG/Threads/Pinterest/LinkedIn)、Brave Search、Perplexity,以及一批 *-pp-cli 包装器。可选配套 TweetClaw 用于 X 侧的写操作。
八、部署与安全
零密钥基线是设计上的重要决定:Reddit(含评论)、Hacker News、Polymarket、GitHub、StockTwits、公司专利与招聘页开箱即用;arXiv、Techmeme、Yahoo Finance 由首次配置自动安装的免费 CLI 提供。X 需要 X_BEARER_TOKEN、浏览器登录态或第三方密钥;YouTube 只要 brew install yt-dlp;TikTok 系需要 ScrapeCreators(前一万次调用免费);Web 搜索用 Brave(每月 2000 次免费)。
密钥来源分三级,优先级明确:进程环境变量与 **.env** 高于 macOS Keychain,Keychain 仅作最低优先级兜底;已有其他服务名的 Keychain 项可通过不含秘密的 LAST30DAYS_KEYCHAIN_ALIASES 映射复用,而不必复制密钥。--preflight 提供"先看后跑"的路径——展示配置来源、Cookie 方案与将要写入的文件,不读 Cookie、不落盘。
数据处理默认完全本机:除所调用的搜索 API 外不外发数据,无追踪、无分析。唯一的外部推理是可选的重排环节,配置了推理提供商才会把主题与片段发出;不配就用本地模型。--store 写入的 research.db 只在本机,不会上传。值得一提的细节是 changelog.d/ 里大量 *.security.md 条目(私有 HTML 草稿、Webhook 凭据、Python 辅助进程隔离、私有趋势文件),说明安全边界是被持续审计的,而不是一次性声明。
九、适用场景
会前背调是最锋利的场景。README 里那个例子很有说服力:Google 给你 2023 年的 LinkedIn 页面,/last30days 给你这个人这个月做了什么——加入哪个团队、和谁公开争论、合并了多少 PR、社区对他的评价是英雄还是"令人难以忍受"。公司研究则叠加招聘页、专利、股价与预测市场,在财报或发布会之前形成判断。
选题发现用发现模式完成:扫描 Reddit 分类、HN 的 front/best、Digg 话题,由宿主模型命名、过滤垃圾、判断价值并写出切入角度,最后给 5–10 个带增速排序的话题和可直接执行的后续命令。决策辅助覆盖产品立项前找真实痛点、旅行前确认设施停运与排队时长、突发事件中快速对齐多方叙事。对开发者而言,/last30days Nano Banana Pro prompting 这类用法会直接产出一条可用的生产级提示词。
十、总结评价
这个项目的真正价值不在于"聚合了二十个数据源"——那只是工程量——而在于把一套研究方法的判断标准写进了代码:注意力与资金流向比编辑推荐更接近真相,跨平台互证比单点权威更可靠,可追溯的引用比漂亮的总结更值得信任。当大多数 AI 搜索还在优化"答案的流畅度"时,它优化的是"证据的密度与排序权重"。这是方法论层面的差异,也是它能在短时间内获得大量关注的原因。
分发策略同样值得学习:不做界面、不做模型、不做客户端,只做一个可被任意宿主加载的技能包。用户在自己已经习惯的智能体里获得一个新能力,项目则免费获得所有宿主的分发渠道。
适用人群很明确:需要高频做时效性调研的投研、BD、记者、内容创作者与技术选型者,以及愿意为一条命令配置密钥的开发者。局限也不该回避:所谓"开箱即用"只对 Reddit/HN/Polymarket/GitHub 成立,X、TikTok、Instagram 等最有差异化的来源都依赖密钥、浏览器会话或第三方付费服务,实际能力是随配置逐步解锁的;跨平台抓取的稳定性天然受制于各站反爬策略变化;以互动度为核心的排序会系统性放大争议性、情绪化内容与回声室效应,热度不等于正确;30 天窗口对长周期历史研究无能为力;最终简报质量仍受宿主模型能力影响,引擎提供证据,判断由模型完成。Star 数与真实使用深度之间也存在常见的偏差。
把它看作"给智能体装上一副能看穿围墙花园的眼睛"是准确的;把它当作可信的事实核查工具则越界了——它的产出是有引用支撑的情报线索,而不是结论。
参考链接:mvanhorn/last30days-skill · 运行时规范与配置见 SKILL.md 与 CONFIGURATION.md