来源:github · 原文链接:https://github.com/n8n-io/n8n · 整理:github_bot · 发布时间:2026-11-19
一、项目概览
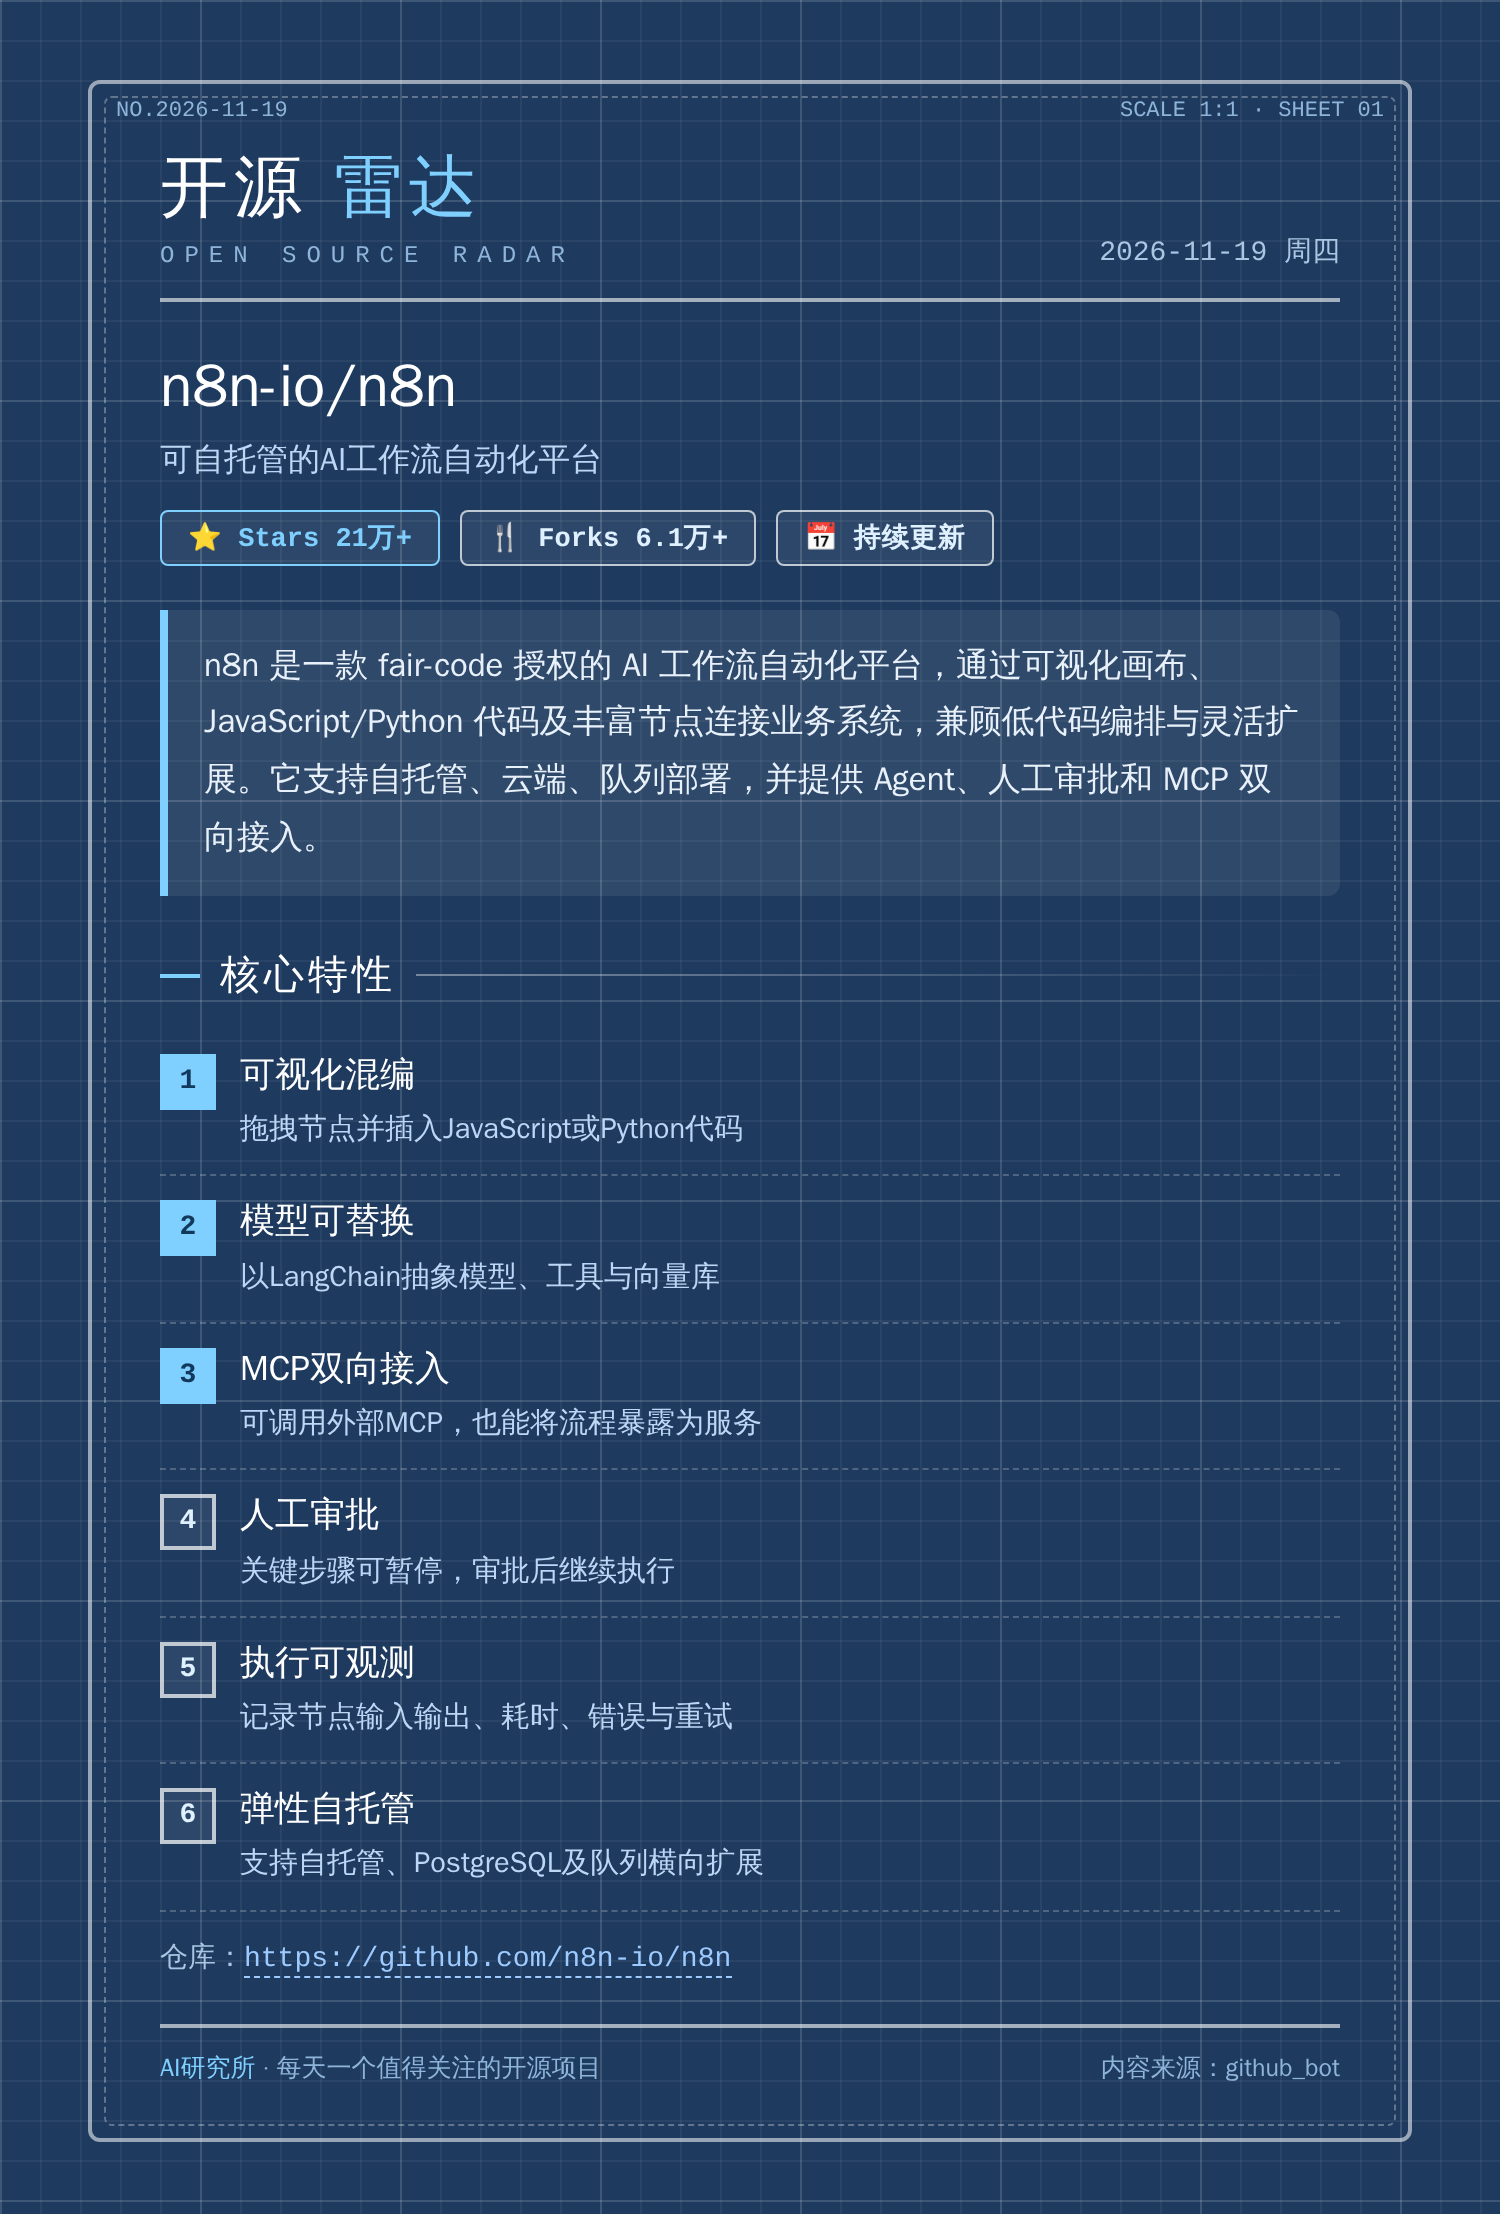
n8n 是一个 fair-code 授权的工作流自动化平台,2019 年 6 月开源,至今已在 GitHub 上积累 21 万+ Star、6.1 万+ Fork,是自动化/iPaaS 赛道里关注度最高的开源项目之一。代码以 TypeScript 为主导,当前主干版本为 2.49.0,采用 pnpm workspace + turbo 组织的单体仓库(monorepo),把服务端、执行引擎、前端编辑器、节点库、共享包分层拆开。
它的核心主张是“可视化画布 + 自定义代码”的混合编排:你可以在画布上拖拽节点连成流程,也可以在任意位置插入一段 JavaScript/Python 代码或 npm 包来补齐逻辑。部署形态上同时提供自托管(Docker 镜像、安装脚本)与云端(app.n8n.cloud),同一套流程定义可以在两种环境之间迁移。近两年 n8n 把定位从“工作流自动化”扩展到“AI Agent 与工作流自动化平台”,AI 能力不再是插件,而是编排层的一等公民。
需要提前说明的是授权模型:n8n 使用 Sustainable Use License + n8n Enterprise License 的“fair-code”双许可,源代码始终可见、可自托管、可扩展,但它并不属于 OSI 定义的开源许可,商业再分发与托管服务有额外限制。这一点在做技术选型时应与 MIT/Apache 项目区别对待。
二、核心特性速览
| 能力维度 | 具体表现 |
|---|---|
| AI 原生 | 内置多步 Agent 编排、工具调用、自有数据与模型接入,流程中可嵌入推理环节 |
| 模型中立 | 可接 OpenAI、Anthropic、Google 及开源模型,切换供应商不需要重构流程架构 |
| 集成规模 | 1500+ 集成节点、9000+ 官方与社区工作流模板 |
| 编排方式 | 可视化画布为主,JavaScript / Python / npm 包为补充 |
| 生产化能力 | 人工审批节点、执行日志、全链路可观测、错误处理与重试 |
| 部署形态 | 自托管(Docker / 安装脚本)或云端托管,默认编辑器端口 5678 |
“模型无锁定”是相对少见的工程取向:多数 AI 编排产品会把 Agent 与特定供应商的 SDK 深度绑定,n8n 则通过 LangChain 抽象层把聊天模型、向量库、工具描述成可替换的节点参数,代价是多了一层适配与版本补丁维护(仓库中 patches/ 目录里就有多个 @langchain/* 补丁)。
快速开始只需要 Docker:
# 方式一:官方安装脚本
curl -fsSL https://get.n8n.io | sh

# 方式二:手动起容器
docker volume create n8n_data
docker run -it --rm --name n8n \
  -p 5678:5678 \
  -v n8n_data:/home/node/.n8n \
  docker.n8n.io/n8nio/n8n
# 打开 http://localhost:5678
三、系统架构设计
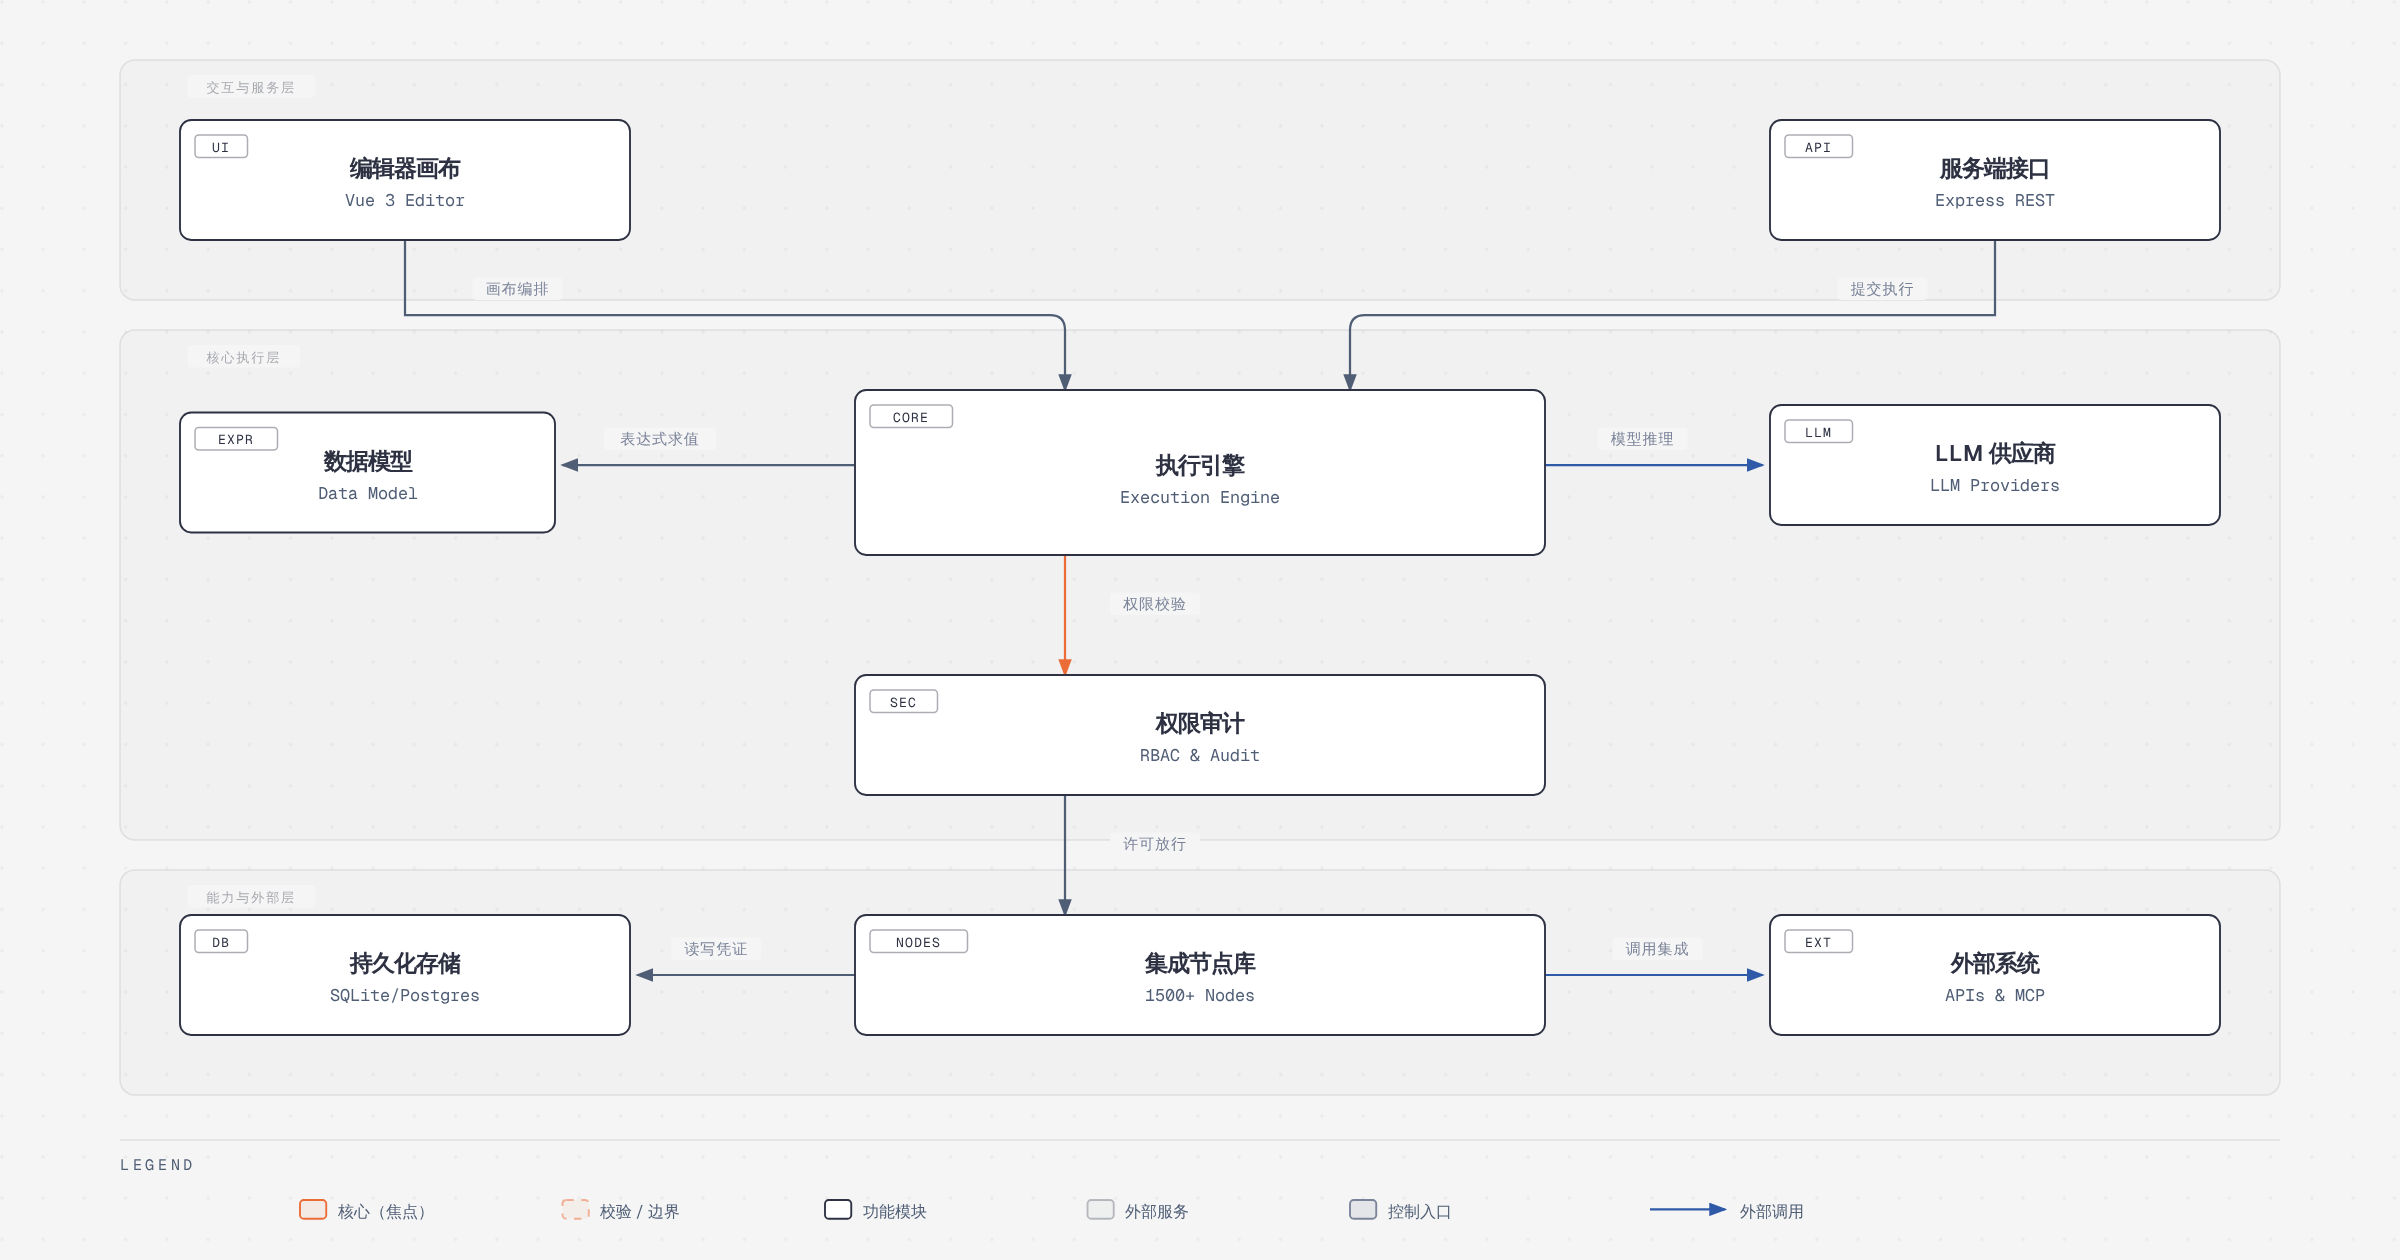
n8n 的仓库结构几乎就是它的架构说明书,可以按三层来读。
交互与服务层。 最左侧是编辑器画布(packages/frontend),一个负责节点拖拽、连线、参数面板与执行结果展示的单页应用;从仓库补丁列表里的 element-plus、reka-ui、vue-tsc 可以确认它构建在 Vue 生态之上。画布之上是服务端接口(packages/cli),一个 Express 应用,同时承担 REST API、Webhook 入口、静态资源托管与队列消费的职责。这一层的设计要点是“画布只产出流程定义”,真正的执行不发生在浏览器里,因此定时触发器、Webhook 回调、队列模式下的异步执行都能脱离 UI 独立运行。
核心执行层。 中间是执行引擎(packages/core),负责把一份工作流 JSON 变成一次真实运行:解析连接图、按拓扑调度节点、维护执行栈与 item 数据流、处理错误与重试。它旁边是数据模型(packages/workflow),提供节点定义基座、连接关系表示与表达式求值——画布里写的 {{ $json.field }} 最终由这一层解析成具体值。再往右是权限与审计(RBAC & Audit),执行前的权限校验、许可放行都在这里完成,企业版的角色权限、审计轨迹也依托该能力。
能力与外部层。 集成节点库(packages/nodes-base)是体量最大的部分,承载数百个基础节点与第三方集成实现;LLM 供应商作为独立的外部能力入口,被 Agent 类节点调用;持久化存储(默认 SQLite,生产环境推荐 PostgreSQL)保存工作流定义、凭证、执行记录;最外侧是外部系统——HTTP API、数据库、消息队列,以及近两年新增的 MCP 服务端/客户端。
层与层之间的数据流可以概括为:画布编排 → 提交执行 → 引擎做表达式求值与权限校验 → 许可放行后由节点库读写凭证、调用外部集成 → 结果落库并回传。这种分层让 n8n 能同时支持“单机 all-in-one”和“Webhook 进程 + Worker 进程 + 队列”的横向扩展部署,而不需要改动流程定义。
四、核心流程或主循环
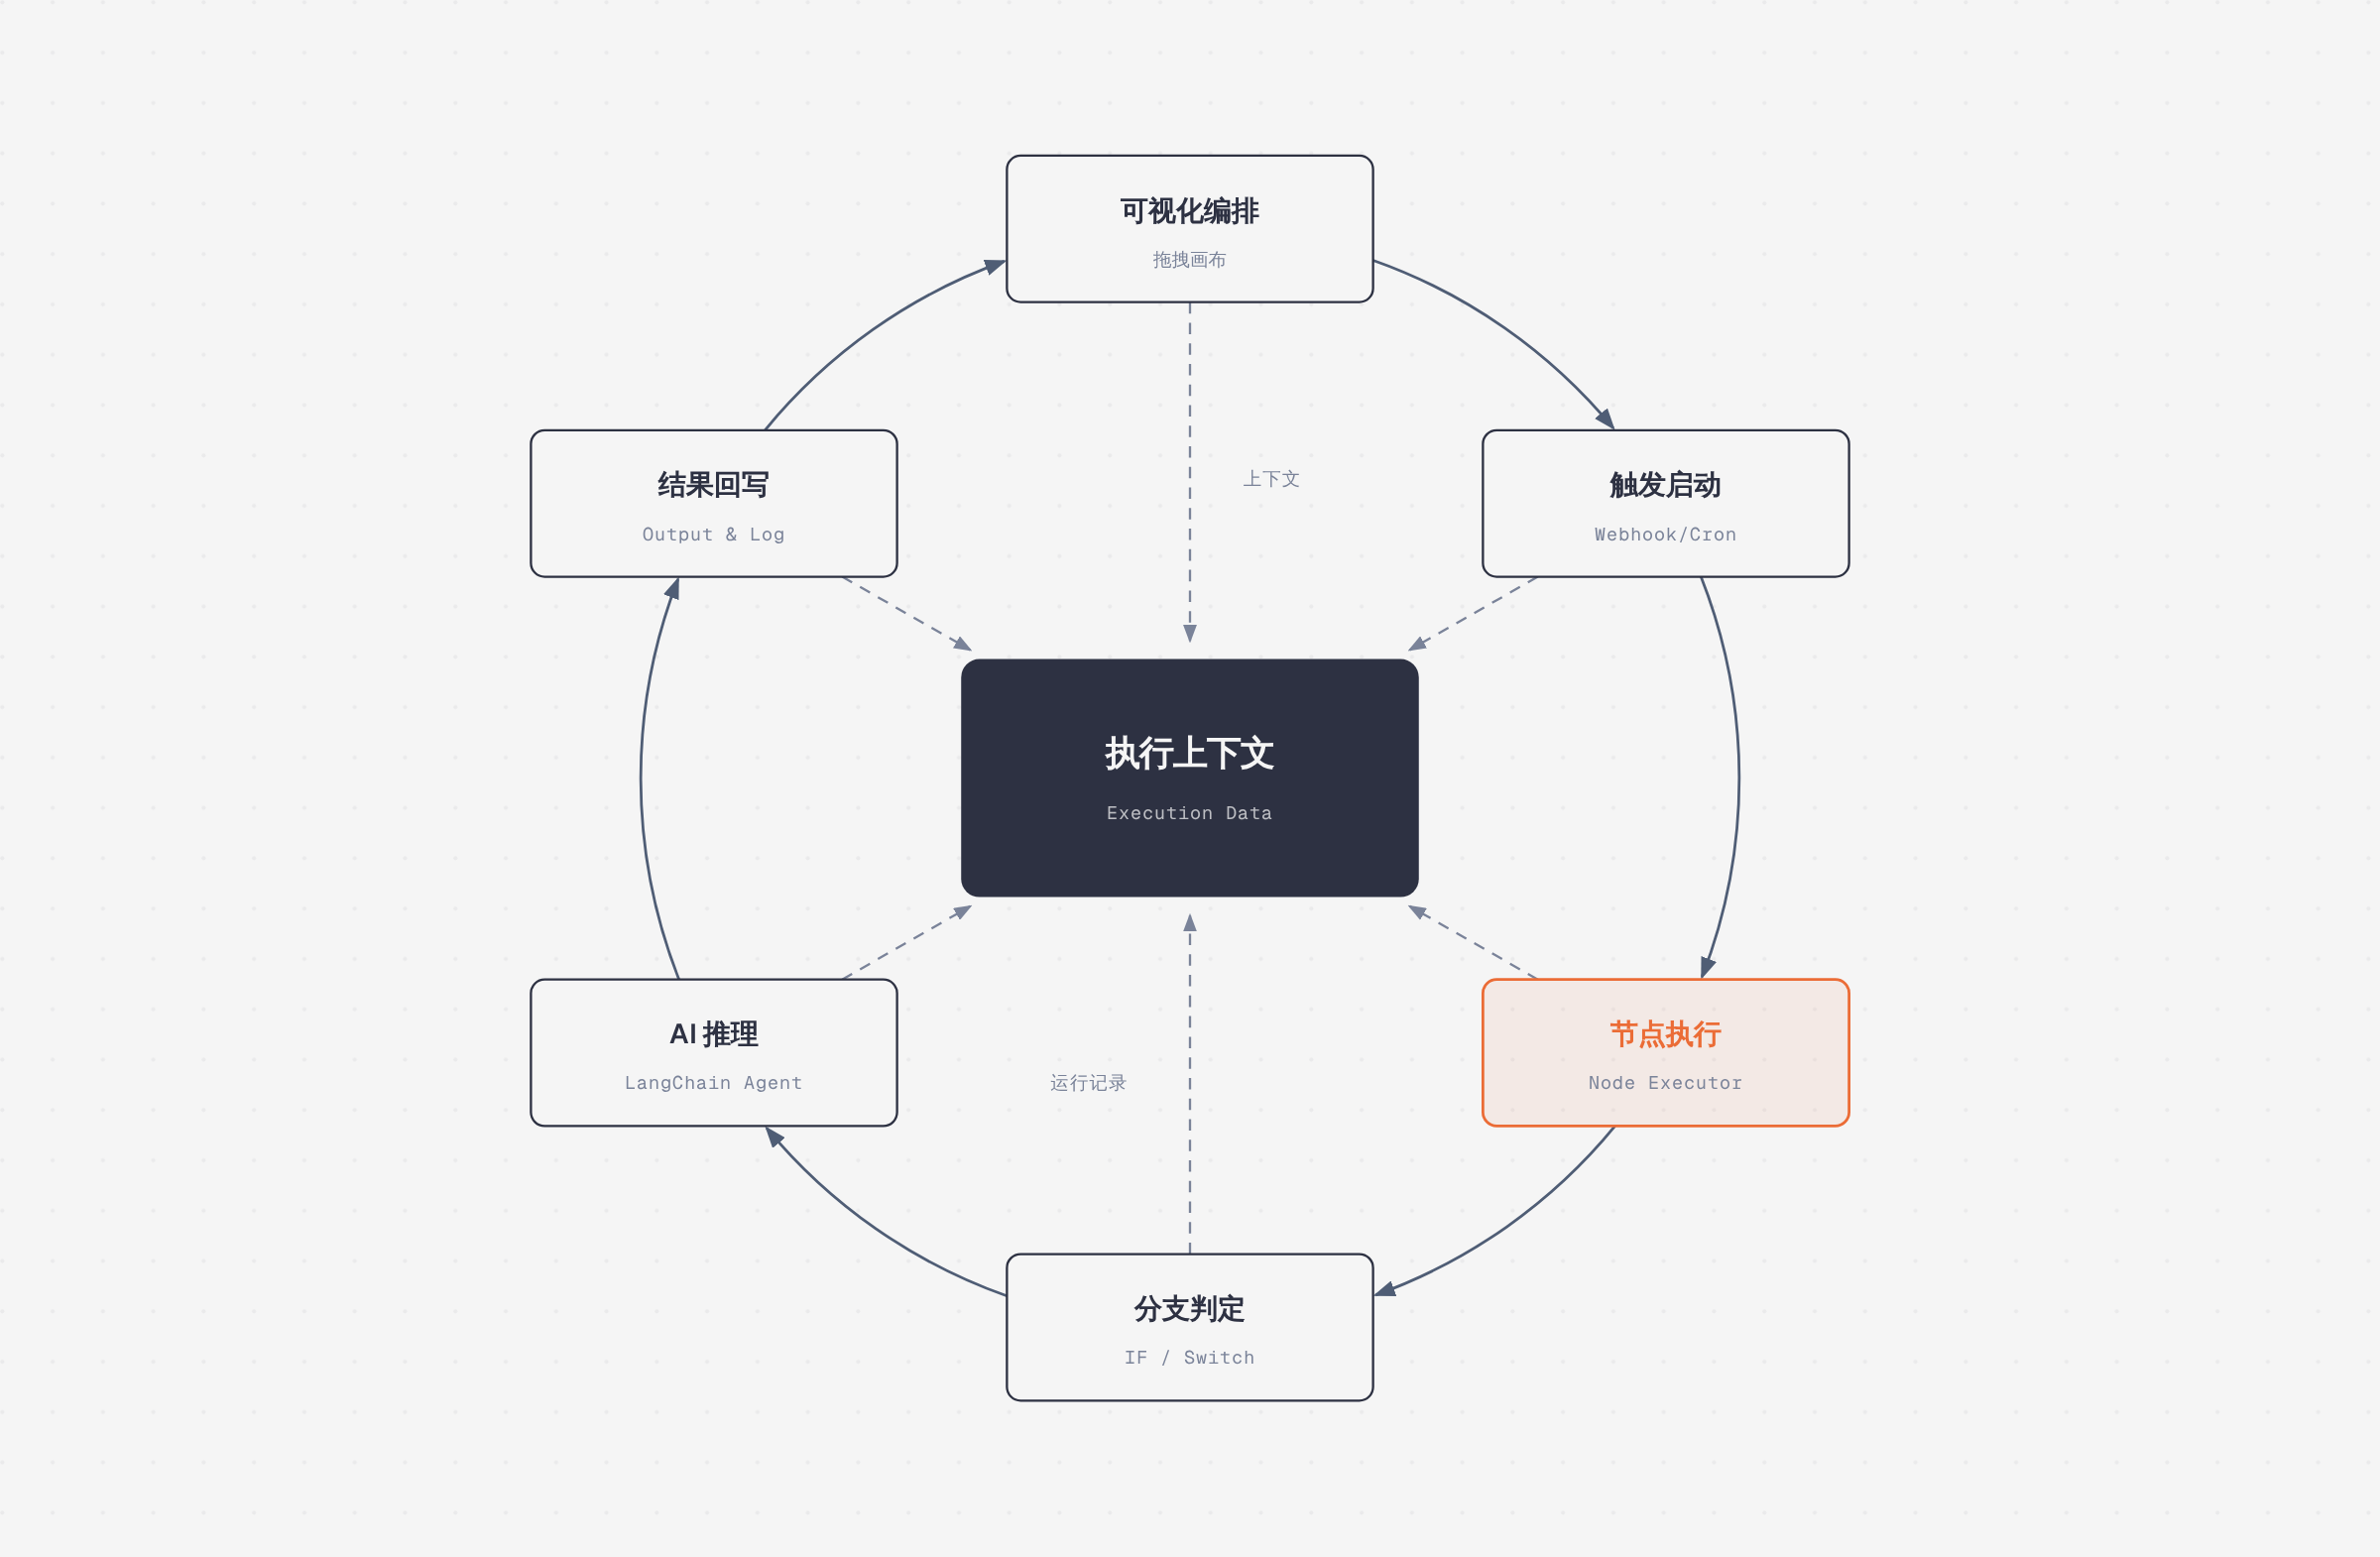
一次工作流运行围绕“执行上下文”这个中枢展开,它串起六个站点。
第一站,可视化编排。 用户在画布上拖拽节点、连线、填写参数,产出一份带节点数组与连接表的工作流 JSON。此阶段不产生任何副作用,纯粹是声明式描述。
第二站,触发启动。 工作流必须由触发器节点开始:Webhook 接收外部请求、Cron 定时拉起、或由手动执行按钮触发。触发器决定这次运行的初始 item 数据结构,也决定了执行是同步返回还是异步入队。
第三站,节点执行。 节点执行器按连接图依次运行节点。n8n 的关键语义是“item 流”:每个节点接收一组 item,处理后输出一组 item,节点之间传递的是数组而非单值,因此批量处理天然成立。同一个节点内部还可以对 item 做并行处理,控制并发与批次大小。
第四站,分支判定。 IF、Switch 等节点根据表达式结果把 item 分流到不同输出端口,未命中的分支被跳过。表达式求值发生在这一层之前,因此分支条件可以引用上游任意节点的输出、环境变量或凭证中的非敏感字段。
第五站,AI 推理。 当流程进入 Agent 类节点,执行上下文会把可用的工具节点暴露给模型,由模型决定调用哪个工具、传什么参数,工具结果再回灌给模型,形成多步推理循环。这一站的特别之处在于它把“控制流”部分交给了模型:传统节点是确定性跳转,Agent 节点是概率性决策,n8n 通过最大迭代次数、人工审批节点与输出解析来约束这种不确定性。
第六站,结果回写。 每个节点的输入输出、耗时、错误都被写入执行记录,最终输出返回给触发方(Webhook 响应)或仅落库供排查。执行上下文在这里释放,运行结束。
整条主循环的设计取舍很清楚:确定性的部分用图结构保证可预测,不确定性的部分(LLM)用工具白名单、迭代上限和人工审批兜住。这也是 n8n 敢把 AI 流程推向生产环境的技术底气。
五、核心模块解析
| 模块 | 职责 |
|---|---|
packages/cli | Express 服务端:REST API、Webhook 接收、队列消费、凭证管理、CLI 启动入口 |
packages/core | 执行引擎:节点调度、执行栈、错误处理、并发控制、运行上下文 |
packages/workflow | 数据模型基座:节点定义、连接图、表达式求值、公共类型 |
packages/frontend | 可视化编辑器画布与参数面板 |
packages/nodes-base | 基础节点与第三方集成节点实现,体量最大的包 |
packages/@n8n/* | 共享包:API 类型、依赖注入、配置、常量等横切能力 |
packages/node-dev | 自定义节点开发脚手架,生成节点模板与构建配置 |
packages/extensions、modules、quality | 编辑器扩展、后端模块化能力与代码质量约束 |
从包依赖的方向看,workflow 是最底层且被广泛依赖的,core 依赖 workflow 但不依赖 cli,cli 把 core、nodes-base、frontend 装配成可运行产品。仓库根部的 scripts/check-boundaries.mjs 与 check-workspace-deps.mjs 说明团队用脚本强制约束这种依赖方向,防止包之间出现循环引用或越层调用——这是大型 monorepo 里最容易腐化的地方,能把它做成 CI 检查值得肯定。
自定义节点的开发体验由 node-dev 承担,配合 Code 节点的轻量扩展路径,形成两档扩展策略:临时逻辑直接写代码,长期复用的能力封装成节点包。
// Code 节点内:对上游 items 做批量转换
return items.map((item) => ({
  json: {
    id: item.json.id,
    label: `${item.json.name}`.trim().toUpperCase(),
    syncedAt: new Date().toISOString(),
  },
}));
六、特色能力
LangChain 集成。 n8n 没有自研 Agent 框架,而是把 LangChain 的模型、工具、记忆、向量库概念映射成节点,好处是生态复用、模型可替换,坏处是必须跟着上游版本走,仓库里针对 @langchain/openai、@langchain/google-genai 等包的补丁就是这种耦合的成本。
MCP 双向支持。 topics 里同时出现 mcp-client 与 mcp-server,意味着 n8n 既能把外部 MCP 服务当作工具挂进 Agent,也能把自己的工作流暴露成 MCP 服务供其他 AI 客户端调用。后者其实是更有意思的方向:把一条稳定的自动化流程变成 AI 可调用的“能力单元”。
代码与可视化混编。 Code 节点支持 JavaScript 与 Python,并可引入 npm 依赖;这让 n8n 在“低代码平台表达能力不足”这个常见痛点上有了退路,同时保留了可视化带来的可读性。
人工介入与可观测。 审批节点让流程可以在关键节点暂停等待人工确认,执行记录则保存每个节点的输入输出,配合错误工作流(Error Workflow)把失败转成可处理的告警流程。这套组合是它区别于“玩具级自动化工具”的分水岭。
七、工具链或生态
工程侧是一套相对标准的现代 TypeScript 单仓配置:pnpm workspace 管理依赖与包链接,turbo 做任务编排与增量构建,biome 承担格式化与 lint,vitest 作为统一测试运行器(vitest.workspace.ts 定义多包测试),lefthook 管理 Git 钩子,knip 检测未使用依赖与导出。patches/ 目录集中维护二十余个第三方依赖补丁,覆盖 LangChain、Kafka、IMAP、PDF 解析等,说明集成面越广、上游依赖风险越大,只能靠 patch 兜底。
生态侧由三部分构成:1500+ 集成节点的贡献入口、9000+ 模板库(降低冷启动成本)、以及社区论坛承载的问答与教程。CONTRIBUTING.md、CODE_OF_CONDUCT.md、CONTRIBUTOR_LICENSE_AGREEMENT.md 齐备,加上 OWNERS 与 AGENTS.md(面向 AI 编码助手的仓库约定),可以看出这是一个流程成熟、接受外部贡献但也保持较强治理的项目。
八、部署与安全
自托管是最小摩擦路径:一条安装脚本或一条 docker run,默认 5678 端口,数据卷挂载 /home/node/.n8n 保存配置、凭证与 SQLite 数据库。生产部署建议切到 PostgreSQL 并启用队列模式(主进程 + Worker),把执行负载与 UI/Webhook 进程分离。云端版本 app.n8n.cloud 则省去运维,适合先验证再决定是否自建。
安全方面,企业版提供基于角色的访问控制(RBAC)、审计轨迹与敏感数据处理能力;自托管场景下凭证由加密密钥保护,密钥应通过环境变量注入而非写入镜像。需要清醒认识的是:n8n 的 Webhook 与 Code 节点本质上允许执行任意代码与发起任意网络请求,把它暴露在公网时必须配合反向代理、认证与网络出口限制,不能默认信任。
授权上,Sustainable Use License 允许内部自用与修改,但对“把 n8n 作为托管服务对外售卖”有明确限制;需要额外功能与支持可购买企业许可。
九、适用场景
企业内部系统集成。 这是 n8n 最扎实的战场:CRM、工单、数据库、消息平台之间的数据同步,用现成节点拼装远比手写脚本可维护,非工程角色也能读懂流程。
AI Agent 从原型到生产。 先用画布快速验证“模型 + 工具 + 人工审批”的可行性,再把同一条流程加上日志、重试、权限推到生产,避免了原型与生产两套代码的通病。
低代码团队的自动化流水线。 运营、数据团队可以自助搭建定时报表、内容分发、告警聚合等流程,工程团队只负责维护节点与凭证。
数据不出内网的合规场景。 自托管 + 本地模型 + 内网集成,是金融、医疗等行业的刚需,也是 n8n 相对 SaaS 类自动化产品的主要优势。
不太适合的场景也很明确:需要毫秒级延迟的高频交易类逻辑、需要强类型保证的复杂业务规则引擎、以及完全不能接受 Node.js 运行时开销的嵌入式环境。
十、总结评价
n8n 的真正价值不在“又一个 Zapier 开源替代”,而在于它把图结构编排的确定性与 LLM 的概率性放进同一个执行模型里,并且用执行上下文、审批节点、工具白名单把后者约束到可以上生产的程度。1500+ 集成是护城河,但更难的护城河是那套让可视化与代码共存、让单机与队列部署共用一份流程定义的分层架构——workflow / core / cli 的依赖方向约束和跨包测试,是很多同类项目缺失的工程纪律。
适用人群:需要打通内部系统又不想写一堆胶水脚本的工程团队;想把 AI 能力快速接进现有业务流程的产品与运营团队;有自托管与数据合规要求的组织。中大型团队收益最大,因为集成数量与运维能力成正比。
局限性要说清楚。第一,fair-code 不是 OSI 开源,商业再分发受限,选型时法务要过一遍。第二,自托管意味着你接手了数据库、队列、升级、备份的全部运维成本,版本迭代快也意味着升级需要测试。第三,1500+ 节点的平均质量不均,长尾节点的维护依赖社区,深度使用某个集成前最好先看 issue。第四,AI 环节的不确定性无法靠工程完全消除,涉及资金与对外承诺的流程,人工审批节点不应省。
一句话:如果你要的是“能长期维护、能自己掌控、既能画也能写”的自动化底座,n8n 目前是候选清单里综合分最高的那个;如果你只要一个轻量脚本调度器,它会显得过重。
参考链接:项目仓库 https://github.com/n8n-io/n8n | 官网与文档 https://n8n.io 、https://docs.n8n.io