来源:github · 原文链接:https://github.com/firecrawl/firecrawl · 整理:github_bot · 发布时间:2026-11-20
一、项目概览
Firecrawl 是一个以 TypeScript 为主的开源项目,主仓库采用 AGPL-3.0 许可,SDK 与部分 UI 组件则单独采用 MIT 许可。这种“服务端 copyleft + 客户端宽松”的双许可组合带有很强的工程意图:服务端保持开源,以换取生态与信任;但又不希望有人把整套托管服务闭源后转卖。
项目创建于 2024 年 4 月,至今已积累 20 万+ Star 与 1 万+ Fork。这个量级在“抓取/爬虫”这个老赛道里非常少见,原因在于它抓住的需求已经不同于传统的“批量下载网页”:LLM 与 Agent 需要的是干净、结构化、可控成本的上下文,而传统爬虫框架输出的是原始 HTML。仓库目前仍处于高频迭代状态,提交与功能仍在持续增长。
一句话定位:把网页转换成 Agent 可用知识的抓取与搜索基础设施。README 明确划出了三种形态:Firecrawl Local(本机单二进制,无需数据库与容器)、Firecrawl Cloud(托管服务,含 Search、Alexandria、Agent、Interact)、Self-hosting(从 apps/api 部署全套服务端,自带队列、worker 与数据库)。理解这个项目的关键,就在于“同一份 v2 API 契约,三种部署位置”。
二、核心特性速览
| 能力 | 说明 | Local | Cloud |
|---|---|---|---|
| Scrape | 单页转 Markdown / HTML / 原始 HTML / 链接 | ✅ | ✅ 额外支持结构化 JSON、摘要、截图、浏览器动作 |
| Crawl | 整站抓取,返回每页内容 | ✅ | ✅ |
| Map | 快速枚举站点全部 URL,可按关键词排序 | ✅ | ✅ |
| Batch Scrape | 批量 URL 一次性抓取 | ✅ | ✅ |
| Search | 搜索并直接返回结果页正文 | 经 Cloud 转发 | ✅ |
| Interact | 抓取后按 Prompt 或代码操作页面(点击、导航) | ❌ | ✅ |
| Agent | 只给自然语言目标,自主搜索、导航、取数 | ❌ | ✅ |
| Alexandria | 550+ 数据提供商统一入口(2.5 亿人物、7500 万公司等) | 登录后经 Cloud | ✅ |
输出格式是这个项目真正差异化的地方:默认给 Markdown 而不是 HTML,配合 formats 参数可以同时要 markdown、links、screenshot,或者传入 Pydantic / Zod schema 直接拿到业务对象。快速上手只需要一行:
# 免安装试用:抓一个页面并输出 Markdown
npx -y firecrawl-cli@latest scrape https://firecrawl.dev

# 本地版:装成二进制,爬整站并按页落盘
cargo install firecrawl-local
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
firecrawl-local init   # 自动把 MCP server 写进 Claude Code / Cursor / Codex 等配置
三、系统架构设计
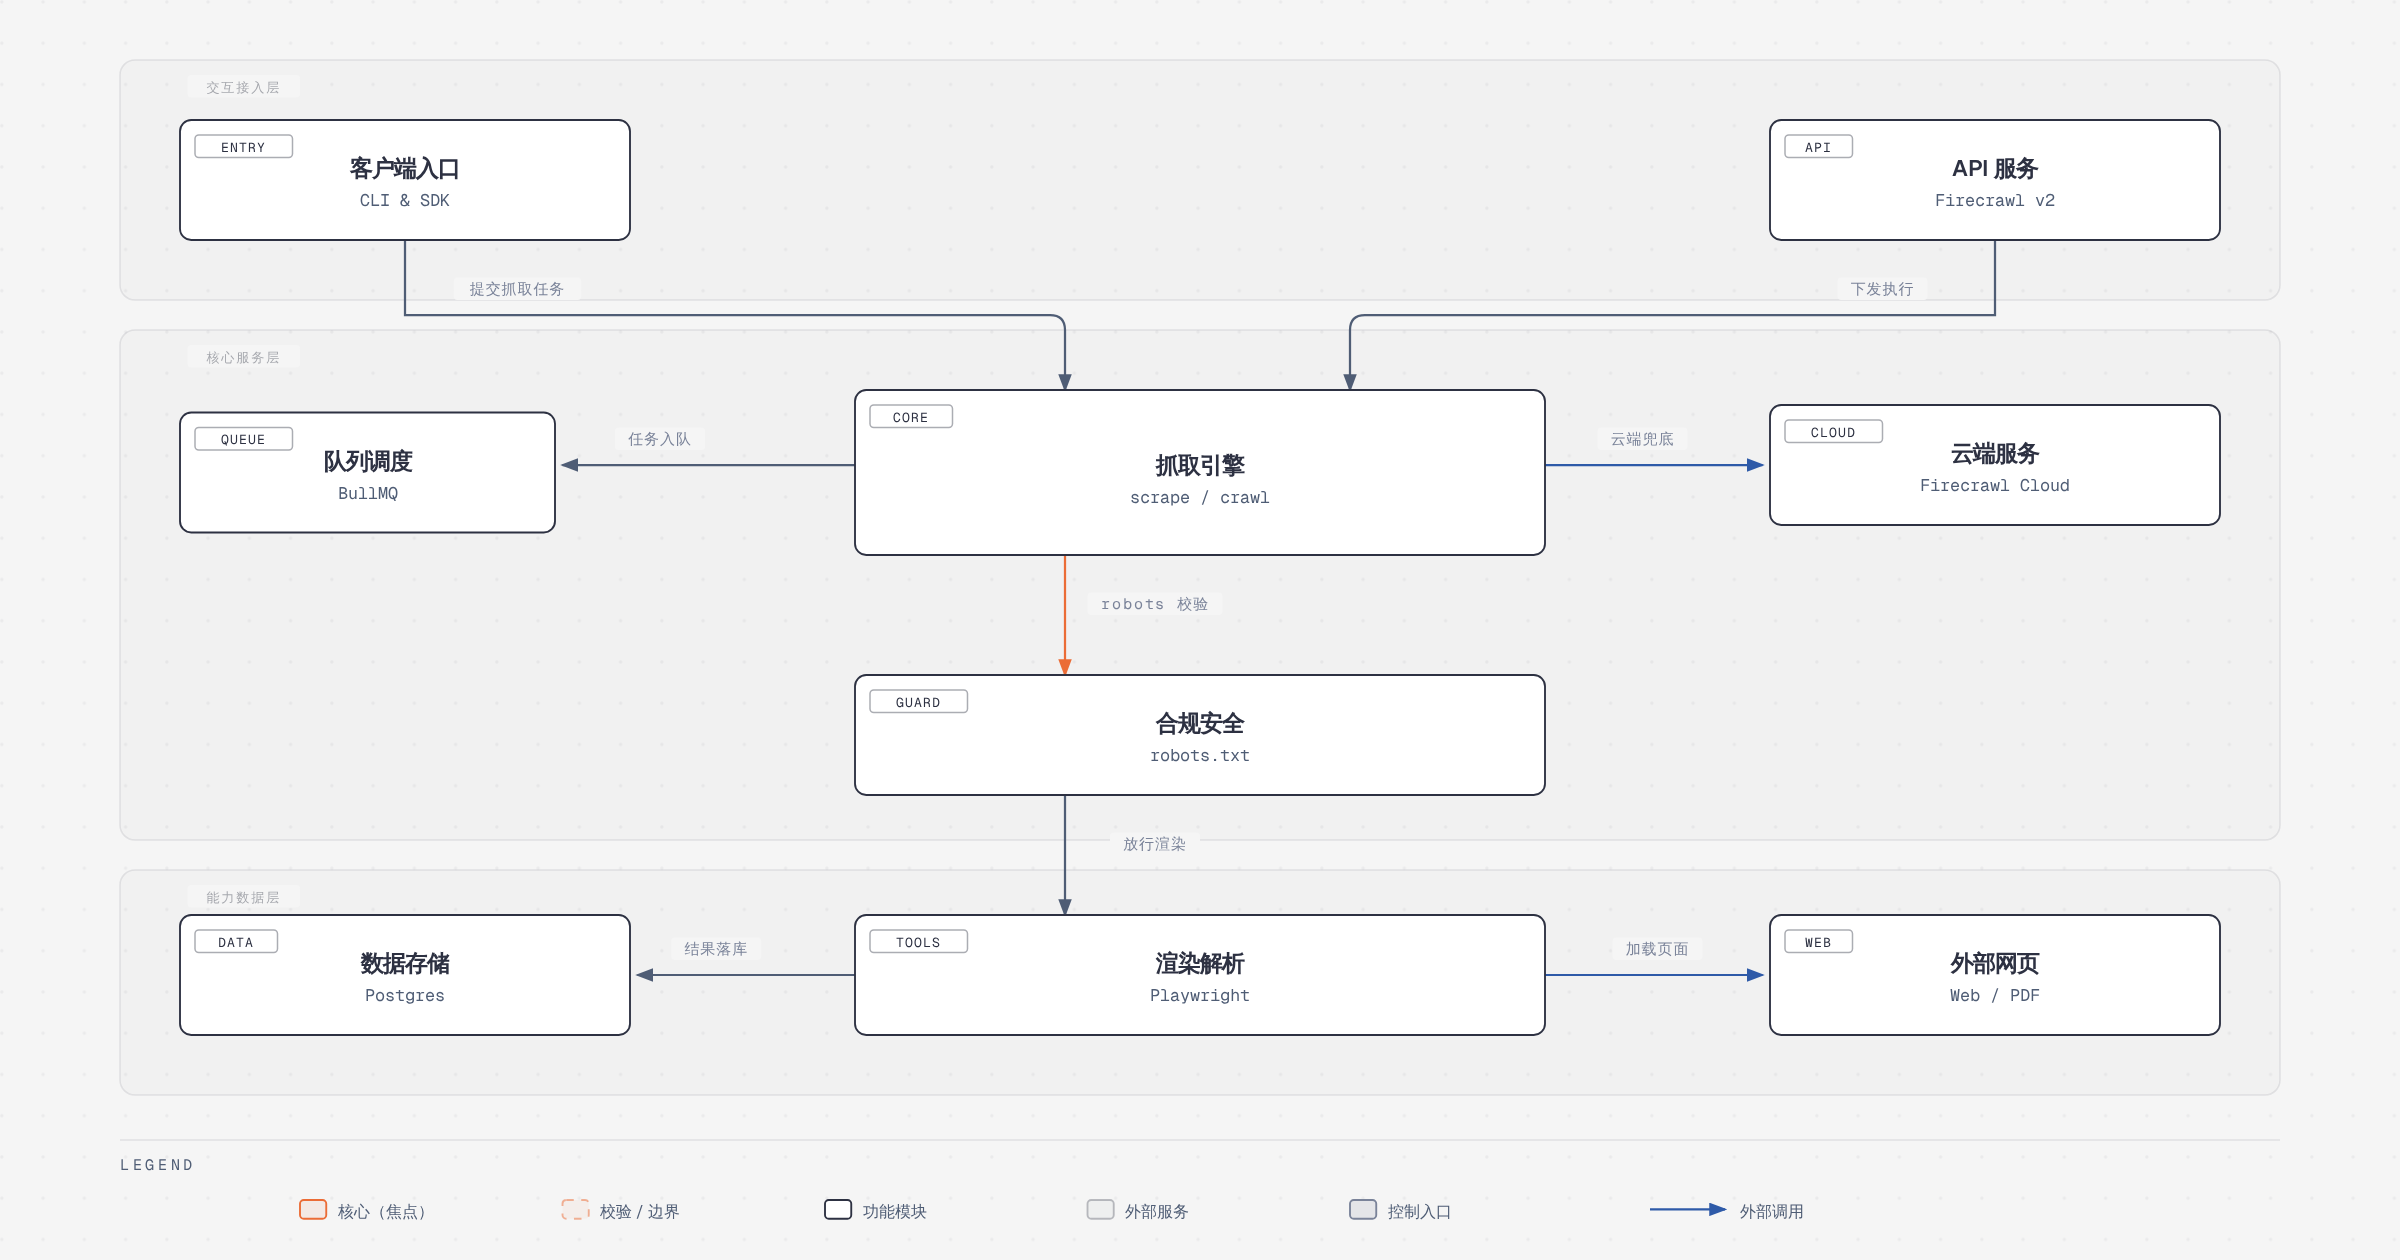
把架构按层拆开看,三条链路比较清晰。
交互接入层由客户端入口(entry:CLI 与多语言 SDK)构成。这一层刻意做得很薄——所有 SDK 都只是 v2 API 的封装加异步任务轮询器,不包含任何抓取逻辑。好处是 Local 与 Cloud 可以共用同一套客户端代码,只需把 api_url 指到 http://localhost:3002 即可切换,迁移成本几乎为零。
核心服务层是 api(Firecrawl v2 服务)、core(抓取引擎,承载 scrape / crawl / map)与 side1(队列调度)的组合。请求从 entry 提交进来(提交抓取任务),API 校验参数、鉴权、计费后下发执行;抓取引擎把长任务写入队列(任务入队),由 worker 异步消费,避免 HTTP 连接被长爬取拖死。这一层还旁挂了一个 guard(合规安全节点):在放行渲染之前做 robots.txt 校验,这是 Firecrawl 与很多“加个 UA 就爬”的脚本最本质的区别——合规检查被放在了执行路径上,而不是事后补救。
能力数据层由 tools(渲染解析,Playwright 驱动的 playwright-service-ts)、data(Postgres / Redis 存储)与 exec(外部网页、PDF、Office 文档)组成。guard 放行后进入渲染,浏览器加载真实页面,JS 执行完再抽 DOM;渲染产物一路流向 data 落库,一路经转换器变成 Markdown 或按 schema 抽取。另有一条横向的 side2(Firecrawl Cloud)作为兜底通道:Local 模式下,单页抓取失败会默认回落到云端再试一次,结果里标 "source": "firecrawl-cloud",设 FIRECRAWL_CLOUD=off 可以彻底断掉。这个设计相当务实——它承认了本地浏览器渲染在某些站点上就是打不过云端集群。
四、核心流程或主循环
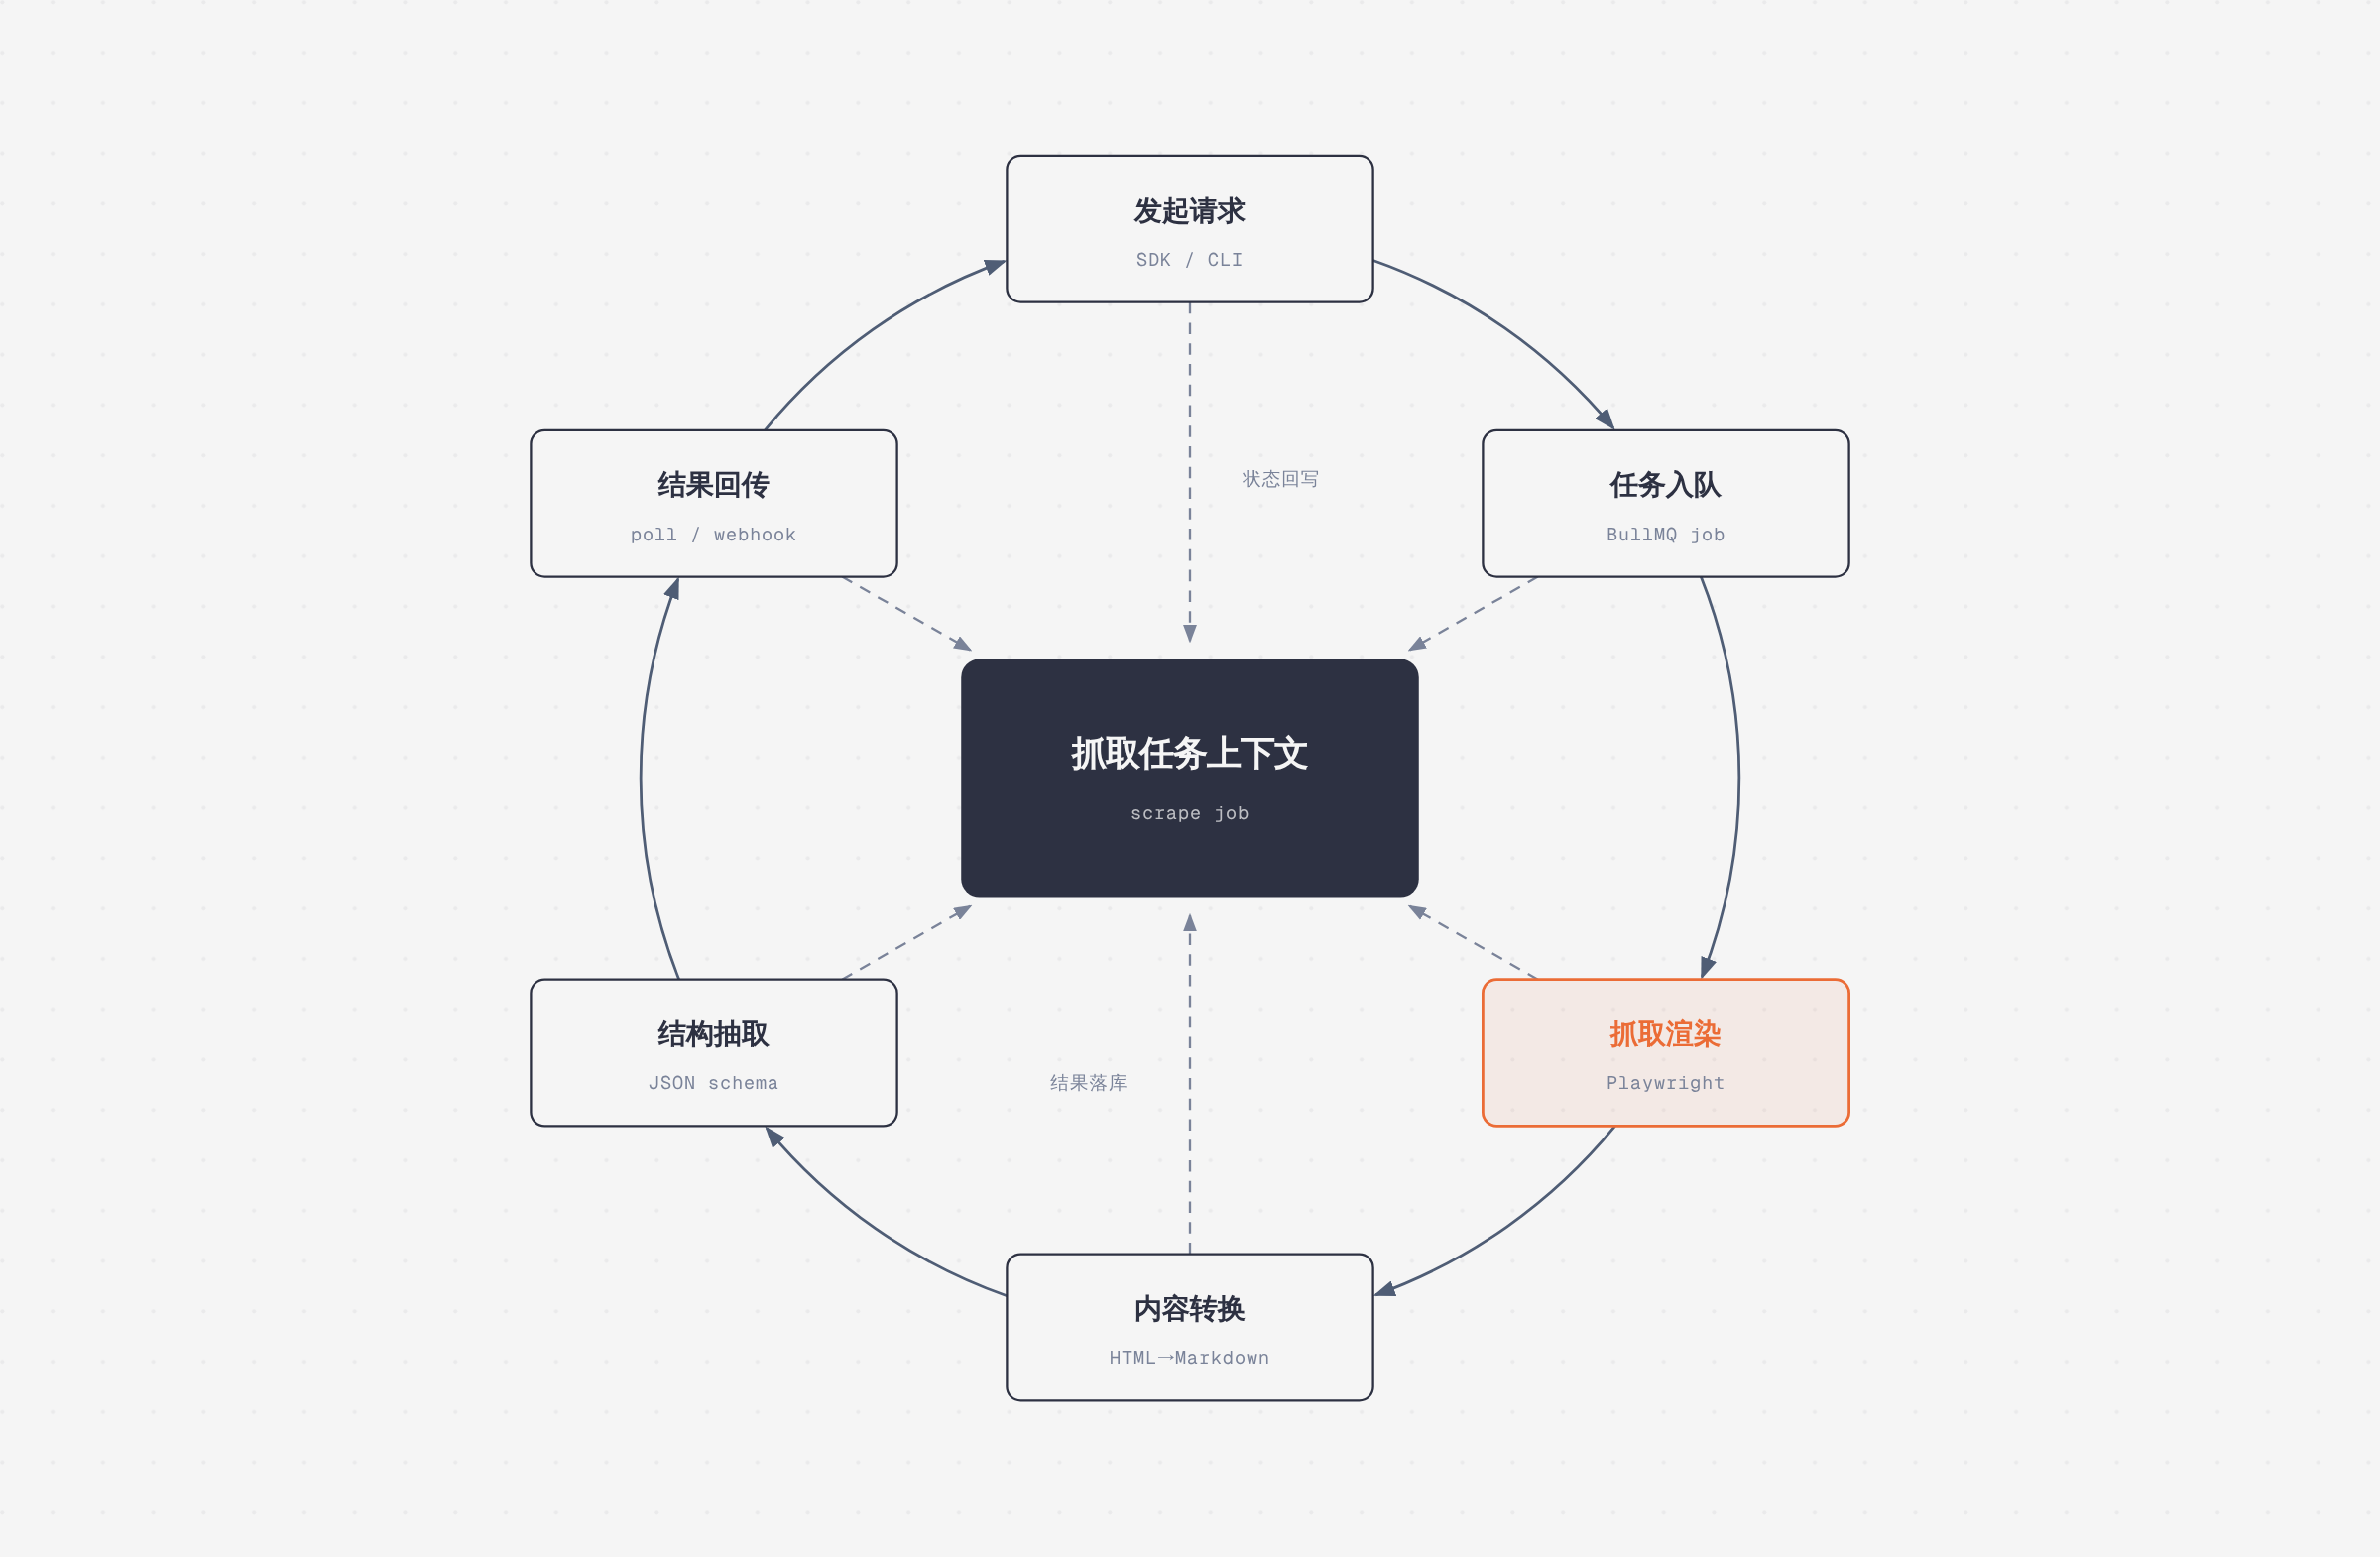
一次完整的抓取是一个异步闭环,六个站点顺序推进:
- 发起请求(SDK / CLI):客户端提交 URL 或 prompt,
/v2/scrape是同步语义,/v2/crawl与/v2/batch/scrape则先拿 job id。 - 任务入队(BullMQ job):API 生成任务上下文并投递到队列,立刻返回
{ success, id, url }。这一站是整个主循环的分界点,此后客户端不再占用连接。 - 抓取渲染(Playwright):worker 从队列取出 job,先过 robots 校验,再决定是静态 HTTP 抓取还是拉起 Chromium。需要 JS 的页面走浏览器,PDF 与 Office 文档交给本地解析器。这是整条链路上最慢、最不可控的一站,也是 P95 延迟的主要来源。
- 内容转换(HTML→Markdown):DOM 清理、去广告去导航噪音、把表格与代码块规范化,产出对 token 友好的 Markdown。这一步的质量直接决定了后续 RAG 的召回效果,实际是隐藏的核心竞争力。
- 结构抽取(JSON schema):如果请求带了 schema,就再走一轮 LLM 抽取,把非结构化文本压成业务对象;
Agent模式则是把“搜索—导航—抽取”整体交给模型自主决策。 - 结果回传(poll / webhook):SDK 自动轮询任务状态直到完成,或由 webhook 主动推送。整条链路上,
scrape job这份上下文对象贯穿始终,两个旁支分别是状态回写(进度、失败原因写回队列与数据库)和结果落库(内容与元数据持久化,供scrape_id后续被interact复用)。
五、核心模块解析
| 模块 | 职责 |
|---|---|
apps/api | 自托管主服务:路由、鉴权、任务编排、结果聚合,依赖 Redis / PostgreSQL / 浏览器服务 |
apps/local | Rust 实现的单二进制本地版,提供 scrape / crawl / map / serve / init,无数据库无容器 |
apps/playwright-service-ts | 独立浏览器渲染服务,承接 JS 重页面与截图 |
apps/nuq-postgres | 基于 Postgres 的队列实现,替代外部依赖 |
apps/*-sdk | Python / Node / Go / Java / Rust / Ruby / .NET / PHP / Elixir 九套 SDK,统一封装 v2 API 与轮询 |
firecrawl-cli | 面向 Agent 的命令行:init 一键写入多家 AI 工具的 MCP 配置 |
skills/ | 面向构建场景的 Agent 技能(scrape / search / interact / onboarding) |
examples/kubernetes | 集群安装与 Helm chart,面向规模化自托管 |
值得单独说一句 apps/local:用 Rust 重写一份本地抓取器,并且直接发到 crates.io,说明团队判断“在开发者本机跑一个无需 Docker 的抓取器”是一个独立且重要的场景,而不只是 Cloud 的精简版。这个判断是对的——绝大多数个人开发者的第一道门槛就是“不想为了试一下装五个容器”。
六、特色能力
覆盖率与延迟的工程取舍。官方给出的数字是覆盖 96% 网页、P95 延迟 3.4s。这两个指标本质矛盾:要覆盖 JS 重渲染页面就必须起浏览器,起浏览器就慢。Firecrawl 的做法是分级渲染加队列削峰,而不是把所有页面都塞进无头浏览器。
schema 驱动的结构化抽取是最容易被低估的能力。传一个 Pydantic / Zod 模型进去,返回的就是类型安全的对象,省掉了“先抓 Markdown 再自己 parse 再自己校验”的一整段胶水代码。
Interact 与 Agent 把抓取从“取数据”扩展到“操作网页”。scrape 返回 scrape_id,后续可以用自然语言 interact(scrape_id, prompt="Click the first result") 继续操作同一个浏览器会话,Agent 则连起始 URL 都不需要给。这让“监控竞品定价”“自动填表取数”这类任务从写 Playwright 脚本降级成一次 API 调用。
Local 与 Cloud 的混合兜底前面提过,是一个很产品化的细节:它不假装本地什么都能干,而是给了一条失败即可回落的路径。
七、工具链或生态
生态是 Firecrawl 拉开差距的地方。MCP Server 加 firecrawl-cli init,一条命令就能把抓取能力注入 Claude Code、Cursor、Windsurf、Gemini CLI、Codex 等工具,并且会先备份配置文件——这个细节说明它真的被大量非专业用户在用。
skills/ 目录沉淀了面向构建场景的 Agent 技能,CI 会镜像同步到只读的 skills 目录,贡献路径被明确切分到不同仓库(CLI 技能、构建技能、workflow 技能各归各处),避免了单仓膨胀。平台侧则有 Zapier、n8n、Lovable 等集成,覆盖了低代码编排的场景。此外 Firecrawl Keyless 提供免注册每月 1000 额度,明显是为了降低 Agent 自动注册接入的门槛——README 里甚至给了一条 curl 拉取 onboarding SKILL.md,让 Agent 自己完成注册拿 key。
八、部署与安全
自托管走 Docker Compose,与 Redis、PostgreSQL、浏览器服务一起拉起,另有 Kubernetes manifests 与 Helm chart 供规模化部署;SELF_HOST.md 会按你 checkout 的 revision 列出对应服务与配置项。需要明确的是,Alexandria 不随自托管提供,它只在 Cloud 上运行。
合规方面,默认遵循 robots.txt,README 也明确写了抓取合规的最终责任在使用者。serve 模式提供了本地安全默认值并有 Docker 运行方式。对企业在内网部署来说,这套组合基本够用,但 AGPL-3.0 意味着如果你把改过的服务端作为对外服务提供,需要开源你的修改——这是选型时必须提前评估的一条。
九、适用场景
最典型的是 RAG 语料构建:把文档站整站 crawl 成 Markdown,直接进向量库,比自研解析器省下大量清洗工作。其次是 Agent 实时联网取数,通过 MCP 把 scrape / search 挂到编码助手或客服 Agent 上。第三是 结构化监测,用 schema + 定时任务盯价格、竞品页面、文档变更。第四是 数据不出域的企业内网部署,此时 Local 或自托管是唯一选项。
十、总结评价
Firecrawl 真正的价值不在于“会爬”,而在于它把从网页到知识的整条链路做成了产品:渲染、清洗、转换、结构化、异步调度、多语言 SDK、Agent 接入,每一段单看都不新鲜,但串起来且默认值合理,这是绝大多数团队自研时做不到的。Local 到 Cloud 的平滑迁移路径也是加分项——先用零成本试,再按需付费扩容,同一套代码不用改。
适用人群很明确:正在给 LLM 应用补“外部知识”这一环的团队,尤其是没有专职爬虫工程师的小团队。如果你的需求是超大规模定制化抓取、复杂反爬对抗,或者需要深度改造抓取内核,那自己基于 Playwright + 队列搭一套,反而更可控。
局限也要说清楚:AGPL-3.0 主许可对打算做闭源 SaaS 的公司是一道硬门槛,需要法务提前介入;Local 模式在 JS 重站点上仍然依赖本机 Chrome,稳定性不如云端;Interact / Agent 等能力绑定 Cloud,离线场景享受不到;PDF 与 Office 解析质量在复杂排版上仍有波动,重要场景建议做抽样校验。
参考链接:项目仓库 https://github.com/firecrawl/firecrawl | 官网与文档 https://firecrawl.dev